| Révisions TSSR !!! |
 |
Bonne lecture !!!
Révisions :
https://cisco.ofppt.info/ccna1/
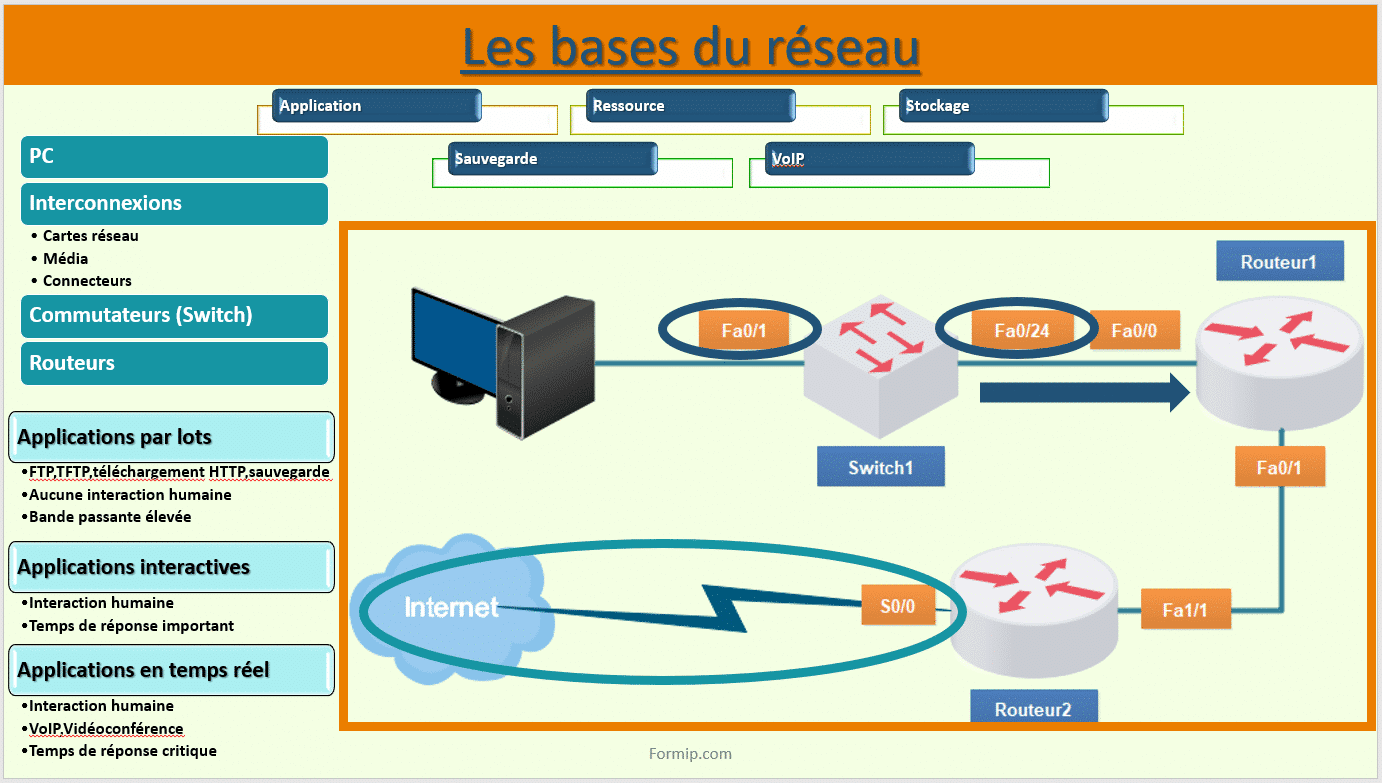
- Les différentes topologies réseau (base réseau)
-
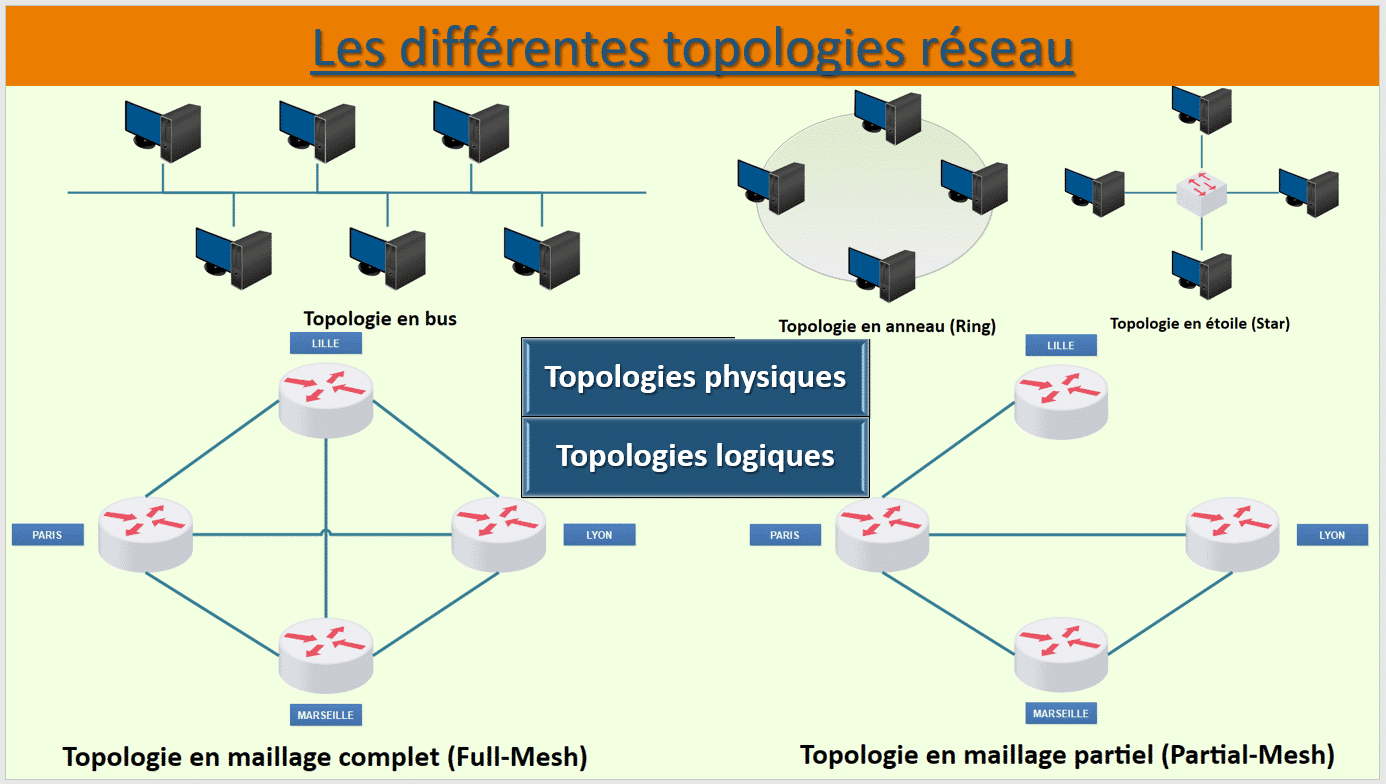
- Topologies en bus
La topologie en bus est basée sur des câbles coaxiaux, où un seul câble long relie chaque appareil. À la fin du câble, vous deviez placer un terminateur. Si le câble se brisait, le réseau était en panne.
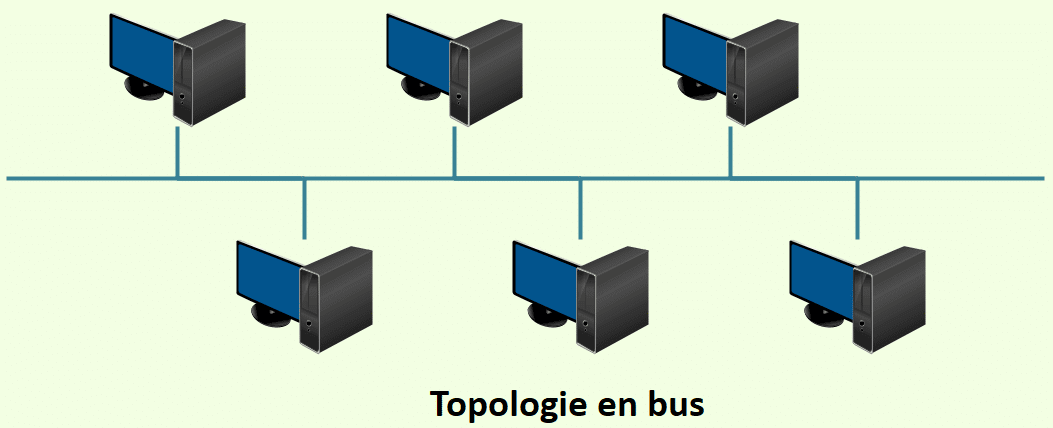
- Topologie en anneau (ring)
Dans cette configuration en anneau, tous les ordinateurs et périphériques se connectent à un seul câble, les deux derniers périphériques sont interconnectés pour créer un « anneau ». En cas de rupture du câble, l’ensemble du réseau tombera en panne. Il existe également une configuration en double anneau, utilisée pour assurer la redondance. En d’autres termes, si le câble principal se détériore, le réseau reste opérationnel en basculant sur le câble de secours.
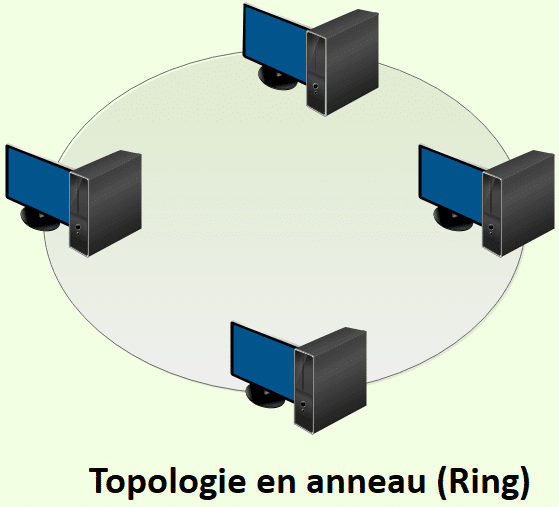
- Topologie en étoile (Star)
Ici, tous les terminaux se connectent à un appareil central, créant ainsi une forme d’étoile. C’est la configuration la plus courante dans les réseaux LAN, tous les ordinateurs sont connectés à un commutateur.
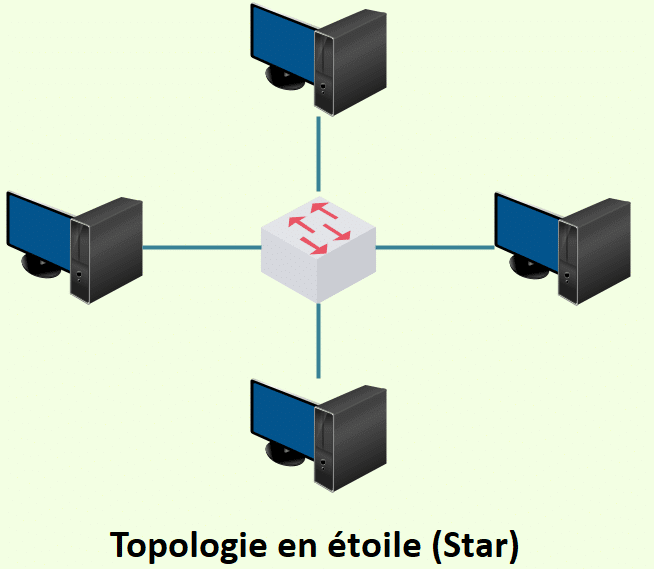
Les connexions physiques utilisées sont des câbles UTP, plus connus sous le nom de RJ45.
Dans cette topologie, si le commutateur au milieu tombe en panne, alors, il n’y aura plus de connectivité entre les équipements qui lui sont raccordés.
Maintenant, examinons un autre exemple de topologie où une entreprise exploite plusieurs sites dans différentes villes de France.
DNS :
Un système de noms de domaine, ou DNS, traduit les noms de domaine lisibles par l’homme (par exemple www.amazon.com) en adresses IP lisibles par une machine (par exemple, 192.0.2.44).
Le DNS (Domain Name System, système de nom de domaine) est en quelque sorte le répertoire téléphonique d’Internet. Les internautes accèdent aux informations en ligne via des noms de domaine (par exemple, nytimes.com ou espn.com), tandis que les navigateurs interagissent par le biais d’adresses IP (Internet Protocol, protocole Internet). Le DNS traduit les noms de domaine en adresses IP afin que les navigateurs puissent charger les ressources web.
Chaque appareil connecté à Internet dispose d’une adresse IP unique que les autres appareils utilisent afin de le trouver. Grâce aux serveurs DNS, les internautes n’ont pas à mémoriser les adresses IP (par exemple, 192.168.1.1 en IPv4) ni les adresses IP alphanumériques plus récentes et plus complexes (par exemple, 2400:cb00:2048:1::c629:d7a2 en IPv6).
Le processus de résolution DNS implique la conversion d’un nom d’hôte (par exemple, www.example.com) en adresse IP « au format informatique » (par exemple, 192.168.1.1). Chaque appareil relié à Internet se voit attribuer une telle adresse. Cette dernière permet de trouver l’appareil approprié sur Internet, de la même manière qu’une adresse dans une rue permet de trouver un domicile. Lorsqu’un utilisateur souhaite charger une page web, une traduction doit intervenir entre l’adresse que l’utilisateur saisit dans son navigateur (example.com) et l’adresse utilisable par la machine, nécessaire pour localiser la page web example.com.
https://www.youtube.com/watch?v=qzWdzAvfBoo
DHCP
Dynamic Host Configuration Protocol (DHCP, protocole de configuration dynamique des hôtes) est un protocole réseau dont le rôle est d’assurer la configuration automatique des paramètres IP d’une station ou d’une machine, notamment en lui attribuant automatiquement une adresse IP et un masque de sous-réseau. DHCP peut aussi configurer l’adresse de la passerelle par défaut et configurer des serveurs de noms comme DNS ou NBNS (connu sous le nom de serveur WINS sur les réseaux de la société Microsoft).
Qu’est-ce que DHCP ? Le protocole DHCP (Dynamic Host Configuration Protocol) est utilisé pour attribuer dynamiquement des adresses IP (Internet Protocol) à chaque hôte du réseau de votre organisation. Dans cette signification DHCP, un hôte peut faire référence à n’importe quel dispositif qui permet l’accès à un réseau. Parmi les exemples, on peut citer les ordinateurs de bureau et les ordinateurs portables, les clients légers et les appareils personnels, entre autres. DHCP garantit que tous ces dispositifs reçoivent une adresse IP .
Dans le contexte de cette définition DHCP, DHCP attribue également des adresses DNS (Domain Name System), des masques de sous-réseau et des passerelles par défaut. Tous ces éléments permettent aux appareils de communiquer avec Internet et entre eux dans les limites de votre réseau.
Comment fonctionne le protocole DHCP (Dynamic Host Configuration Protocol) ?
Les protocoles DHCP envoient des messages aux appareils qui se connectent à votre réseau, leur fournissant ce dont ils ont besoin pour interagir avec les fonctions réseau essentielles. Imaginez si vous disposez d’un petit réseau domestique qui permet à votre ordinateur portable, votre tablette et votre téléphone de se connecter à celui-ci. Si vous devez attribuer une adresse IP à chacun d’entre eux, cela peut ne pas être trop difficile, en particulier parce qu’il n’y a que trois appareils.
D’autre part, l’attribution d’adresses IP, ainsi que de masques de sous-réseau, d’adresses DNS et d’autres données essentielles prendrait beaucoup trop de temps et de travail si vous deviez le faire pour quelques centaines de dispositifs. DHCP fournit automatiquement ces informations à tous les dispositifs qui se connectent à votre réseau.
https://www.youtube.com/watch?v=yH9UvkeAz-I
Adressage :
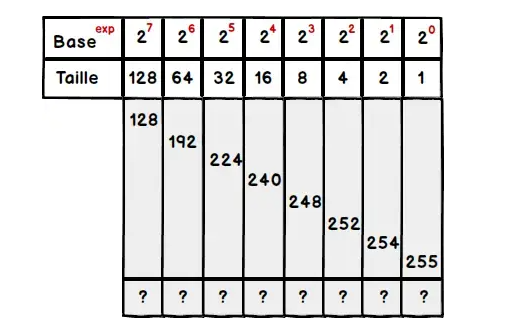
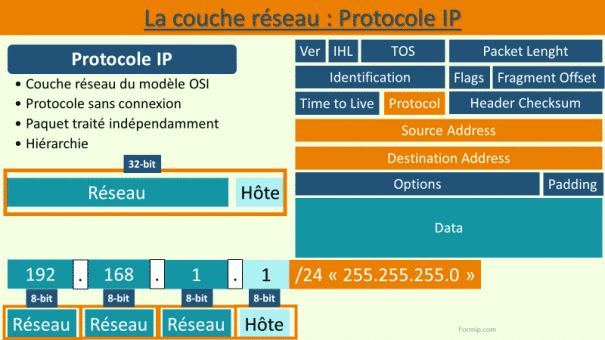
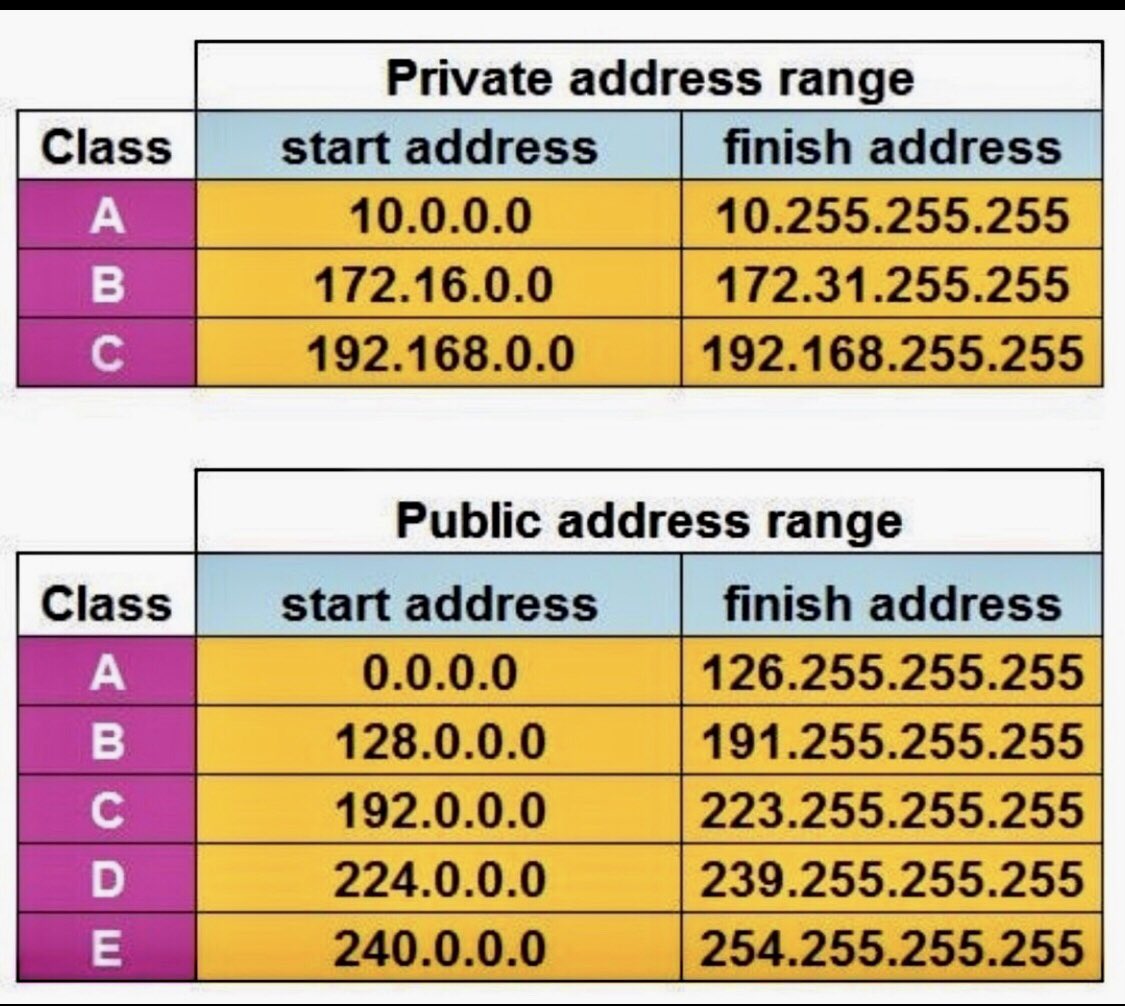
| Classe | Bits de départ | Début | Fin | Notation CIDR par défaut | Masque de sous-réseau par défaut |
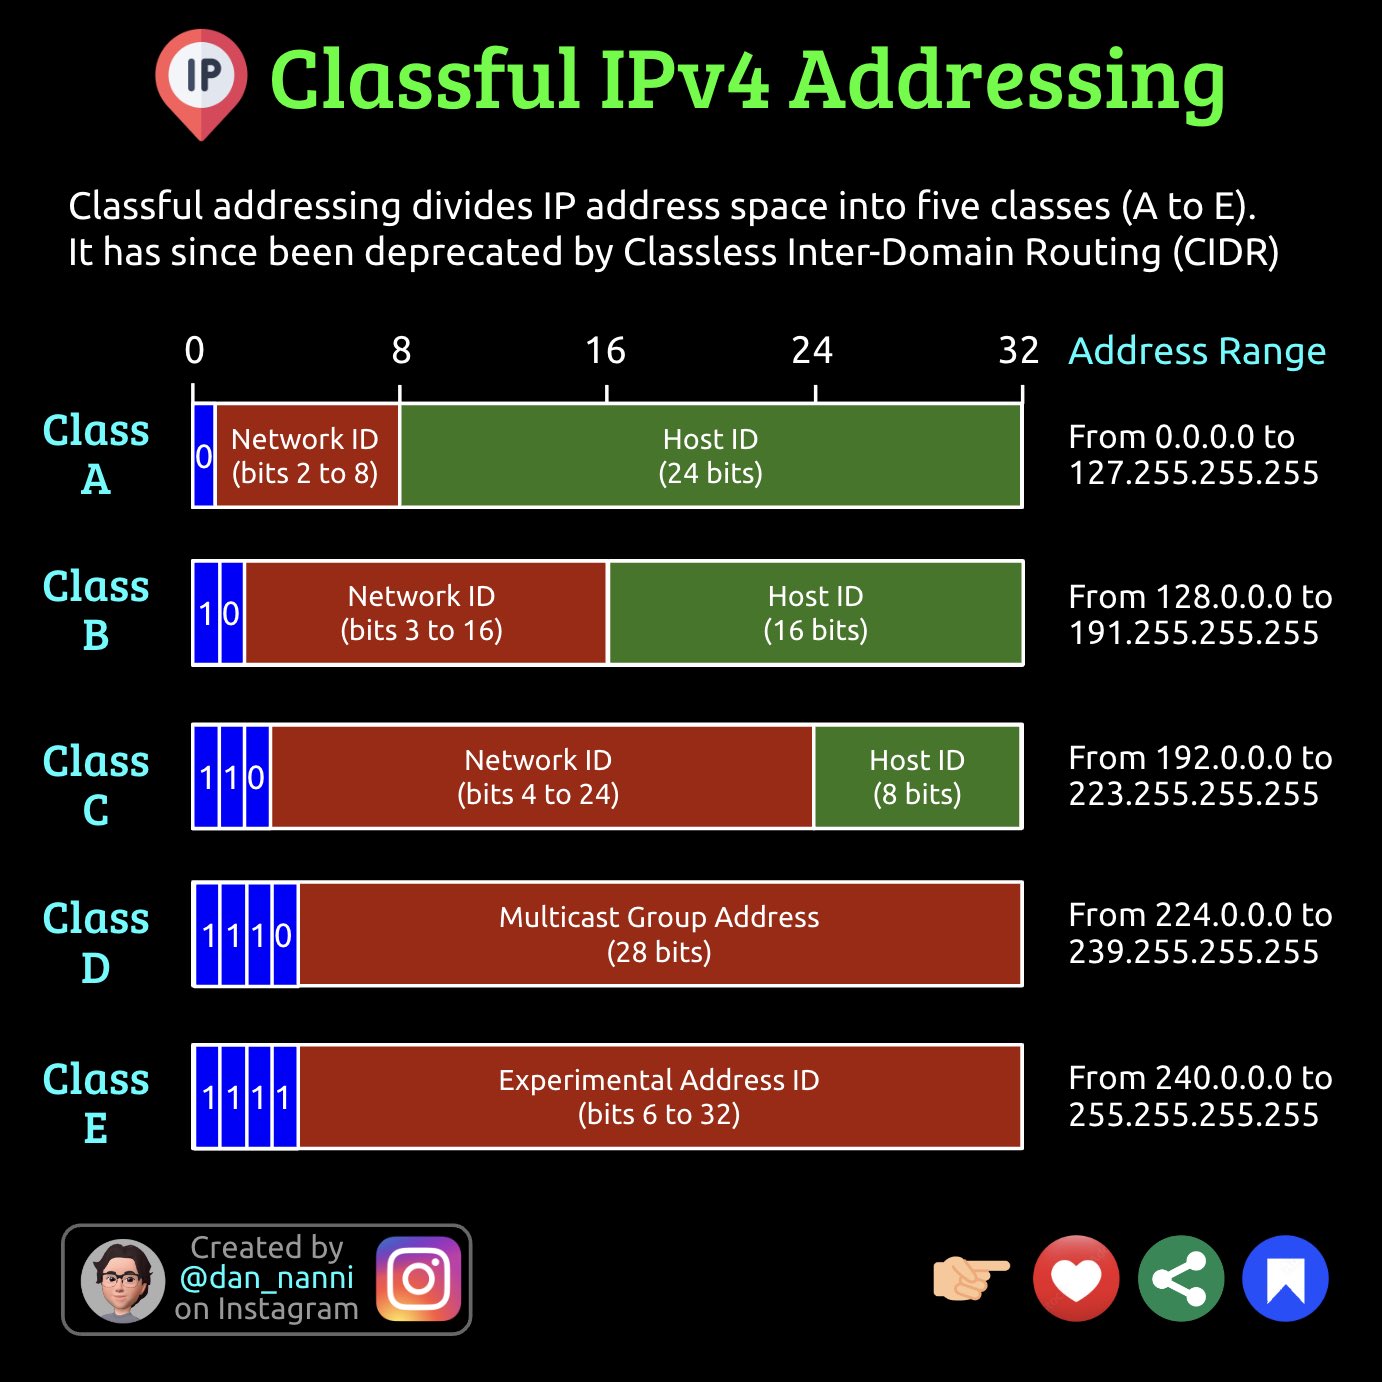
| Classe A | 0 | 0.0.0.0 | 126.255.255.2553(127 est réservé) | /8 | 255.0.0.0 |
| Classe B | 10 | 128.0.0.0 | 191.255.255.255 | /16 | 255.255.0.0 |
| Classe C | 110 | 192.0.0.0 | 223.255.255.255 | /24 | 255.255.255.0 |
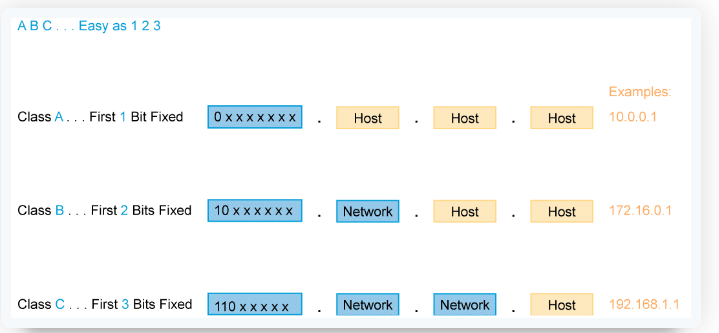
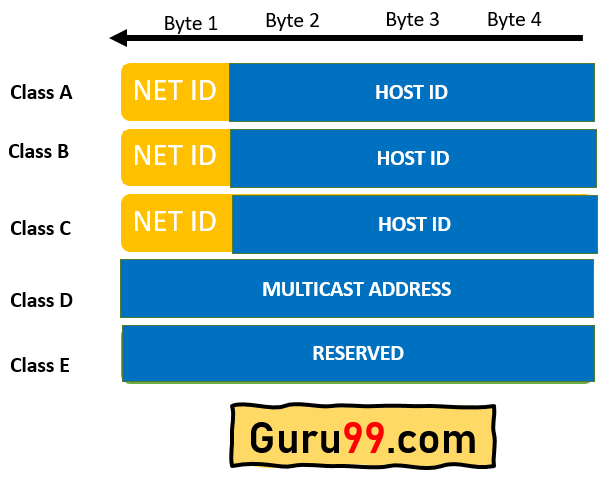
- Une adresse IP de classe A dispose d’une partie net id comportant uniquement un seul octet (host id 3 octet).
- Une adresse IP de classe B dispose d’une partie net id comportant deux octets (host id 2 octets).
- Une adresse IP de classe C dispose d’une partie net id comportant trois octets (host id 1 octet).
Classe A
Une adresse IP de classe A dispose d’un seul octet pour identifier le réseau et de trois octets pour identifier les machines sur ce réseau. Un réseau de classe A peut comporter jusqu’à 23×8-2 postes, soit 224-2, soit 16 777 214 terminaux. Le premier octet d’une adresse IP de classe A commence toujours par le bit 0. La plage d’adresse en binaire s’étend de 0000 0000 à 0111 1111, soit de 0.0.0.0 à 127.255.255.255. Certaines valeurs étant réservées à des usages particuliers. Un exemple d’adresse IP de classe A est : 10.50.49.13.
Classe B
Une adresse IP de classe B dispose de deux octets pour identifier le réseau et de deux octets pour identifier les machines sur ce réseau. Un réseau de classe B peut comporter jusqu’à 22×8-2 postes, soit 216-2, soit 65 534 terminaux. Le premier octet d’une adresse IP de classe B commence toujours par la séquence de bits 10, il est donc compris entre 128 et 191. Un exemple d’adresse IP de classe B est : 172.16.1.23.
Classe C
Une adresse IP de classe C dispose de trois octets pour identifier le réseau et d’un seul octet pour identifier les machines sur ce réseau. Un réseau de classe C peut comporter jusqu’à 28-2 postes, soit 254 terminaux. Le premier octet d’une adresse IP de classe C commence toujours par la séquence de bits 110, il est donc compris entre 192 et 223. Un exemple d’adresse IP de classe C est : 192.168.1.34.
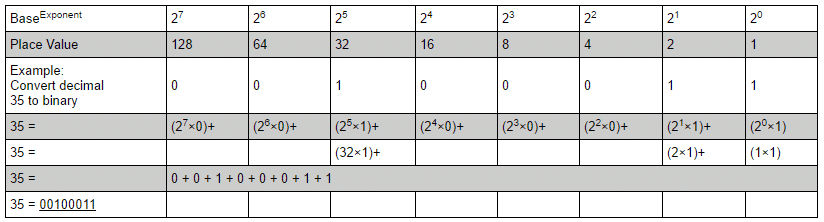
https://www-info.iutv.univ-paris13.fr/CalculIP/index.php
https://www.youtube.com/watch?v=Oc7Ts8tVjyE
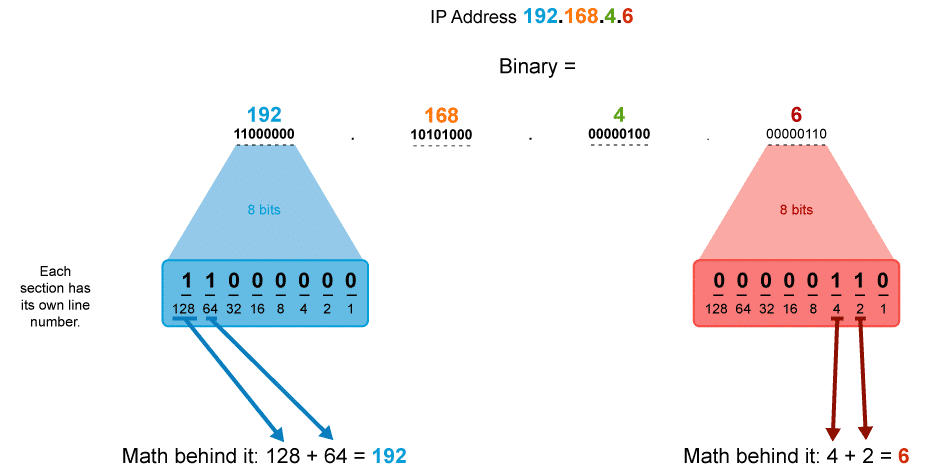
IPV4 vs IPV6
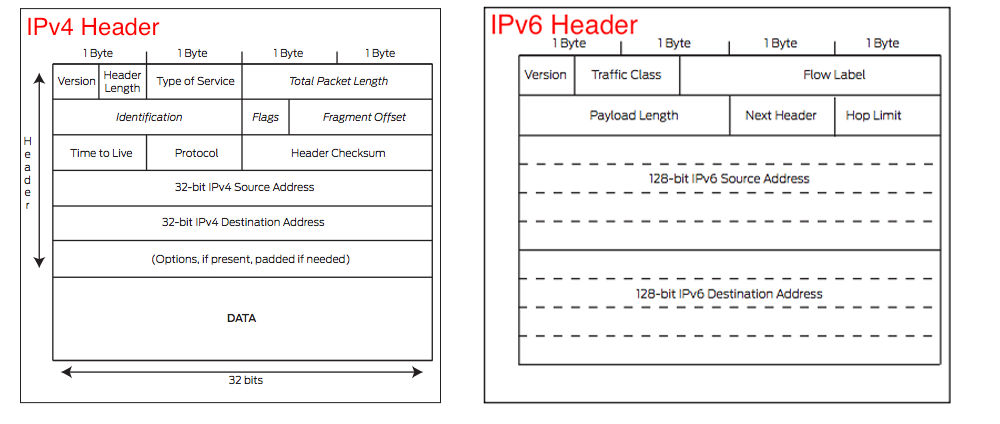
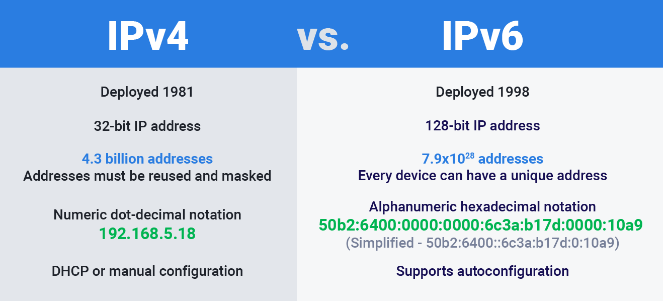
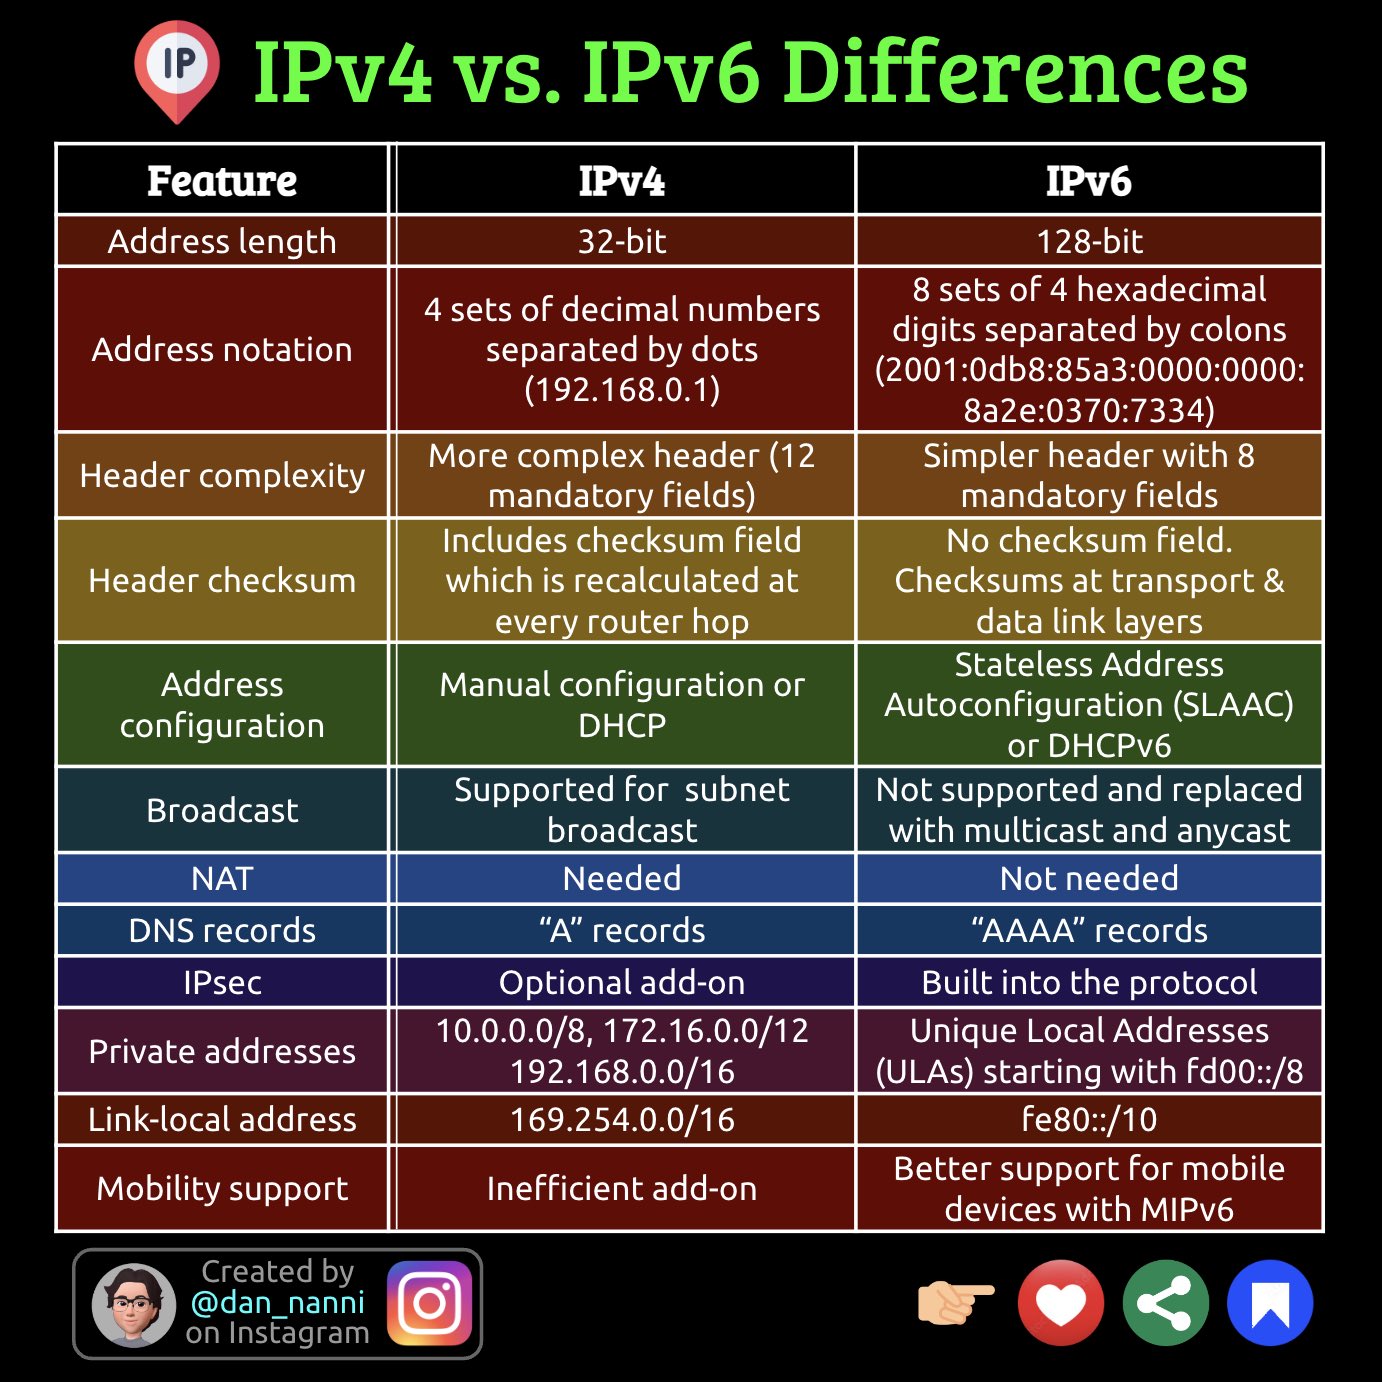
L’IPv4 utilise une adresse 32 bits, qui est le format que vous connaissez probablement le mieux lorsque vous parlez d’ « adresse IP ». Cet espace d’adressage de 32 bits fournit près de 4,3 milliards d’adresses uniques, bien que certains blocs IP soient réservés à des usages particuliers.
Voici un exemple d’adresse IPv4 :
192.168.10.150
L’IPv6 est une version plus récente de l’IP qui utilise un format d’adresse de 128 bits et comprend à la fois des chiffres et des lettres. Voici un exemple d’adresse IPv6 :
3002:0bd6:0000:0000:0000:ee00:0033:6778
L’espace d’adressage complet d’IPv4 est de 2³², soit 4 294 967 296 adresses IP. IPv6 possède un espace d’adressage nettement plus élevé de 2¹²⁸, soit 3,403 × 10³⁸,
Il existe trois types principaux d’adresses IPv6 : unicast, multicast et anycast.
Tout d’abord, les adresses unicast sont utilisées pour la communication de point à point entre un émetteur et un destinataire spécifique. Elles comprennent les adresses globales unicast, qui sont routables sur Internet, ainsi que les adresses de lien local unicast, utilisées pour la communication au sein d’un seul réseau local.
Ensuite, les adresses multicast permettent la communication de groupe, où un paquet est envoyé à un groupe spécifique d’hôtes. Ces adresses sont utilisées pour des applications telles que la diffusion de vidéos en continu ou les jeux en ligne.
Les adresses anycast sont une autre catégorie, où un paquet est envoyé à n’importe quel membre d’un groupe de nœuds ayant la même adresse anycast la plus proche. Cela est souvent utilisé pour des services tels que le DNS distribué ou la distribution de contenu en cache
Enfin, les adresses IPv6 comprennent également des adresses de boucle locale, utilisées pour les communications internes à un seul périphérique, ainsi que des adresses de transition IPv4 pour faciliter la migration d’IPv4 vers IPv6.
Video très complète à regarder :
https://www.youtube.com/watch?v=pwgFeryHTP8
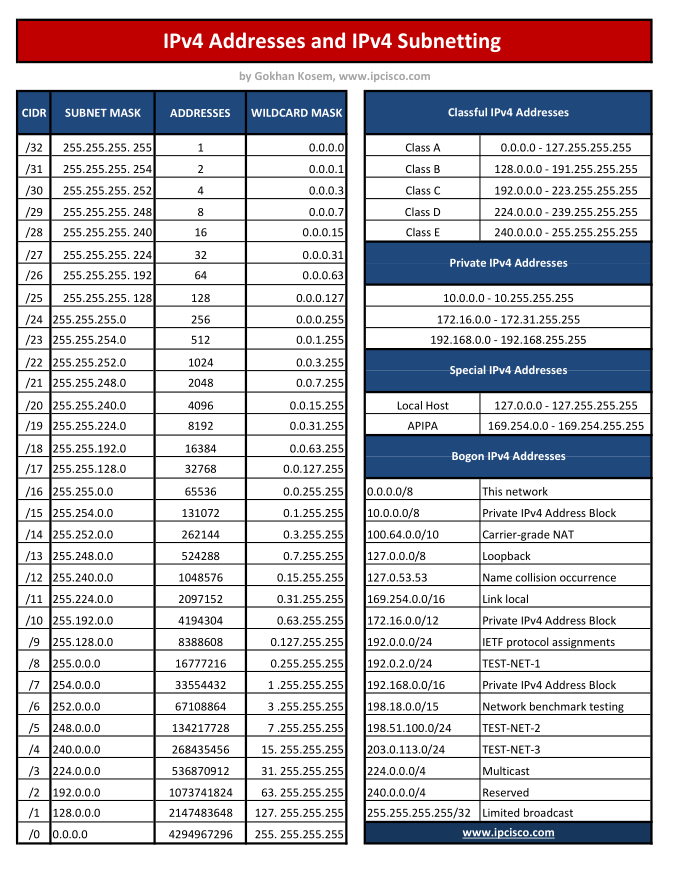
CIDR : classless interdomain routing
Le CIDR aide à augmenter le nombre d’adresses disponibles.
https://www.youtube.com/watch?v=qJIXgl0EjtI&t=845s
| CIDR | Masque de sous-réseau
(décimal) |
Masque de sous-réseau
(binaire) |
Adresses disponibles | Adresses disponibles |
| /0 | 0.0.0.0 | 00000000.00000000.00000000.00000000 | 4.294.967.296 | 232 |
| /1 | 128.0.0.0 | 10000000.00000000.00000000.00000000 | 2.147.483.648 | 231 |
| /2 | 192.0.0.0 | 11000000.00000000.00000000.00000000 | 1.073.741.824 | 230 |
| /3 | 224.0.0.0 | 11100000.00000000.00000000.00000000 | 536.870.912 | 229 |
| /4 | 240.0.0.0 | 11110000.00000000.00000000.00000000 | 268.435.456 | 228 |
| /5 | 248.0.0.0 | 11111000.00000000.00000000.00000000 | 134.217.728 | 227 |
| /6 | 252.0.0.0 | 11111100.00000000.00000000.00000000 | 67.108.864 | 226 |
| /7 | 254.0.0.0 | 11111110.00000000.00000000.00000000 | 33.554.432 | 225 |
| /8 | 255.0.0.0 | 11111111.00000000.00000000.00000000 | 16.777.216 | 224 |
| /9 | 255.128.0.0 | 11111111.10000000.00000000.00000000 | 8.388.608 | 223 |
| /10 | 255.192.0.0 | 11111111.11000000.00000000.00000000 | 4.194.304 | 222 |
| /11 | 255.224.0.0 | 11111111.11100000.00000000.00000000 | 2.097.152 | 221 |
| /12 | 255.240.0.0 | 11111111.11110000.00000000.00000000 | 1.048.576 | 220 |
| /13 | 255.248.0.0 | 11111111.11111000.00000000.00000000 | 524.288 | 219 |
| /14 | 255.252.0.0 | 11111111.11111100.00000000.00000000 | 262.144 | 218 |
| /15 | 255.254.0.0 | 11111111.11111110.00000000.00000000 | 131.072 | 217 |
| /16 | 255.255.0.0 | 11111111.11111111.00000000.00000000 | 65.536 | 216 |
| /17 | 255.255.128.0 | 11111111.11111111.10000000.00000000 | 32.768 | 215 |
| /18 | 255.255.192.0 | 11111111.11111111.11000000.00000000 | 16.384 | 214 |
| /19 | 255.255.224.0 | 11111111.11111111.11100000.00000000 | 8.192 | 213 |
| /20 | 255.255.240.0 | 11111111.11111111.11110000.00000000 | 4.096 | 212 |
| /21 | 255.255.248.0 | 11111111.11111111.11111000.00000000 | 2.048 | 211 |
| /22 | 255.255.252.0 | 11111111.11111111.11111100.00000000 | 1.024 | 210 |
| /23 | 255.255.254.0 | 11111111.11111111.11111110.00000000 | 512 | 29 |
| /24 | 255.255.255.0 | 11111111.11111111.11111111.00000000 | 256 | 28 |
| /25 | 255.255.255.128 | 11111111.11111111.11111111.10000000 | 128 | 27 |
| /26 | 255.255.255.192 | 11111111.11111111.11111111.11000000 | 64 | 26 |
| /27 | 255.255.255.224 | 11111111.11111111.11111111.11100000 | 32 | 25 |
| /28 | 255.255.255.240 | 11111111.11111111.11111111.11110000 | 16 | 24 |
| /29 | 255.255.255.248 | 11111111.11111111.11111111.11111000 | 8 | 23 |
| /30 | 255.255.255.252 | 11111111.11111111.11111111.11111100 | 4 | 22 |
| /31 | 255.255.255.254 | 11111111.11111111.11111111.11111110 | 2 | 21 |
| /32 | 255.255.255.255 | 11111111.11111111.11111111.11111111 | 1 | 20 |
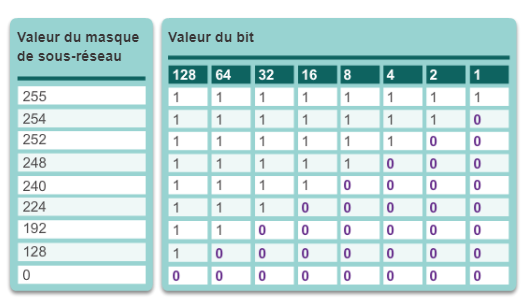
Masque de sous réseau
MAC address
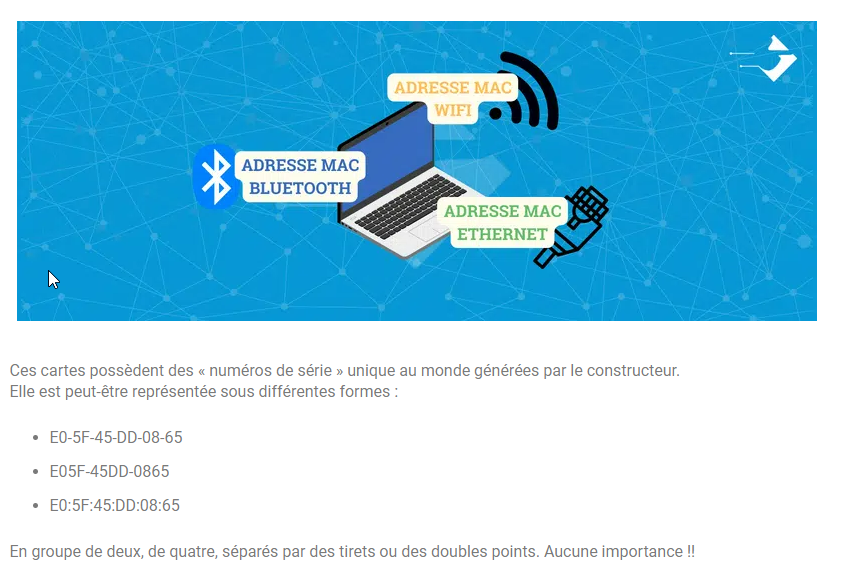
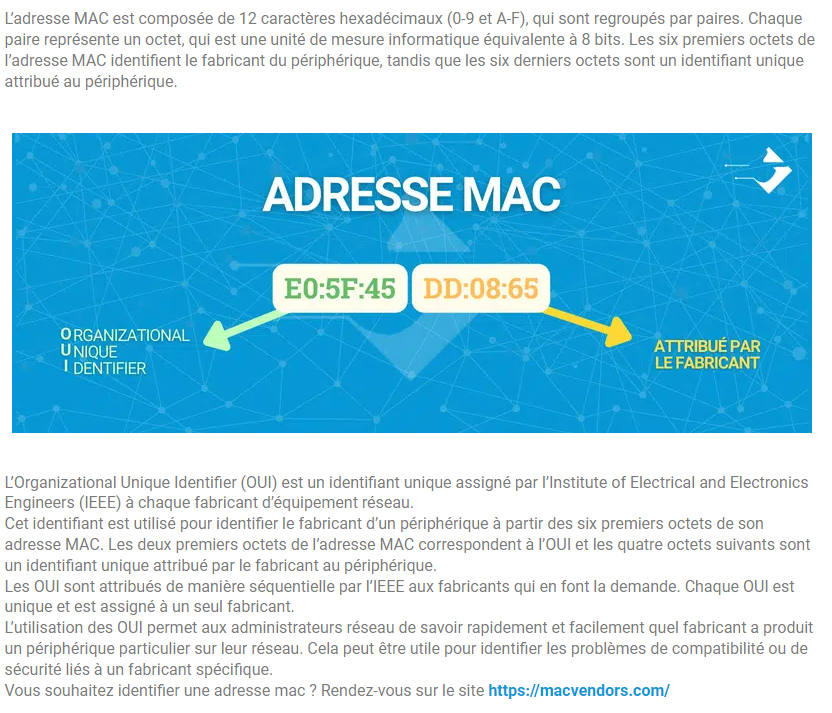
Une adresse MAC (Medium Access Control ou contrôle d’accès au support) est un « numéro de série » unique affecté à chaque matériel du réseau Ethernet destiné à l’identifier dans un réseau.
Cette adresse unique est attribuée par le fabricant à la fabrication du matériel.Il s’agit d’une séquence alphanumérique de la forme : 00:00:00:00:00:00.Cette adresse permet d’identifier le périphérique physique émetteur ou destinataire d’une communication réseau.
Couche 2 du modèle OSI
Localhost
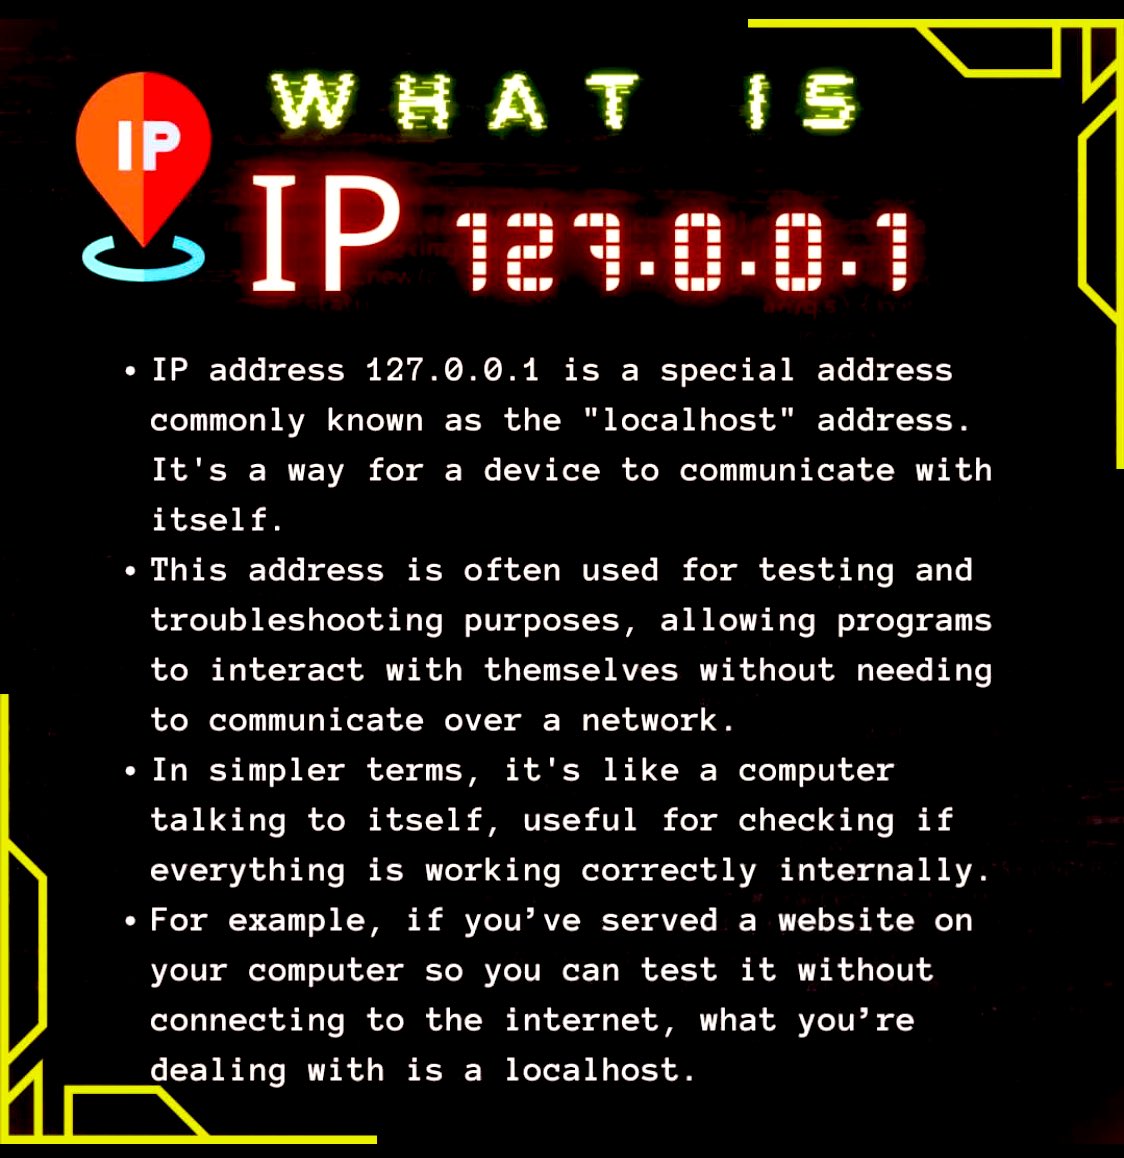
Lorsque vous expliquez ce qu’est un localhost, le premier point à prendre en compte est qu’il s’agit toujours de votre propre ordinateur : lorsque vous appelez le localhost, votre ordinateur se parle à lui-même.
Dans le domaine des réseaux informatiques, localhost (l’hôte local en anglais) est un nom utilisé pour se référer à l’ordinateur local.
On s’en sert pour communiquer avec notre machine par l’intermédiaire du protocole IP. Le nom localhost est associé à l’adresse IPv4 127.0.0.1 et à l’adresse IPv6 ::1 (sous réserve de la disponibilité de l’une ou l’autre des versions du protocole IP). Plage d’adresses IPv4 127.0.0.0/8 (toutes les adresses IPv4 comprises entre 127.0.0.1 et 127.255.255.255 dont la plus utilisée est 127.0.0.1
L’interface réseau virtuelle utilisée dans cette situation se nomme l’interface de loopback (abrégée par lo si vous tapez la commande ifconfig sous Unix).
https://www.youtube.com/watch?v=KXw_fnfinfY
$ ping localhost
PING localhost (127.0.0.1): 56 data bytes
64 bytes from 127.0.0.1: icmp_seq=0 ttl=64 time=0.3 ms
64 bytes from 127.0.0.1: icmp_seq=1 ttl=64 time=0.1 ms
64 bytes from 127.0.0.1: icmp_seq=2 ttl=64 time=0.1 ms
64 bytes from 127.0.0.1: icmp_seq=3 ttl=64 time=0.1 ms
APIPA
APIPA pour « Automatic Private Internet Protocol Addressing » soit « Adressage automatique du protocole IP ». Il s’agit en réalité d’une adresse que la machine va s’attribuer automatiquement si les requêtes DHCP effectuées auparavant échouent.
Lorsqu’un dispositif ne parvient pas à obtenir une adresse IP valide, il active le mécanisme d’adressage APIPA. Ce mécanisme lui permet de s’attribuer automatiquement une adresse IP dans une plage spécifique. La plage d’adresses APIPA se situe généralement entre 169.254.0.1 et 169.254.255.254, avec un masque de sous-réseau de 255.255.0.0 (/16 en notation CIDR).
L’APIPA se trouvera dans le réseau 169.254.0.0/16. C’est un réseau privé qui n’est routable ni sur Internet ni ailleurs. Lorsque le poste dispose d’une IP en APIPA, il ne pourra communiquer qu’avec d’autres cartes réseaux configurées en APIPA. Il faut savoir que le service APIPA continue de vérifier la présence d’un serveur DHCP dans les environs toutes les cinq minutes, plus concrètement il réémet une requête de type « DHCP Discover » en espérant avoir une réponse d’un serveur, s’il obtient une réponse, le service DHCP affectera une IP à la carte réseau et remplacera l’IP APIPA en place.
Il faut noter que les clients vérifient que l’adresse APIPA choisie est unique sur le réseau avant de l’utiliser grâce au protocole de résolution d’adresses (ARP).
ARP
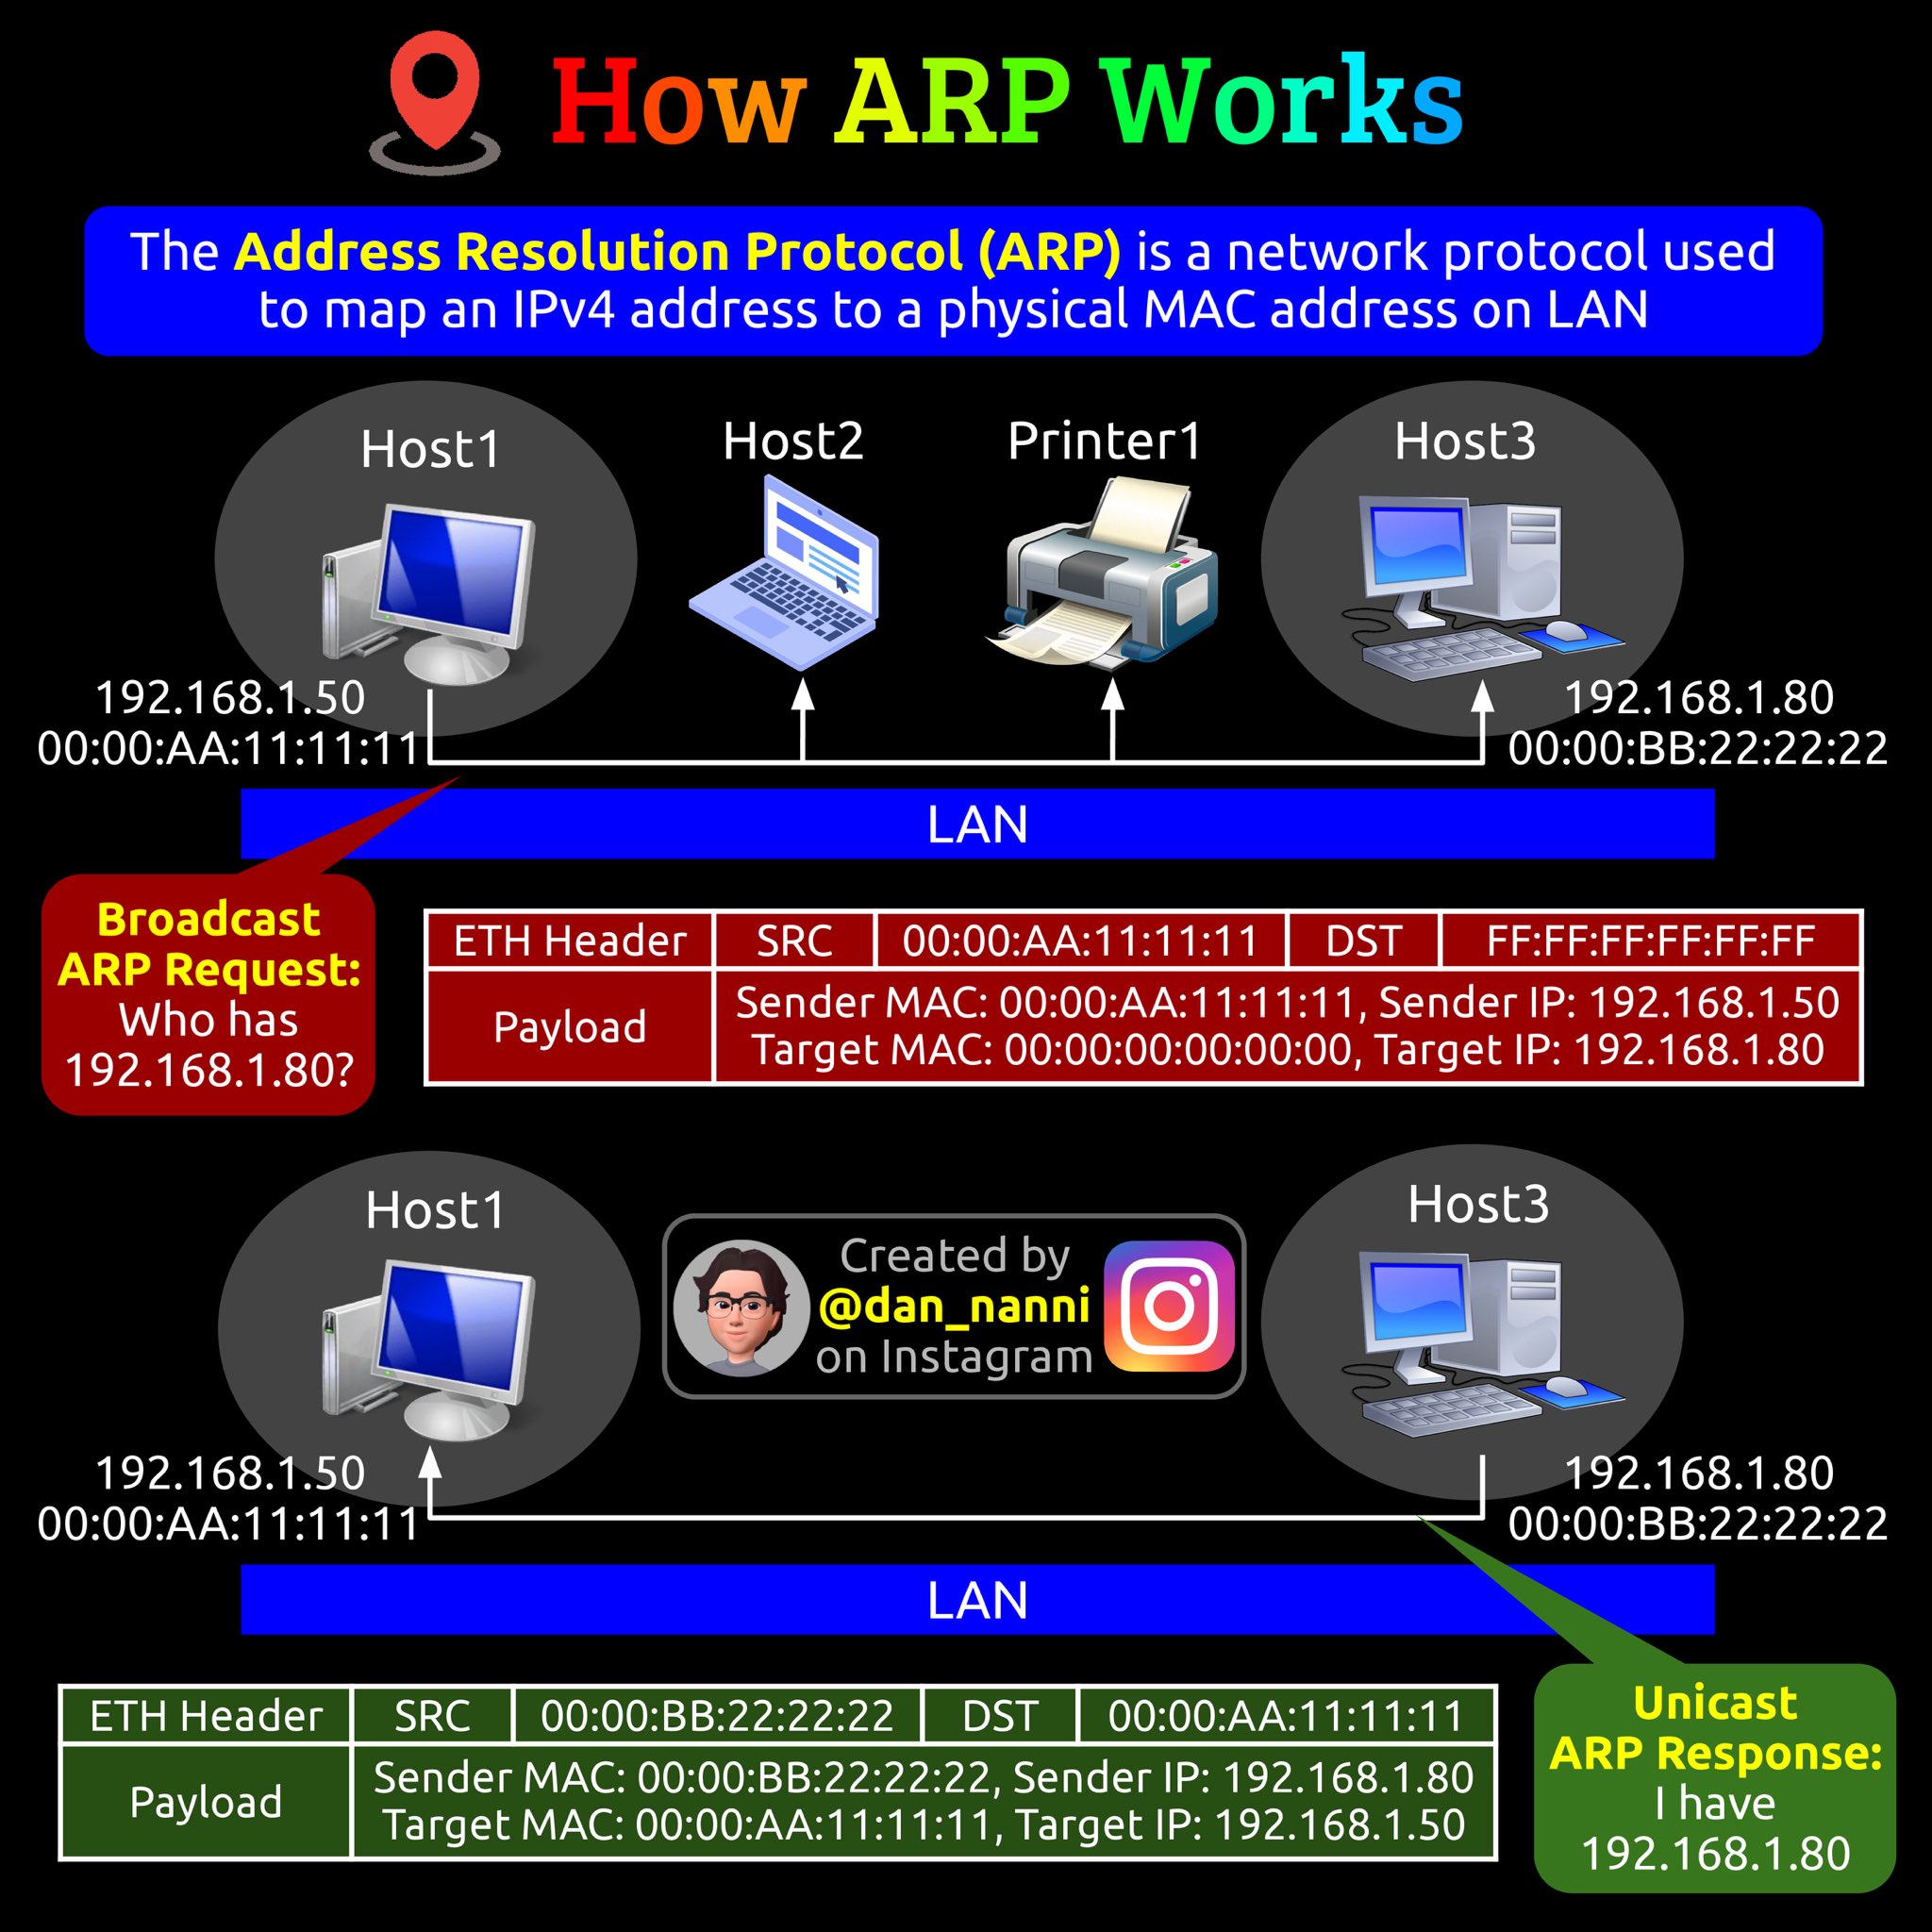
L’Address Resolution Protocol (ARP, protocole de résolution d’adresse) est un protocole utilisé pour associer l’adresse de protocole de couche réseau (typiquement une adresse IPv4) d’un hôte distant, à son adresse de protocole de couche de liaison (typiquement une adresse MAC). Il se situe à l’interface entre la couche réseau (couche 3 du modèle OSI) et la couche de liaison (couche 2 du modèle OSI).
Un ordinateur connecté à un réseau informatique souhaite émettre une trame Ethernet à destination d’un autre ordinateur dont il connaît l’adresse IP et placé dans le même sous-réseau. Dans ce cas, cet ordinateur va placer son émission en attente et effectuer une requête ARP en broadcast de niveau 2. Cette requête est de type « quelle est l’adresse MAC correspondant à l’adresse IP adresseIP ? Répondez à monAdresseIP ».
Puisqu’il s’agit d’un broadcast, tous les ordinateurs du segment vont recevoir la requête. En observant son contenu, ils pourront déterminer quelle est l’adresse IP sur laquelle porte la recherche. La qui possède cette adresse IP sera la seule à répondre en envoyant à la machine émettrice une réponse ARP du type « je suis adresseIP, mon adresse MAC est adresseMAC ». Pour émettre cette réponse au bon ordinateur, il crée une entrée dans son cache ARP à partir des données contenues dans la requête ARP qu’il vient de recevoir.
La machine à l’origine de la requête ARP reçoit la réponse, met à jour son cache ARP et peut donc envoyer à l’ordinateur concerné le message qu’elle avait mis en attente.
Il suffit donc d’un broadcast et d’un unicast pour créer une entrée dans le cache ARP de deux ordinateurs.
arp -a : affiche toutes les entrées dans le cache ARP.
Modèle OSI et TCP/IP
Vidéo très complète : avec des comparatifs et du Packet Tracer
TCI/IP
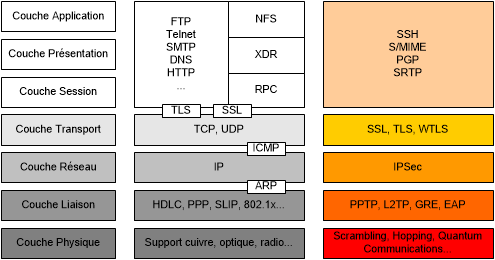
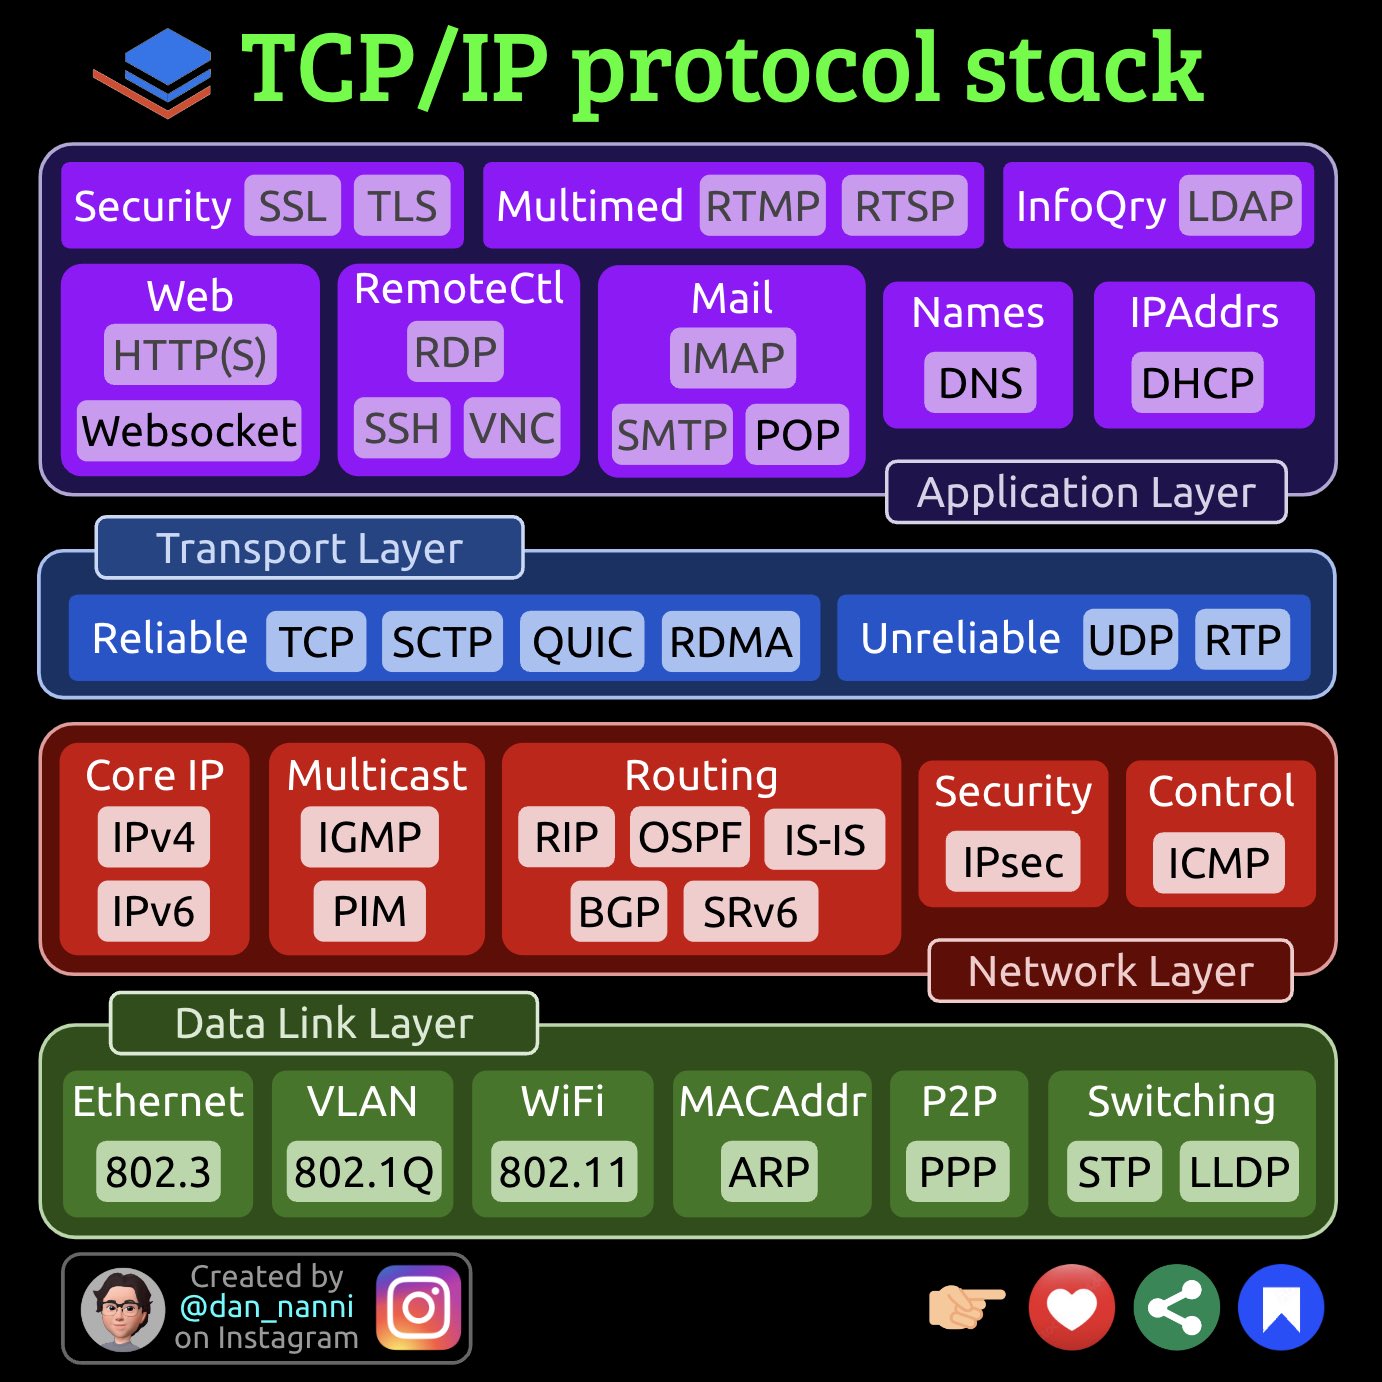
Le schéma qui suit essaie de montrer où se situent divers protocoles dans le modèle OSI de l’ISO :
| 7 | Application | par exemple : HTTP, HTTPS, Gopher, SMTP, SNMP, FTP, Telnet, NFS, NNTP |
| 6 | Présentation | par exemple : ASCII, Unicode, MIME, XDR, ASN.1, SMB, AFP |
| 5 | Session | ex. ISO 8327 / CCITT X.225, RPC, Netbios, ASP |
| 4 | Transport | par exemple : TCP, UDP, SCTP, SPX, ATP |
| 3 | Réseau | par exemple : IP (IPv4 ou IPv6), ICMP, IGMP, X.25, CLNP, ARP, RARP, OSPF, RIP, IPX, DDP |
| 2 | Liaison | par exemple : Ethernet, Token Ring, PPP, HDLC, Frame relay, RNIS (ISDN), ATM, Wi-Fi, Bluetooth, ZigBee, irDA (Infrared Data Association) |
| 1 | Physique | par exemple : techniques de codage du signal (électronique, radio, laser, etc.) pour la transmission des informations sur les réseaux physiques (réseaux filaires, optiques, radioélectriques …) |
,
Couche Physique
La couche physique décrit les caractéristiques physiques de la communication, comme les conventions à propos de la nature du média utilisé pour les communications (les câbles, les liens par fibre optique ou par radio), et tous les détails associés comme les connecteurs, les types de codage ou de modulation, le niveau des signaux, les longueurs d’onde, la synchronisation et les distances maximales.
Couche de Liaison de données
La couche de liaison de données spécifie comment les paquets sont transportés sur la couche physique, et en particulier le tramage (i.e. les séquences de bits particulières qui marquent le début et la fin des paquets). Les en-têtes des trames Ethernet, par exemple, contiennent des champs qui indiquent à quelle(s) machine(s) du réseau un paquet est destiné. Exemples de protocoles de la couche de liaison de données : Ethernet, Wireless Ethernet, SLIP, Token Ring et ATM.
PPP (Point to Point Protocol) est un peu plus complexe, car il a été initialement spécifié pour fonctionner au-dessus d’un autre protocole de liaison de données
Cette couche est subdivisée en LLC et MAC par l’IEEE6.
Couche Réseau
Dans sa définition d’origine, la couche de réseau résout le problème de l’acheminement de paquets à travers un seul réseau. Exemples de protocoles de ce type : X.25, et le Initial Connection Protocol d’ARPANET.
Lorsque deux terminaux communiquent entre eux via ce protocole, aucun chemin pour le transfert des données n’est établi à l’avance : il est dit que le protocole est « non orienté connexion ». Par opposition, pour un système comme le réseau téléphonique commuté, le chemin par lequel va passer la voix (ou les données) est établi au commencement de la connexion : le protocole est « orienté connexion ».
Avec l’avènement de la notion d’interconnexion de réseaux, des fonctions additionnelles ont été ajoutées à cette couche, et plus spécialement l’acheminement de données depuis un réseau source vers un réseau destinataire. Ceci implique généralement le routage des paquets à travers un réseau de réseaux, connu sous le nom d’Internet.
Dans la suite de protocoles Internet, IP assure l’acheminement des paquets depuis une source vers une destination, et supporte aussi d’autres protocoles, comme ICMP (utilisé pour transférer des messages de diagnostic liés aux transmissions IP) et IGMP (utilisé pour gérer les données multicast).
ICMP et IGMP sont situés au-dessus d’IP, mais assurent des fonctions de la couche réseau, ce qui illustre l’incompatibilité entre les modèles Internet et OSI.
La couche réseau IP peut transférer des données pour de nombreux protocoles de plus haut niveau. Ces protocoles sont identifiés par un numéro de protocole IP (IP Protocol Number) unique. ICMP et IGMP sont respectivement les protocoles 1 et 2.
Couche Transport
Les protocoles de la couche de transport peuvent résoudre des problèmes comme la fiabilité des échanges (« est-ce que les données sont arrivées à destination ? ») et assurer que les données arrivent dans l’ordre correct. Dans la suite de protocoles TCP/IP, les protocoles de transport déterminent aussi à quelle application chaque paquet de données doit être délivré.
TCP (protocole IP numéro 6) est un protocole de transport « fiable », orienté connexion, qui fournit un flux d’octets fiable assurant l’arrivée des données sans altérations et dans l’ordre, avec retransmission en cas de perte, et élimination des données dupliquées. Il gère aussi les données « urgentes » qui doivent être traitées dans le désordre (même si techniquement, elles ne sont pas émises hors bande).
TCP essaie de délivrer toutes les données correctement et en séquence — c’est son but et son principal avantage sur UDP, même si ça peut être un désavantage pour des applications de transfert ou de routage de flux en temps-réel, avec des taux de perte élevées au niveau de la couche réseau.
UDP (protocole IP numéro 17) est un protocole simple, sans connexion, « non fiable » — ce qui signifie qu’il ne vérifie pas que les paquets sont arrivés à destination, et ne garantit pas leur arrivée dans l’ordre. Si une application a besoin de ces garanties, elle doit les assurer elle-même, ou bien utiliser TCP. UDP est généralement utilisé par des applications de diffusion multimédia (audio et vidéo, etc.) pour lesquelles le temps requis par TCP pour gérer les retransmissions et l’ordonnancement des paquets n’est pas disponible, ou pour des applications basées sur des mécanismes simples de question/réponse comme les requêtes DNS, pour lesquelles le surcoût lié à l’établissement d’une connexion fiable serait disproportionné par rapport au besoin.
Aussi bien TCP qu’UDP sont utilisés par de nombreuses applications. Les applications situées à une quelconque adresse réseau se distinguent par leur numéro de port TCP ou UDP. Par convention, des ports bien connus sont associés avec certaines applications spécifiques.
RTP (Real Time Protocol) est un protocole fonctionnant avec UDP ou TCP, spécialisé dans le transport de données possédant des contraintes temps réel. Typiquement, il sert à transporter des vidéos pour que l’on puisse synchroniser la lecture des images et du son directement, sans les stocker préalablement.
SCTP (Stream Control Transmission Protocol) a été défini en 2000 dans la RFC 49607, et un texte d’introduction existe dans la RFC 32868. Il fournit des services similaires à TCP, assurant la fiabilité, la remise en ordre des séquences, et le contrôle de congestion. Alors que TCP est byte-oriented (orienté octets), SCTP gère des « frames » (courtes séquences). Une avancée majeure de SCTP est la possibilité de communications multi-cibles, où une des extrémités de la connexion est constituée de plusieurs adresses IP.
Couche Application
Flux de données dans les protocoles Internet
C’est dans la couche application que se situent la plupart des programmes réseau.
Ces programmes et les protocoles qu’ils utilisent incluent HTTP (World Wide Web), FTP (transfert de fichiers), SMTP (messagerie), SSH (connexion à distance sécurisée), DNS (recherche de correspondance entre noms et adresses IP) et beaucoup d’autres.
Les applications fonctionnent généralement au-dessus de TCP ou d’UDP, et sont souvent associées à un port bien connu. Exemples :
- HTTP port TCP 80 ;
- SSH port TCP 22 ;
- DNS port UDP 53 (TCP 53 pour les transferts de zones et les requêtes supérieures à 512 octets) ;
- RIP port UDP 520 ;
- FTP port TCP 21 ;
Ces ports ont été assignés par l’Internet Assigned Numbers Authority (IANA).
Ports et protocoles
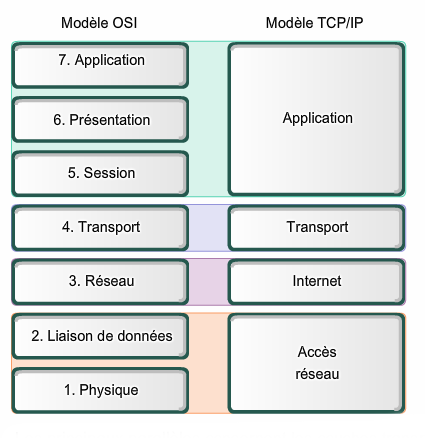
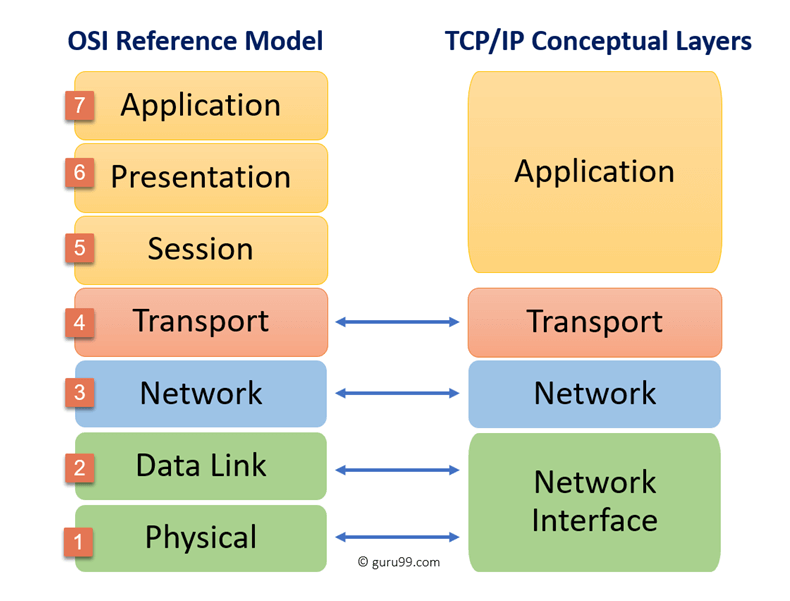
Quand on parle de commutateurs Ethernet de couche 2 et de couche 3, nous faisons en fait référence aux couches d’un modèle de protocole générique – Interconnexion des Systèmes Ouverts (OSI). Il s’agit d’un terme couramment utilisé pour décrire les communications du réseau. Les communications de données entre différents réseaux ne sont pas possibles s’il n’existe pas de règles communes pour la transmission et la réception des paquets de données. Ces règles sont connues sous le nom de protocoles, parmi lesquels le protocole de contrôle de transmission (TCP) / protocole Internet (IP) est l’un des plus utilisés. Le modèle TCP/IP est couramment utilisé dans la description du réseau et est plus vieux que le modèle OSI. Ils ont tous deux plusieurs couches, quelle est la différence entre eux ?
Couches du modèle de référence OSI
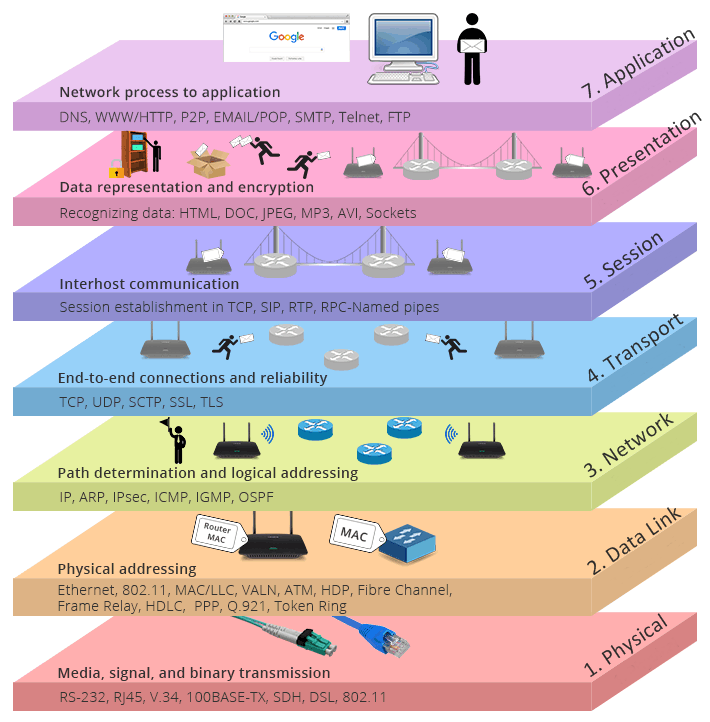
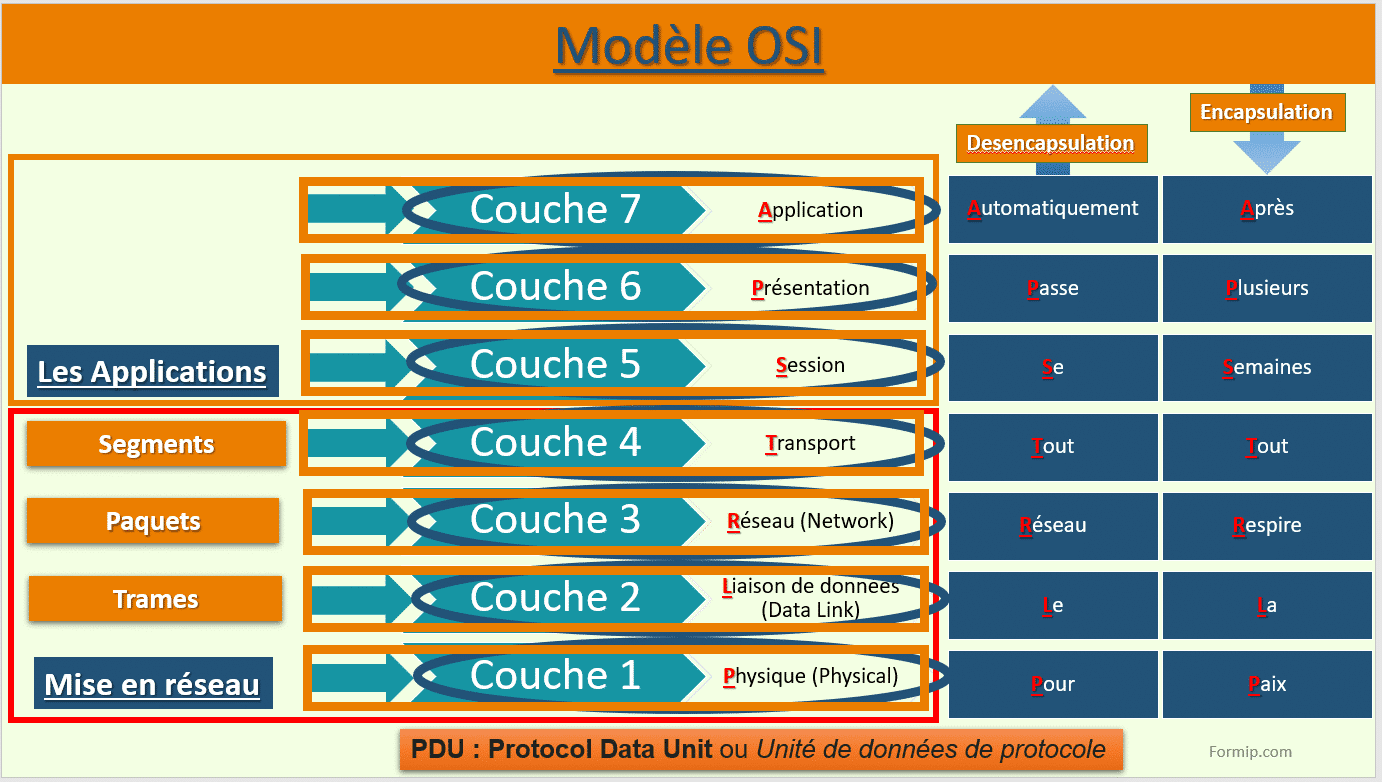
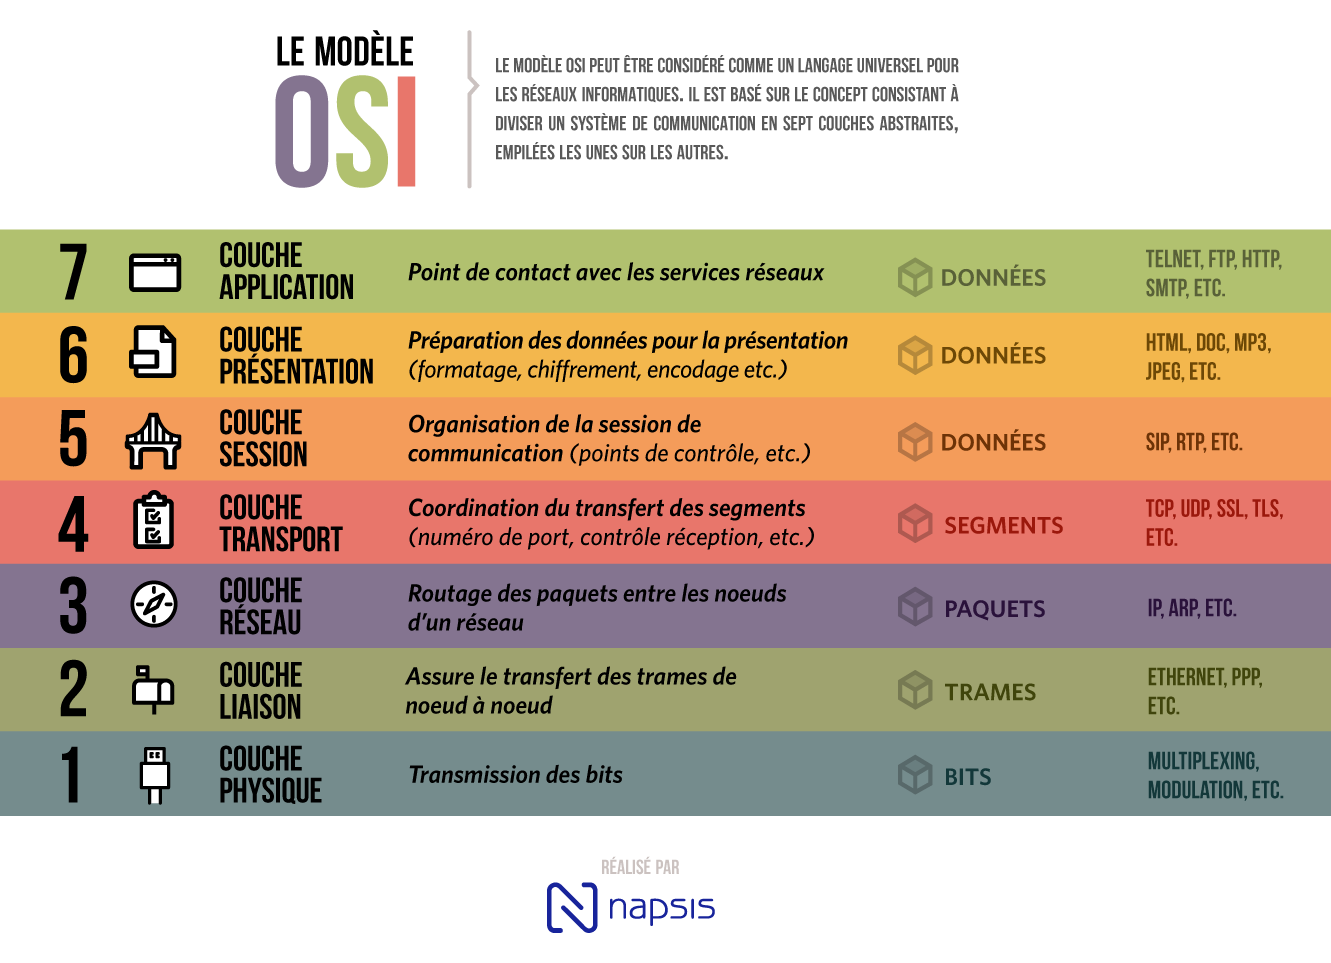
Le modèle OSI est un modèle conceptuel qui caractérise et normalise la façon dont différents composants logiciels et matériels impliqués dans une communication réseau doivent diviser le travail et interagir les uns avec les autres. Il contient sept couches. Vous pouvez voir les noms et fonctions de base de chaque couche dans la figure suivante.
Couche 7 : Couche d’application
La couche application du modèle OSI interagit directement avec les applications logicielles pour fournir des fonctions de communication selon les besoins. Cette couche est la plus proche des utilisateurs finaux. La fonction de la couche d’application consiste généralement à vérifier la disponibilité des partenaires de communication et des ressources pour prendre en charge tout transfert de données. Cette couche définit également des protocoles pour les applications finales, tels que le système de noms de domaine (DNS), le protocole de transfert de fichiers (FTP), le protocole de transfert hypertexte (HTTP), le protocole d’accès aux messages Internet (IMAP), le protocole de bureau de poste (POP), le protocole de transfert de courrier simple (SMTP), le protocole de gestion de réseau simple (SNMP) et Telnet (une émulation de terminal).
Couche 6 : Couche de présentation
La couche de présentation vérifie les données pour s’assurer qu’elles sont compatibles avec les ressources de communication. Elle traduit les données dans un format que la couche d’application et les couches inférieures acceptent. Tout formatage de données ou conversion de code nécessaire est également pris en charge par la sixième couche, comme la conversion d’un fichier de texte codé en EBCDIC (Extended Binary Coded Decimal Interchange Code) en un fichier de texte codé en ASCII (American Standard Code for Information Interchange). Elle fonctionne également pour la compression et le cryptage des données. Par exemple, les appels vidéo seront compressés pendant la transmission afin qu’ils puissent être transmis plus rapidement, et les données seront récupérées du côté récepteur. Pour les données qui ont des exigences de sécurité élevées, telles qu’un message texte contenant votre mot de passe, elles seront cryptées sur cette couche.
Couche 5 : Couche de session
La couche session contrôle les dialogues (connexions) entre les ordinateurs. Elle établit, gère, entretient et, finalement, met fin aux connexions entre l’application locale et l’application distante. Les logiciels de la couche 5 gèrent également les fonctions d’authentification et d’autorisation. Elle vérifie également que les données sont bien fournies. La couche session est généralement appliquée explicitement dans les environnements d’application qui utilisent des appels de procédure à distance.
Couche 4 : Couche transport
La couche transport fournit les fonctions et les moyens de transférer des séquences de données d’une source à un hôte de destination via un ou plusieurs réseaux, tout en conservant les fonctions de qualité de service (QoS) et en assurant la livraison complète des données. L’intégrité des données peut être garantie par la correction des erreurs et des fonctions similaires. Elle peut également assurer une fonction explicite de contrôle des flux. Bien qu’ils ne correspondent pas strictement au modèle OSI, les protocoles TCP et UDP (User Datagram Protocols) sont des protocoles essentiels de la couche 4.
Couche 3 : Couche réseau
La couche réseau gère le routage des paquets via des fonctions d’adressage et de commutation logiques. Un réseau est un support sur lequel de nombreux nœuds peuvent être connectés. Chaque nœud a une adresse. Lorsqu’un nœud a besoin de transférer un message à d’autres nœuds, il peut simplement fournir le contenu du message et l’adresse du nœud de destination, puis le réseau trouvera le moyen de livrer le message au nœud de destination, éventuellement en l’acheminant par d’autres nœuds. Si le message est trop long, le réseau peut le diviser en plusieurs segments au niveau d’un nœud, les envoyer séparément et réassembler les fragments au niveau d’un autre nœud.
Couche 2 : Couche de liaison de données
La couche de liaison de données assure le transfert entre nœuds – un lien entre deux nœuds directement connectés. Elle gère l’encapsulation et la décapsulation des données dans les trames. Elle définit le protocole permettant d’établir et de terminer une connexion entre deux dispositifs physiquement connectés, tel que le protocole point à point (PPP). La couche de liaison de données est généralement divisée en deux sous-couches : la couche de contrôle d’accès aux médias (MAC) et la couche de contrôle de liaison logique (LLC). La couche MAC est chargée de contrôler la façon dont les appareils d’un réseau accèdent à un support et sont autorisés à transmettre des données. La couche LLC est responsable de l’identification et de l’encapsulation des protocoles de la couche réseau, et contrôle la vérification des erreurs et la synchronisation des trames.
Couche 1 : Couche physique
La couche physique définit les spécifications électriques et physiques de la connexion des données. Par exemple, la disposition des broches du connecteur, les tensions de fonctionnement d’un câble électrique, les spécifications des câbles à fibres optiques et la fréquence des appareils sans fil. Elle est responsable de la transmission et de la réception de données brutes non structurées sur un support physique. Le contrôle du débit binaire est effectué au niveau de la couche physique. Il s’agit de la couche des équipements de réseau de bas niveau et n’est jamais concerné par les protocoles ou autres éléments de couche supérieure.
Couches de modèle TCP/IP
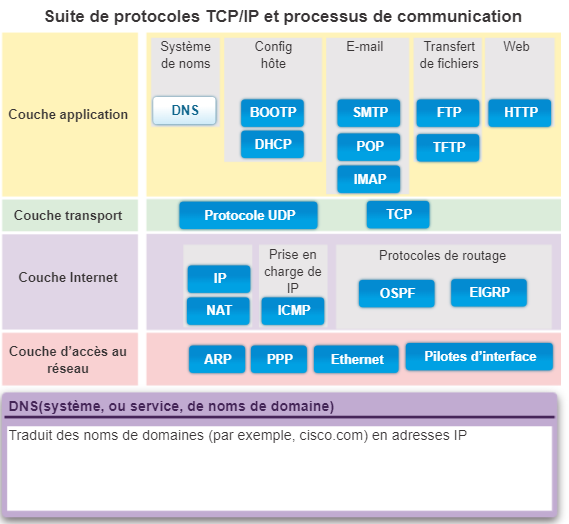
Le modèle TCP/IP est également un modèle de référence en couches, mais c’est un modèle à quatre couches. Il est également connu sous le nom de « suite de protocoles Internet”. Il est généralement appelé TCP/IP parce que les protocoles de base sont TCP et IP, mais ce ne sont pas les seules protocoles utilisés dans ce modèle.
-Couche d’Application
La couche d’application du modèle TCP/IP permet aux applications la d’accéder aux services des autres couches, et détermine les protocoles que les applications utilisent pour échanger des données. Les protocoles de couche d’application les plus connus sont HTTP, FTP, SMTP, Telnet, DNS, SNMP et Routing Information Protocol (RIP).
-Couche de Transport
La couche transport, également connue comme la couche transport hôte-à-hôte, est chargée de fournir à la couche application des services de communication de session et de datagramme. Les protocoles de base de cette couche sont TCP et UDP. TCP fournit un service de communication fiable de dispositif à dispositif et axé sur la connexion. Il est responsable de la séquence et reconnaissance de réception des paquets envoyés, et récupération des paquets perdus en transmission. UDP fournit un service de communication sans connexion et peu fiable de dispositif à dispositif ou dispositif à plusieurs dispositifs. UDP est généralement utilisé lorsque il y a une faible quantité de données à transférer (par exemple, lorsque les données peuvent tenir dans un seul paquet).
-Couche Internet
La couche Internet est responsable des fonctions d’adressage, du conditionnement et de routage des hôtes. Les principaux protocoles de la couche de protocole Internet sont IP, Protocole de résolution d’adresse (ARP), Protocole de message de contrôle Internet (ICMP) et protocole de gestion de groupe Internet (IGMP). IP est un protocole routable responsable de l’adressage IP, du routage, de la fragmentation et du réassemblage des paquets. ARP est responsable de la découverte des adresses de la couche d’accès au réseau telles que les adresses matérielles associées à une couche d’accès Internet déterminée. ICMP est chargé de fournir des fonctions de diagnostic et de signaler les erreurs provoquées par une mauvaise livraison de paquets IP. IGMP est responsable de la gestion des groupes de multidiffusion (Multicast) IP. Dans cette couche, l’IP ajoute un en-tête aux paquets, qui est connu comme adresse IP. Il existe maintenant une adresse IPv4 (32 bits) et une adresse IP Ipv6 (128 bits).
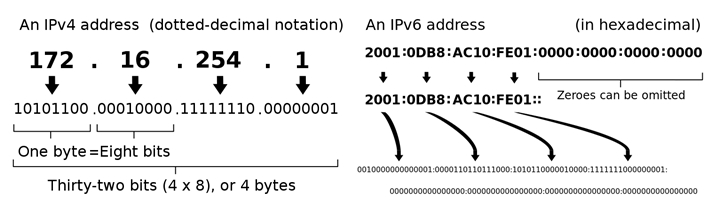
Figure 2 : Exemples d’adresses IPv4 et IPv6.
Couche Accès Réseau
La couche d’accès réseau (ou couche de liaison) est responsable de placer et de recevoir les paquets TCP/IP dans et en dehors du support réseau. TCP/IP est conçu pour être indépendant de la méthode d’accès au réseau, du format de trame et du support. En d’autres termes, il est indépendant de toute technologie de réseau spécifique. De cette façon, TCP/IP peut être utilisé pour connecter différents types de réseaux, tels que l’Ethernet, Token Ring, et Asynchronous Transfer Mode (ATM).
Comment les données sont-elles traitées pendant la transmission ?
Dans un système en couches, les dispositifs d’une couche échangent des données dans un format différent, qui est connue sous le nom d’unité de données de protocole (PDU). Le tableau ci-dessous montre les PDU dans différentes couches.
Tableau : unité de données de protocole (PDU) en cours de traitement dans différentes couches.
| Type de Modèle | Couches OSI | Unité de Données du Protocole (PDU) | Couches TCP/IP |
| Couches d’Hôtes | Couche d’Application | Données | Couche d’Application |
| Couche de Présentation | |||
| Couche de Session | |||
| Couche de Transport | Segment (TCP) / Datagramme (UDP) | Couche de Transport | |
| Couches de Média | Couche Réseau | Paquet | Couche Internet |
| Couche de Liaison de Données | Cadre | Couche d’Accès au Réseau | |
| Couche Physique | Bit |
Par exemple, lorsqu’un utilisateur demande à naviguer sur un site Web sur l’ordinateur, le logiciel du serveur à distance donne d’abord les données demandées à la couche application, où elles sont traitées de couche en couche, chaque couche remplissant ses fonctions désignées. Les données sont ensuite transmises sur la couche physique du réseau jusqu’à ce que le serveur de destination ou un autre périphérique les reçoive. À ce stade, les données sont à nouveau transmises à travers les couches, chaque couche effectuant ses opérations assignées jusqu’à ce que les données soient utilisées par le logiciel récepteur.
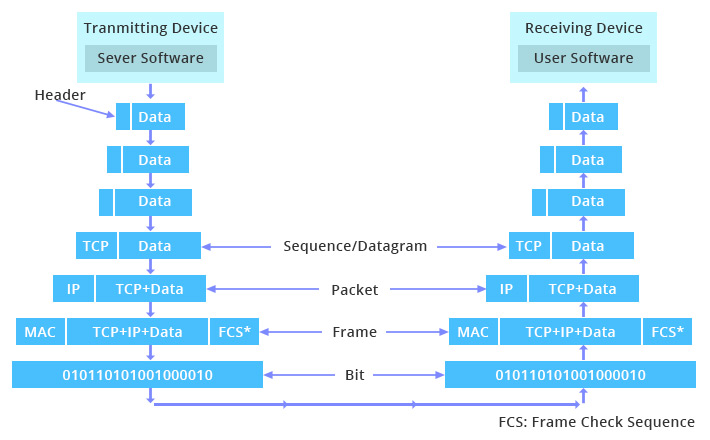
Figure : les données circulent des couches supérieures aux couches inférieures, chaque couche ajoute un en-tête / pied de page au PDU.
Pendant la transmission, chaque couche ajoute un en-tête, ou pied de page, ou les deux au PDU provenant de la couche supérieure, qui dirige et identifie le paquet. Ce processus s’appelle l’encapsulation. L’en-tête (et le pied de page) et les données forment ensemble le PDU pour la couche suivante. Le processus se poursuit jusqu’à atteindre la couche du plus bas niveau (couche physique ou couche d’accès au réseau), à partir duquel les données sont transmises au dispositif de réception. Le dispositif de réception inverse le processus, désencapsulant les données à chaque couche avec les informations d’en-tête et de pied de page dirigeant les opérations. Ensuite, l’application utilise enfin les données. Le processus se poursuit jusqu’à ce que toutes les données soient transmises et reçues.
L’importance de TCP/IP et OSI pour le dépannage
Avec la connaissance de la division des couches, nous pouvons diagnostiquer le problème en cas d’échec d’une connexion. Le principe est de vérifier à partir du niveau le plus bas, plutôt qu’à partir du niveau le plus élevé. Parce que chaque couche sert pour la couche supérieure à celle-ci, et il sera plus facile de traiter les problèmes de couche inférieure. Par exemple, si votre ordinateur ne peut pas se connecter à Internet, la première chose que vous devez faire est de vérifier si le câble réseau est branché sur votre ordinateur, ou si le point d’accès sans fil (WAP) est connecté au commutateur, ou si les broches des connecteurs RJ45 sont en bon état.
Modèle TCP/IP vs. Modèle OSI
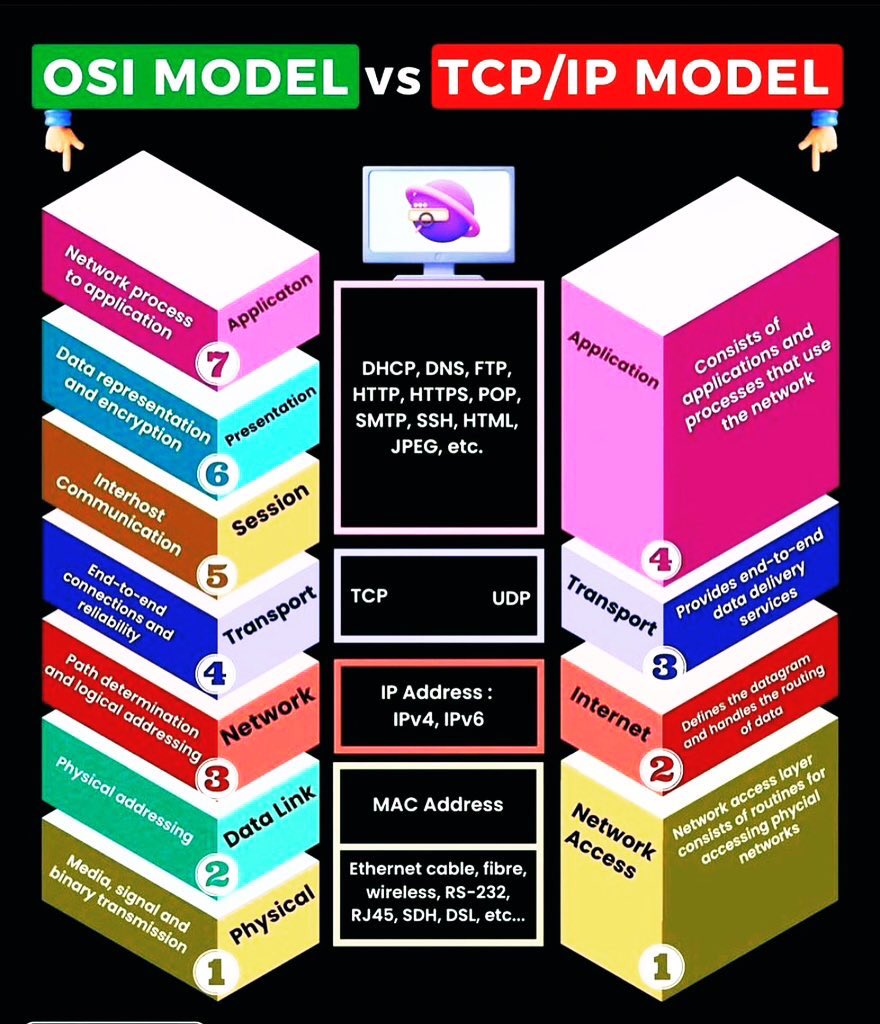
Le modèle TCP/IP est plus ancien que le modèle OSI. La figure suivante montre les relations correspondantes entre leurs couches.
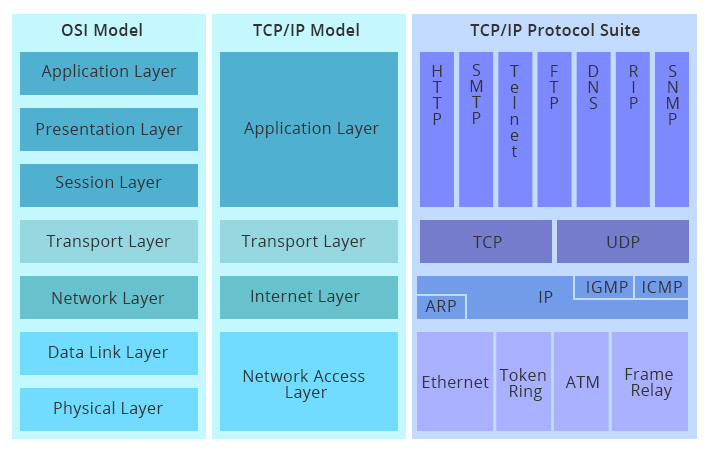
En comparant les couches du modèle TCP/IP et du modèle OSI, la couche d’application du modèle TCP/IP est similaire aux couches OSI 5, 6 et 7 combinées, mais le modèle TCP/IP n’a pas de couche de présentation ou couche de session distincte. La couche de transport de TCP/IP englobe les responsabilités de la couche de transport OSI et certaines des responsabilités de la couche de session OSI. La couche d’accès au réseau du modèle TCP/IP englobe la liaison de données et les couches physiques du modèle OSI. Notez que la couche Internet du protocole TCP/IP ne profite pas des services de séquençage et d’acquittement qui pourraient être présents dans la couche de liaison de données du modèle OSI. La responsabilité est à la couche de transport dans le modèle TCP/IP.
Compte tenu de la signification des deux modèles de référence, le modèle OSI n’est qu’un modèle conceptuel. Il est principalement utilisé pour la description, la discussion et la compréhension des fonctions individuelles des réseaux. Cependant, TCP/IP est d’abord conçu pour résoudre un ensemble spécifique de problèmes, et non pour fonctionner comme une description de génération pour toutes les communications réseau en tant que modèle OSI. Le modèle OSI est générique, indépendant du protocole, mais la plupart des protocoles et des systèmes y adhèrent, tandis que le modèle TCP/IP est basé sur des protocoles standard que l’Internet a développés. Une autre chose à noter dans le modèle OSI est que toutes les couches ne sont pas utilisées dans des applications plus simples. Alors que les couches 1, 2, 3 sont obligatoires pour toute communication de données, l’application peut utiliser une couche d’interface unique à l’application au lieu des couches supérieures habituelles du modèle.
Conclusion
Le modèle TCP/IP et le modèle OSI sont tous deux des modèles conceptuels utilisés pour la description de toutes les communications réseau, tandis que TCP/IP lui-même est également un protocole important utilisé dans toutes les opérations Internet. Généralement, lorsqu’on parle de la couche 2, de la couche 3 ou de la couche 7 dans laquelle un périphérique réseau fonctionne, nous faisons référence au modèle OSI. Le modèle TCP/IP est utilisé à la fois pour modéliser l’architecture Internet actuelle et pour fournir un ensemble de règles qui sont suivies par toutes les formes de transmission sur le réseau.
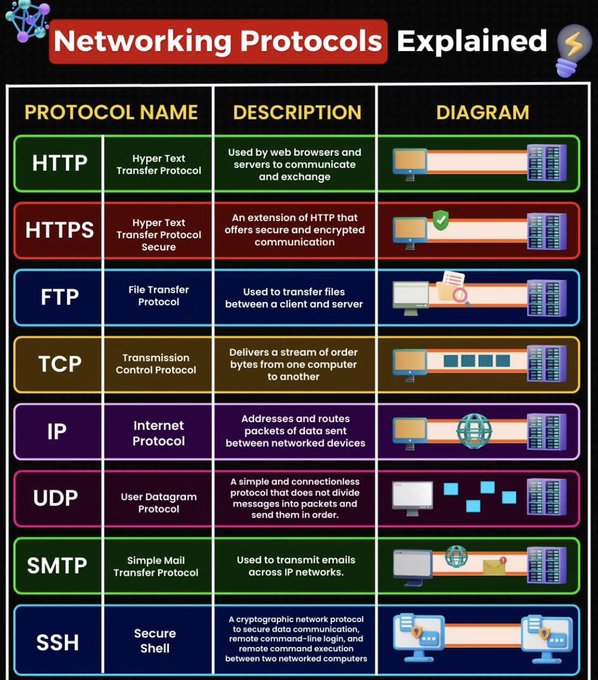
OSI et protocoles :
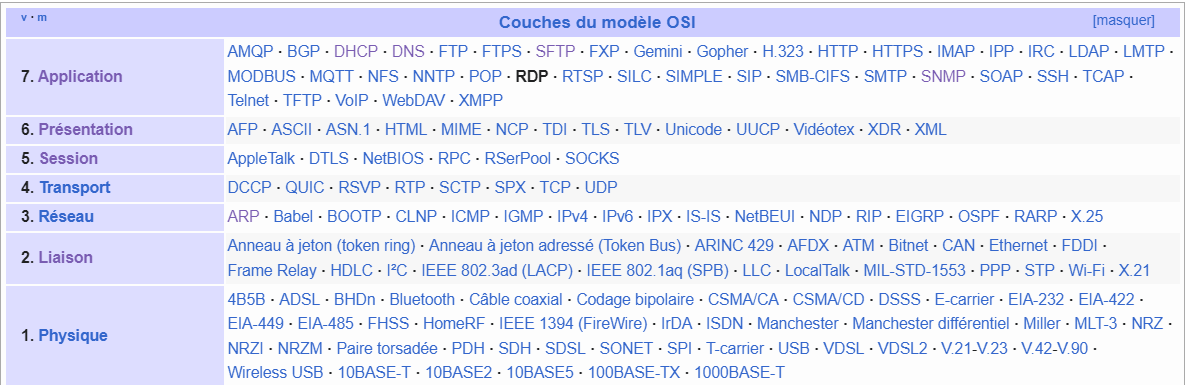
STP
STP est un protocole de gestion de liens conçu pour prendre en charge les liens redondants qui arrêtent les boucles de commutation dans le réseau STP. Il s’agit d’un protocole de couche 2 qui s’exécute sur des ponts et des commutateurs, qui doivent être activés sur les interfaces des commutateurs. Protocoles STP normalisés IEEE comme IEE 802.1D. La forme complète de STP est le Spanning Tree Protocol.
| Standard | Description | Abréviation |
|---|---|---|
| IEEE 802D. |
Prévention de boucle
Reconfiguration automatique de l’arborescence en cas de modification Convergence lente (jusqu’à 50 bps) |
STP |
SSL et TLS
Signification de SSL et TLS
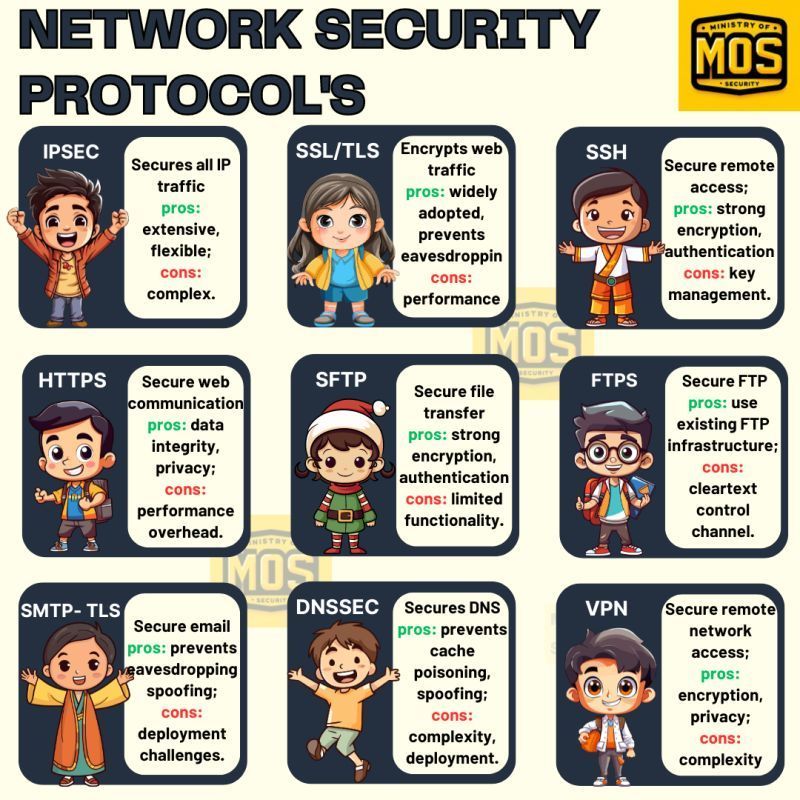
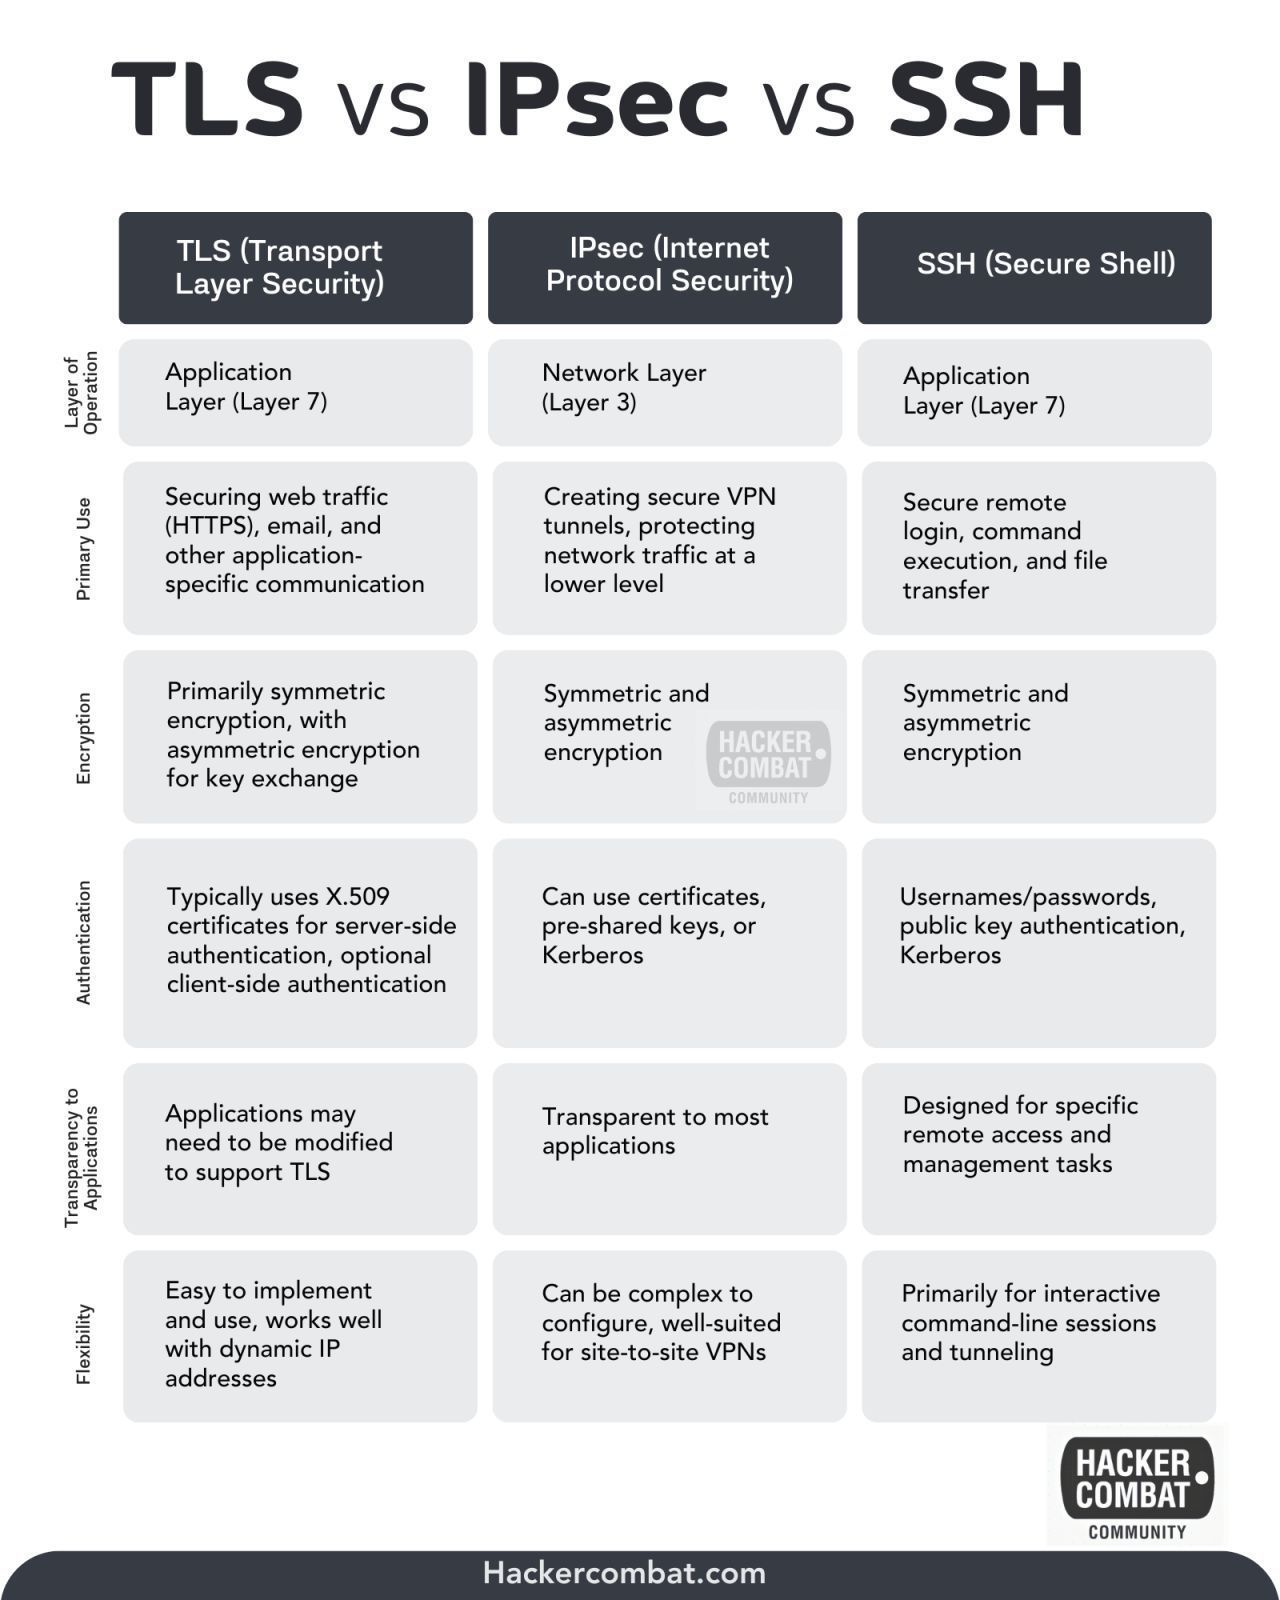
SSL signifie « Secure Socket Layer » et TLS « Transport Layer Security ». Les deux sont des protocoles de chiffrement pour la couche de transport d’Internet. Leur tâche est de procéder au chiffrement des flux de données entre le client et le serveur.
Lorsque la communication est effectuée via cette couche de transport chiffrée, un « s » est ajouté au nom du protocole : http devient https, imap devient imaps, etc. On rencontre également l’abréviation SSL lorsqu’on parle de certificat SSL. Ce certificat est nécessaire lorsqu’un site internet souhaite communiquer via https ce qui est aujourd’hui le cas de la grande majorité des sites internet.
Différence entre SSL et TLS
Le SSL a été introduit en 1995. Après la découverte d’une série de lourdes failles de sécurité, la version 2.0 améliorée a ensuite vu le jour puis la version 3.0 l’année suivante. Plus tard, l’IETF (l’Internet Engineering Task Force, chargée du développement d’Internet) a rejeté SSL 3.0 après la découverte de nouvelles failles de sécurité.
Par conséquent, le TLS actuel est plus sûr, plus flexible et plus efficace que l’ancien SSL. Toutefois, comme l’abréviation « SSL » est aujourd’hui nettement plus connue que « TLS », de nombreux fournisseurs de logiciels client, de routeurs, etc. utilisent le terme SSL ou le double terme SSL/TLS alors qu’ils entendent généralement la version actuelle de TLS, à savoir TLS 1.3.
SSL ou TLS : lequel utiliser ?
De nos jours, seul TLS est utilisé. SSL 2.0 et SSL 3.0 sont obsolètes et pas considérés comme sûrs. Il en va de même des anciennes versions de TLS. Aujourd’hui, vous pouvez uniquement utiliser TLS 1.2 sous certaines conditions listées dans la spécification de TLS 1.3. En revanche, évitez tous les protocoles SSL
Vidéo intéressante : SSL/TLS mais aussi explication clé symétrique et asymétrique :
https://www.youtube.com/watch?v=7W7WPMX7arI
Cloud, différentes formes :
Quels sont les trois modèles de services de cloud computing ?
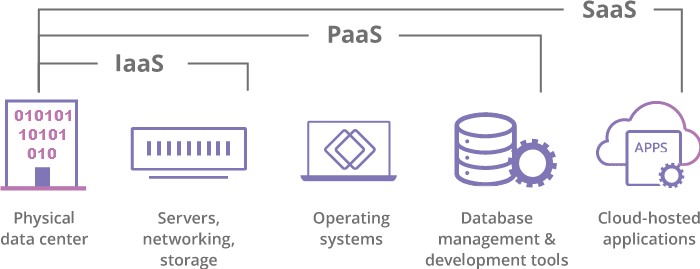
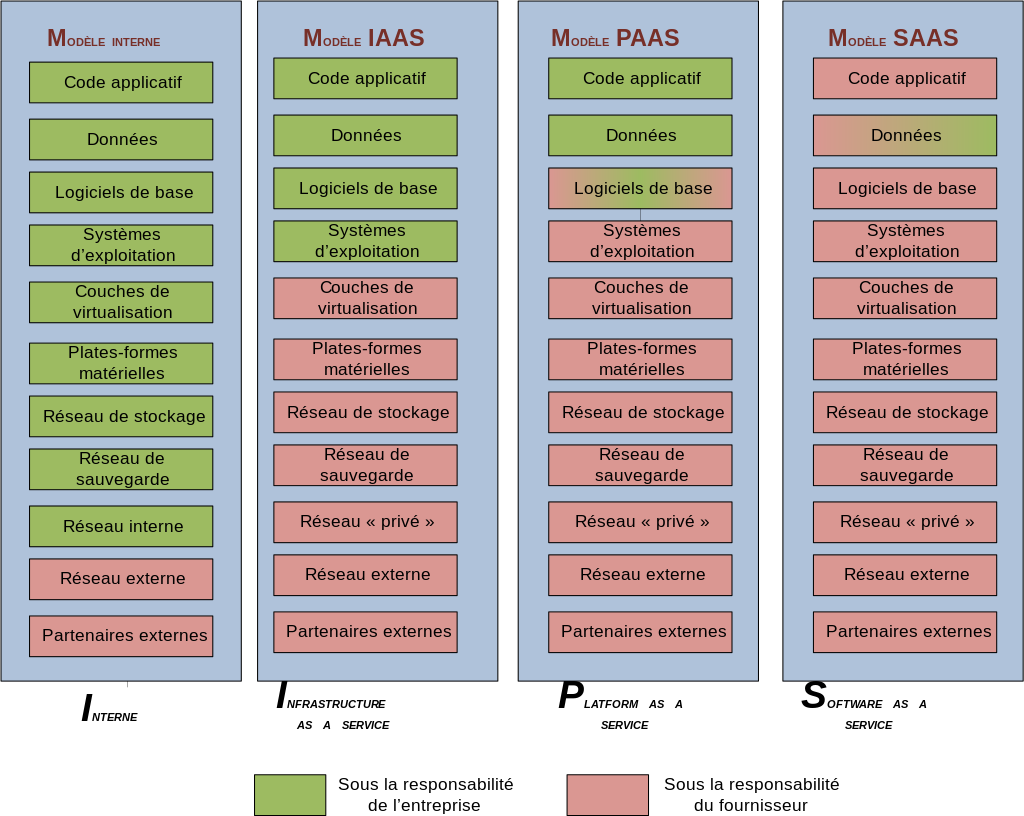
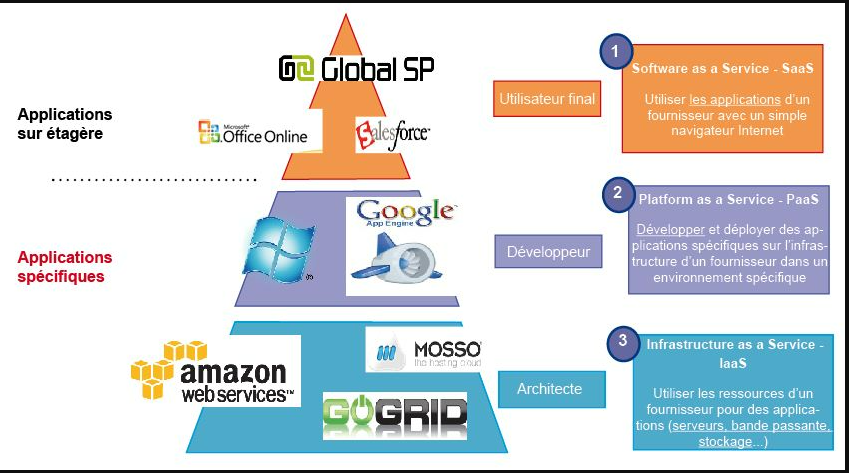
Software-as-a-Service (SaaS) : plutôt que de faire installer une application aux utilisateurs sur leurs appareils, les applications SaaS sont hébergées sur des serveurs cloud et les utilisateurs y accèdent via Internet. Les services SaaS s’apparentent à la location d’une habitation : le propriétaire entretient l’habitation, tandis que le locataire l’utilise comme si elle lui appartenait. Parmi les exemples d’applications SaaS, on citera Salesforce, MailChimp et Slack.
Platform-as-a-Service (PaaS) : dans ce modèle, les entreprises ne paient pas pour les applications hébergées. Elles paient pour les éléments dont elles ont besoin pour créer leurs propres applications. Les fournisseurs de PaaS proposent tout ce qui est nécessaire pour construire une application, y compris les outils de développement, l’infrastructure et les systèmes d’exploitation, sur Internet. Le PaaS peuvent être comparé à la location des outils et des équipements pour construire une maison, au lieu d’en louer une. Parmi les exemples de services PaaS, on citera notamment Heroku et Microsoft Azure.
Infrastructure-as-a-Service (IaaS) : dans ce modèle, une entreprise loue les serveurs et l’espace de stockage dont elle a besoin à un fournisseur de cloud. Elle peut alors utiliser cette infrastructure cloud pour développer ses propres applications. L’approche IaaS s’apparente à la location d’un terrain par une entreprise : cette dernière peut y construire tout ce qu’elle souhaite, mais elle doit fournir ses propres équipements et matériaux de construction. Parmi les fournisseurs de services IaaS, on citera DigitalOcean, Google Compute Engine et OpenStack.
Auparavant, le SaaS, le PaaS et l’IaaS étaient les trois principaux modèles de cloud computing, et pratiquement tous les services cloud entraient dans l’une de ces catégories. Toutefois, ces dernières années a emergé un quatrième modèle :
Function-as-a-Service (FAAS) : le modèle FaaS (également connu sous le nom de serverless computing pu informatique sans serveur) divise les applications cloud en composants plus petits, uniquement exécutés en cas de besoin. Imaginez qu’il soit possible de louer une maison une pièce à la fois. Le locataire ne louerait, par exemple, que la salle à manger au moment des repas, la chambre quand il va dormir et le salon quand il regarde la télévision, sans avoir à régler le loyer correspondant lorsqu’il n’utilise pas ces pièces.
À l’instar de tous les autres modèles d’informatique cloud, les applications FaaS ou serverless s’exécutent néanmoins toujours sur des serveurs. Toutefois, on les définit comme « serverless », car elles ne s’exécutent pas sur des machines dédiées et que les entreprises qui développent ces applications n’ont aucun serveur à gérer.
Par ailleurs, les fonctions serverless peuvent évoluer ou être dupliquées lorsqu’un nombre plus élevé d’utilisateurs se servent de l’application. Imaginez que la salle à manger du locataire puisse s’agrandir à la demande lorsque de nouveaux convives se joignent à lui
pour le dîner ! En savoir plus sur l’informatique serverless (FaaS).
Les types de réseaux : LAN, MAN, WAN, et PAN
LAN, qui signifie Local Area Network, est ce que l’on appelle le réseau local. Plus précisément, il s’agit du réseau informatique avec une portée limitée : le réseau informatique de votre habitation ou de votre organisation. Effectivement, à la maison, le réseau où sont connectés votre box, votre ordinateur et votre smartphone, c’est un LAN. Quand vous accédez à Internet, vous sortez du LAN pour atteindre le… WAN, que nous allons découvrir ensuite. Dans le même esprit, le réseau d’une entreprise même s’il s’étend sur plusieurs bâtiments, plusieurs étages, et qu’ils connectent plusieurs dizaines ou centaines d’ordinateurs, imprimantes, etc… est un réseau de type « LAN ».
Sur un réseau local, les connexions sont assurées par des câbles Ethernet (RJ45), des fibres optiques et des connexions sans-fil via le Wi-Fi. Le type de support est sélectionné en fonction des besoins et des types d’appareils à connecter (un ordinateur avec un switch, un serveur avec un switch, deux switchs entre eux, etc.).
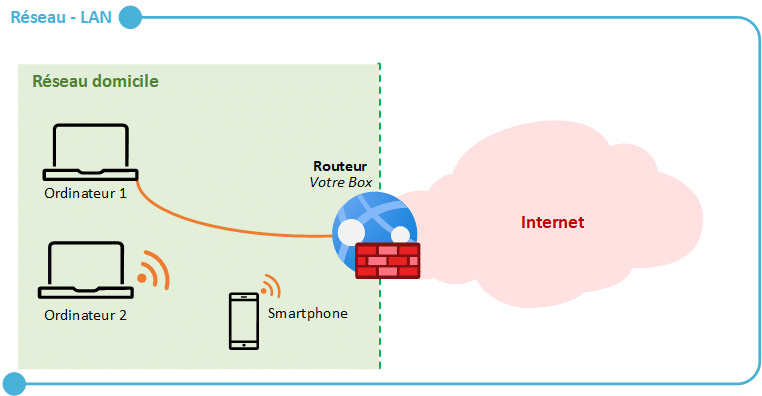
Voici un schéma d’un réseau LAN très simple, mais finalement qui reproduit ce que vous pouvez avoir à la maison
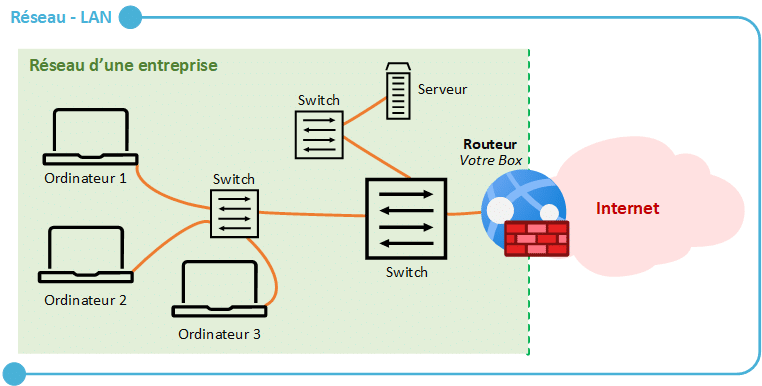
En entreprise, nous retrouvons généralement des réseaux avec un plus grand nombre d’équipements, mais on reste sur un LAN.
J’insiste sur le fait que, le réseau LAN est connecté à Internet, par l’intermédiaire du routeur, mais en aucun cas Internet ne fait partie du LAN.
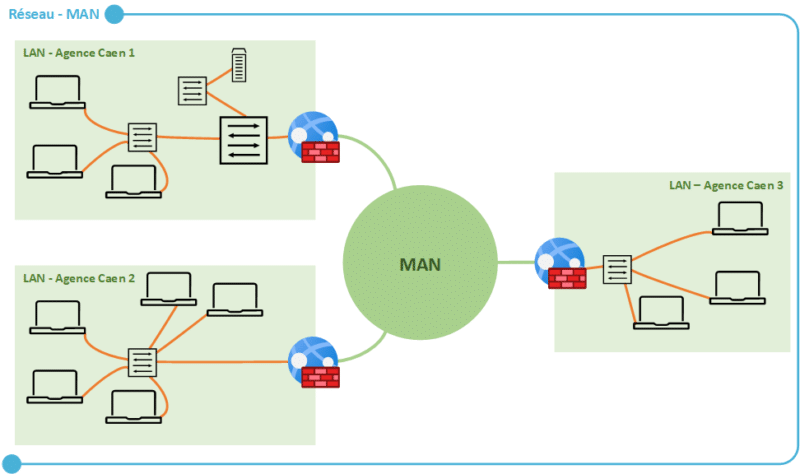
MAN pour Metropolitan Area Network est un réseau dont l’étendue est de plusieurs dizaines de kilomètres, donc on peut considérer que c’est un réseau à l’échelle d’une ville entière. L’objectif d’un réseau MAN est d’interconnecter plusieurs réseaux LAN par l’intermédiaire de liaison à très haut débit grâce à la fibre optique et ce que l’on appelle une dorsale haute capacité (backbone). En fait, ces différents réseaux locaux (LAN) dispersés dans une ville sont physiquement reliés entre eux pour constituer le réseau MAN.
Nous pouvons prendre l’exemple d’une entreprise qui dispose de trois agences réparties dans la ville et interconnectées afin de former un réseau MAN. Ce réseau MAN mène également à Internet. Dans ce cas, les serveurs peuvent être regroupés sur une seule agence et être accessibles depuis l’ensemble des agences de l’entreprise.
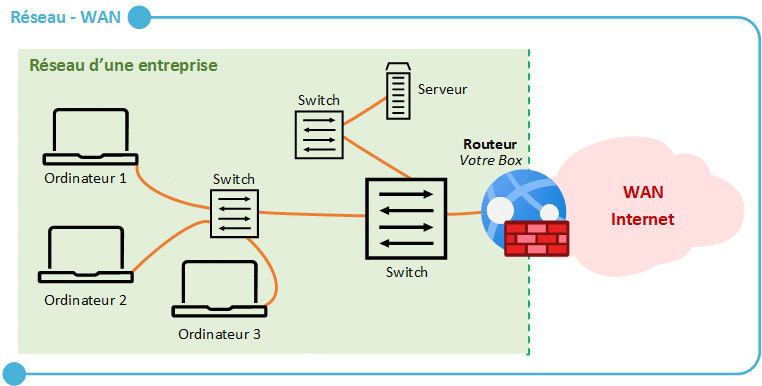
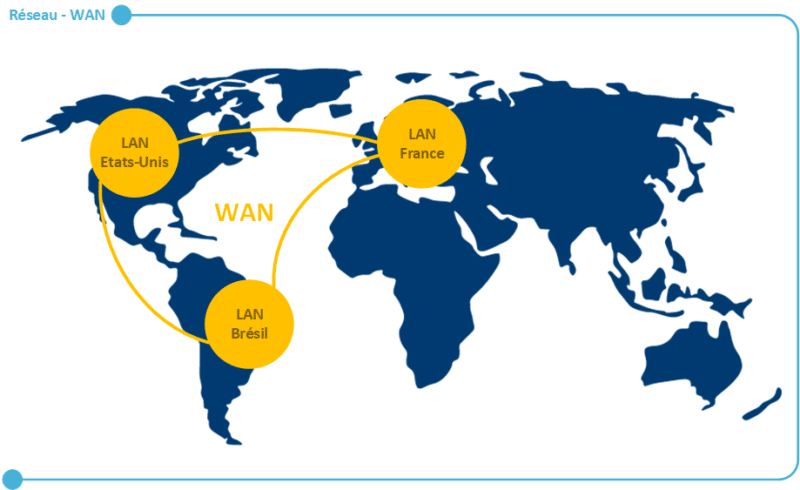
WAN pour Wide Area Network correspond à un réseau étendu, et il s’agit d’un réseau étendu à l’échelle d’un pays ou d’un continent puisqu’il peut couvrir des centaines ou des milliers de kilomètres ! De ce fait, il couvre une zone plus large que le LAN et le MAN.
Il faut savoir qu’Internet est considéré comme un WAN public. En fait, un réseau WAN est un réseau longue distance comme c’est le cas du réseau de certaines grandes entreprises et de fournisseurs d’accès à Internet. Les communications sur un réseau WAN s’appuient de la fibre optique, des liaisons satellites, mais aussi des câbles sous-marins afin de relier les continents entre eux. Même si elles ne sont plus utilisées en priorité, il ne faut pas oublier les liaisons cuivre (ADSL, VDSL, SDSL).
Le terme WAN est très souvent utilisé au sein des logiciels, sur les équipements réseau, etc… Pour identifier la carte réseau qui mène à l’extérieur du réseau, en faisant référence bien souvent à Internet, c’est-à-dire à un réseau WAN. Si l’on se positionne au niveau d’un réseau local comme celui que nous avons à la maison, dès que l’on sort de ce réseau, pour atteindre Internet par exemple, nous atteignons un réseau WAN.
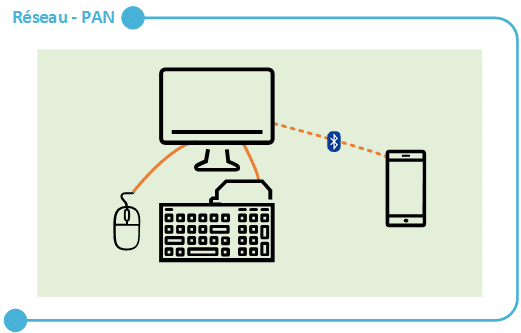
PAN pour Personal Area Network correspond à un réseau à l’échelle d’une personne, et on parle aussi de WPAN lorsqu’il s’agit de connexions sans-fil. Qu’est-ce que cela signifie ? Un réseau PAN correspond à la connexion entre plusieurs appareils tel qu’un ordinateur et un périphérique connecté USB, ou un smartphone connecté à une paire d’écouteurs Bluetooth. Comme autres méthodes de connexion, on peut citer la technologie NFC, le protocole ZigBee utilisé par des objets connectés ou encore l’infrarouge (IrDA). Lors d’une synchronisation directe entre deux appareils, par exemple deux ordinateurs, on parle également d’un réseau PAN.
En conclusion :
- LAN – Local Area Network : réseau à l’échelle d’une maison, d’un appartement, d’un bâtiment, d’un campus, d’une école ou encore d’une agence
- MAN – Metropolitan Area Network : réseau à l’échelle d’une ville
- WAN – Wide Area Network : réseau à l’échelle d’un pays, d’un continent, dont le meilleur exemple est Internet
- PAN – Personal Area Network : réseau à l’échelle d’une seule personne
https://www.youtube.com/watch?v=c0Xj09s5hYA&t=33s
VLAN
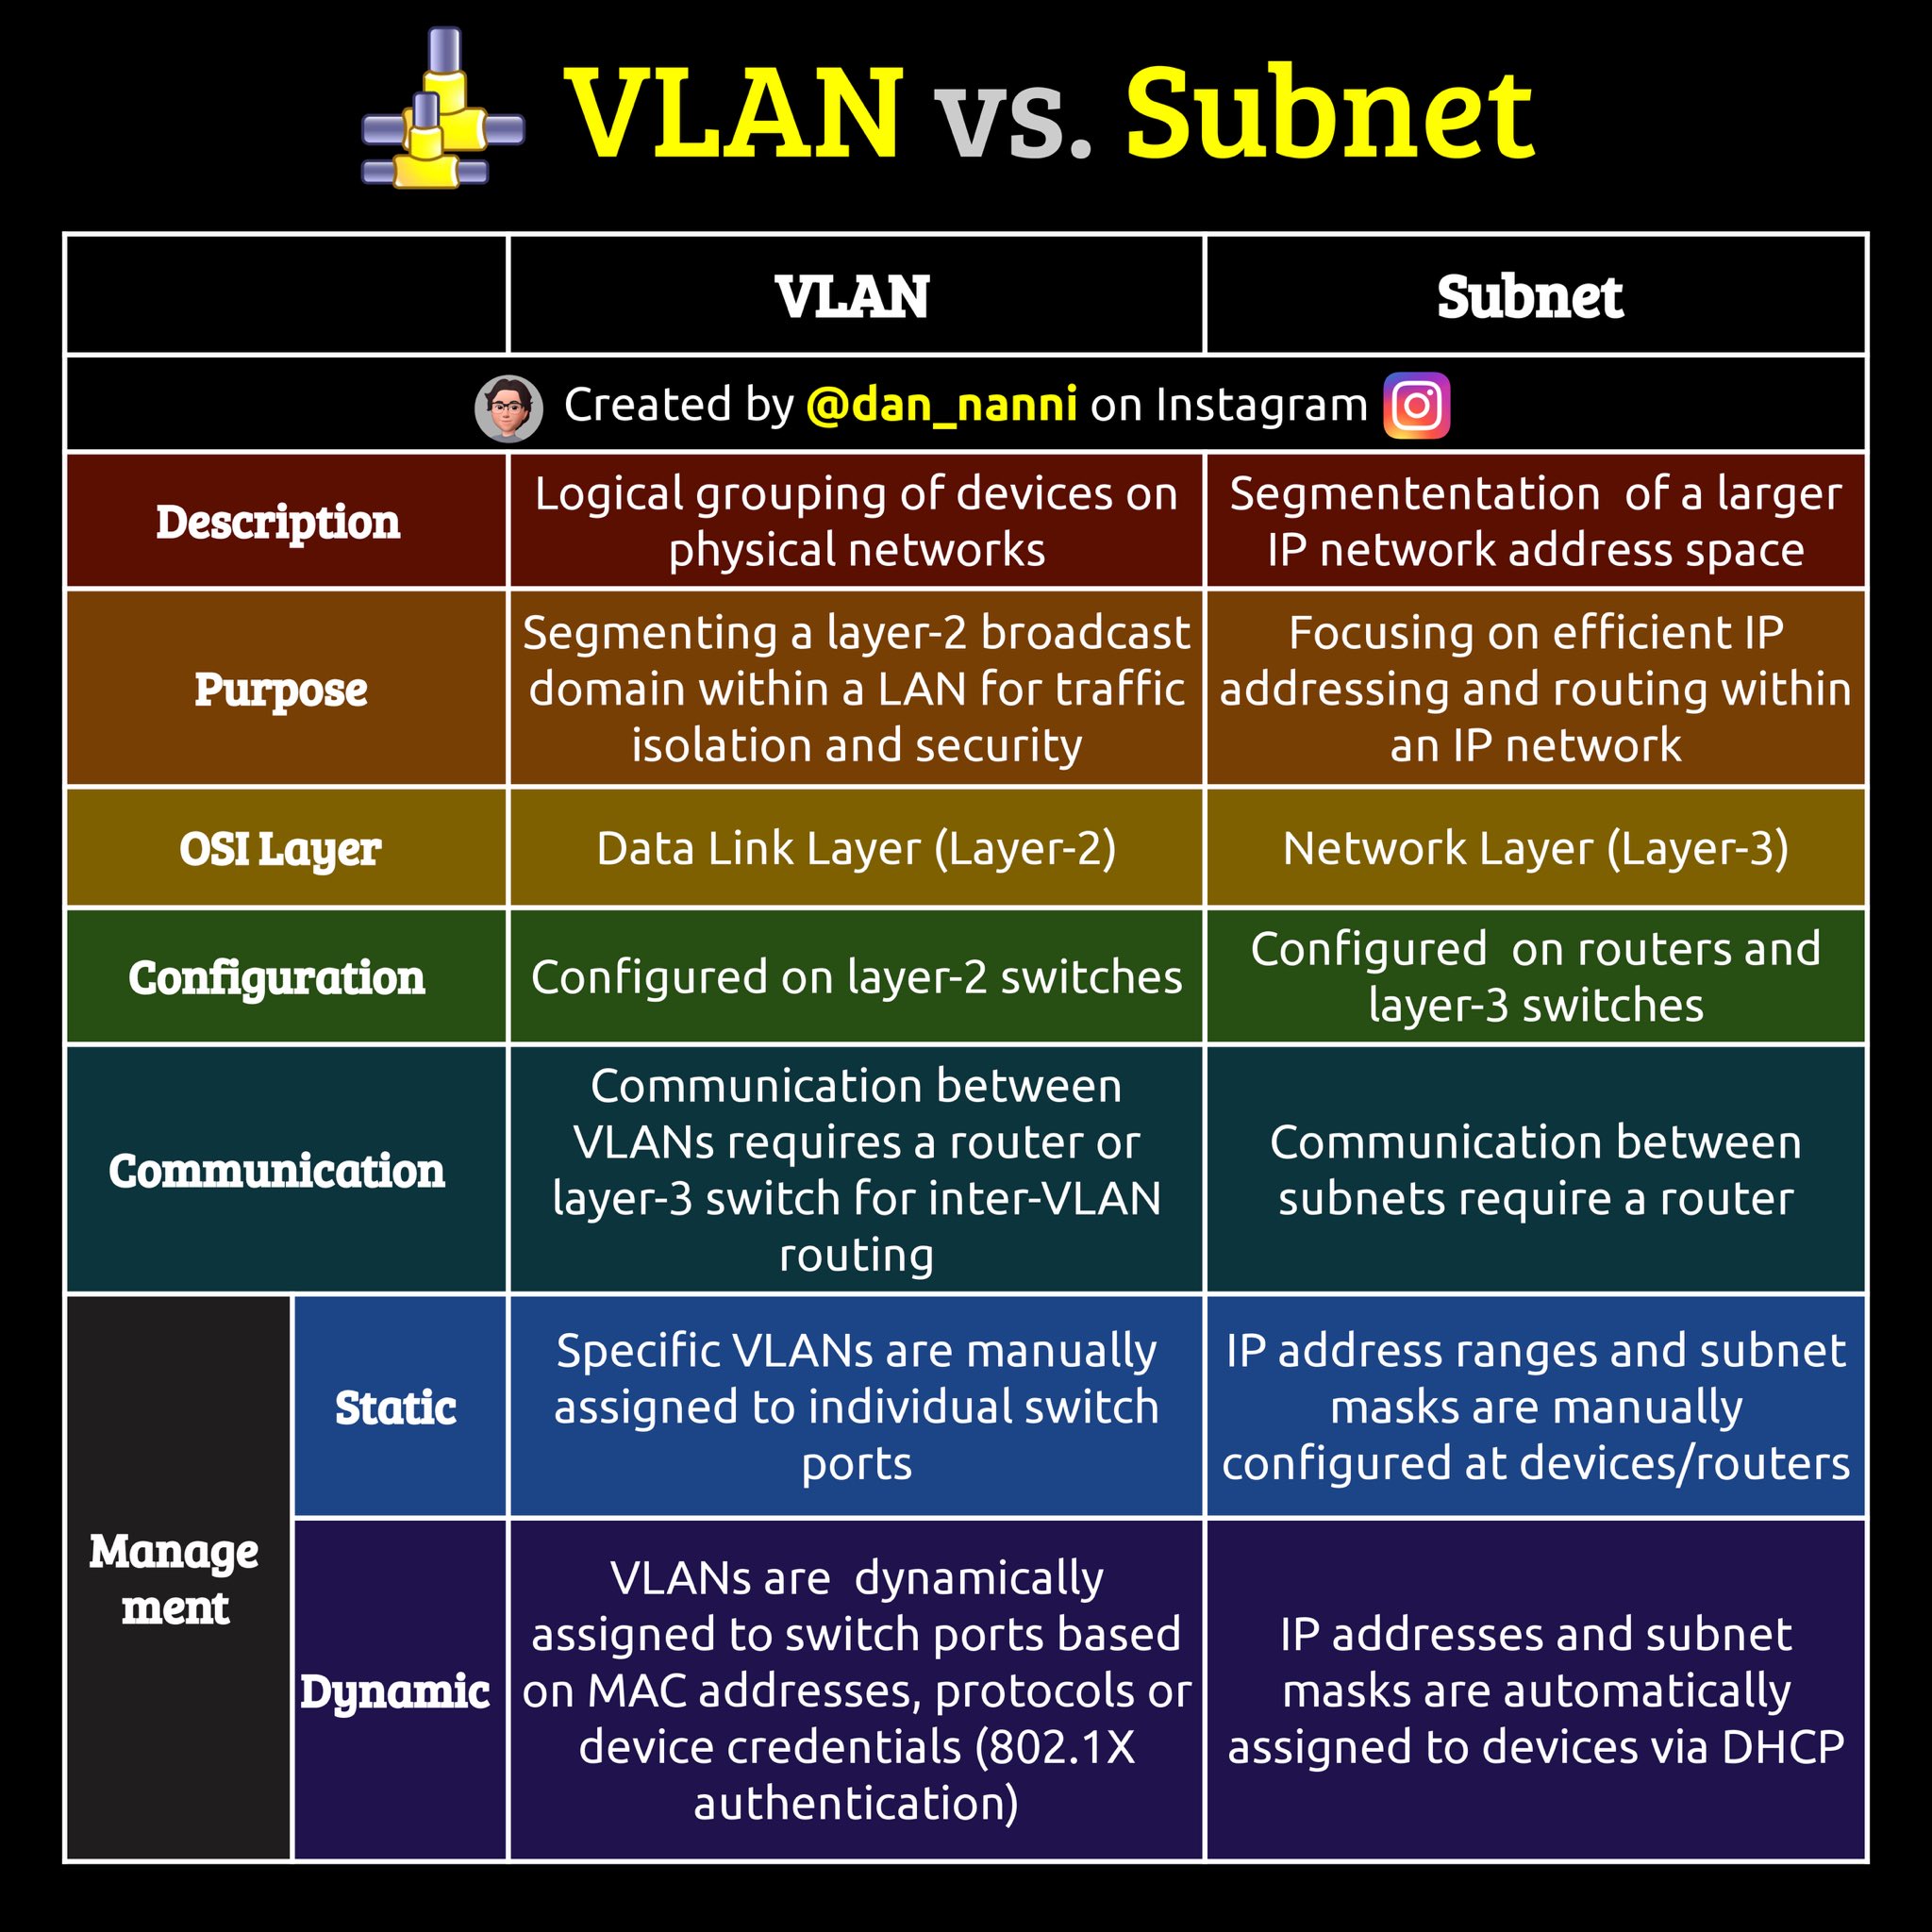
Si on compare un switch à un immeuble, on peut expliquer assez simplement la notion de VLAN.
Tout d’abord que veut dire le mot VLAN ?
Vlan veut dire Virtual local area network … en d’autres mots : réseau local virtuel.
Il s’agit, sur un même switch de créer plusieurs réseaux indépendants ne pouvant pas, par défaut, communiquer entre eux.
Dans notre exemple, un switch est comme un grand immeuble avec plusieurs appartements.
Chaque appartement créé correspond à un Vlan.
Donc si notre immeuble contient 4 appartements, cela correspond à 4 Vlans sur notre switch.
Chaque occupant d’un appartement est indépendant de son voisin avec qui il ne communique pas.
Chacun peut faire ce qu’il veut dans son appartement sans que le voisin ne puisse le voir ou communiquer avec lui.
Access lists :
Si l’occupant d’un appartement veut aller dans celui de son voisin, il doit avoir l’autorisation d’y entrer. Sur un switch utilisant des VLANs, ceci est possible en créant des ACLs (Access lists) qui correspondent à des lignes de commandes permettant à un vlan de communiquer avec un autre Vlan. Ainsi, les occupants de l’appartement 1 peuvent voir les occupants de l’appartement 2 mais pas ceux des appartements 3 et 4 …
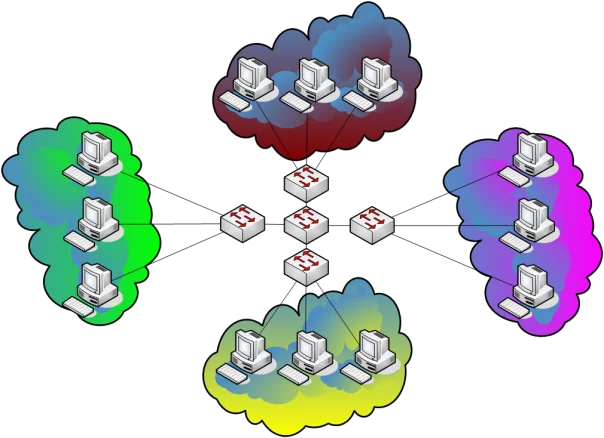
Par exemple, les entités branchés sur les ports du switch qui sont configurés dans le VLAN 2 pourront communiquer entre eux et c’est tout. Tous les autres ports du switch qui n’appartiennent pas au VLAN 2 ne pourront pas communiquer avec ceux du VLAN 2.
Dans le schéma ci dessous, on a segmenté les PC par groupe de 3. La communication entre PC appartenant au VLAN vert est possible mais aucune communication ne pourra sortir de ce VLAN vert pour atteindre d’autres PC du réseau.
Les différentes utilisations de VLAN
Maintenant qu’on sait à quoi sert le VLAN, on peut l’utiliser en fonction de nos besoins. On peut lister les différents VLANs qu’on aura besoin dans un réseau d’une entreprise classique :
1 VLAN pour le service commercial, 1 VLAN pour le service administratif, 1 VLAN pour le service ingénierie…
1 VLAN pour le service de téléphonie sur IP
1 VLAN pour le service de visioconférence
1 VLAN pour l’administration réseau (important, on va mettre les équipements réseau, switch, routeur… dans un VLAN dédié uniquement accessible aux stations des administrateurs réseau)
…
Appartenance à un VLAN
Comment configurer un VLAN et attribuer des entités dans ce VLAN ?
Il y a plusieurs solutions dont voici les 3 principales :
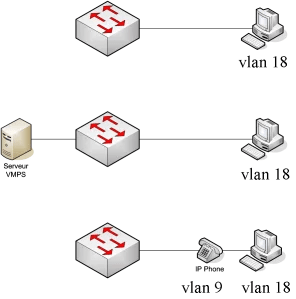
La première solution est celle la plus utilisée : On créé le VLAN sur le switch puis on attribue ce VLAN sur les ports souhaités. Par exemple sur le 1er schéma, le port du switch qui est branché au PC est configuré pour être dans le VLAN 18.
Seconde solution beaucoup moins utilisée : On configure le switch pour qu’il récupère l’adresse MAC qu’il voit transiter sur le port, puis envoi cette adresse MAC vers un serveur VMPS (VLAN Membership Policy Server) qui fait le lien entre l’adresse MAC et le VLAN attribué via une base de données. Le serveur VMPS indique au switch quel VLAN il faut attribuer au port. Le principal inconvénient vient de la fragilité du serveur ; s’il tombe en panne, tout le réseau est bloqué !
Dernière solution très utilisé dans le cas d’un réseau avec téléphonie sur IP. On utilise la 1ère solution pour attribuer le VLAN au PC. Pour le téléphone sur IP, on utilise le protocole CDP (Cisco Discovery Protocol) pour attribuer le VLAN voix uniquement au trafic voix.
Remarques
Le nombre maximum de VLAN que l’on peut créer dépend du type de switch (64, 128, 1024, 4096)
Le VLAN 1 est créé par défaut et tous les ports du switch appartiennent à ce VLAN
Il faut d’abord créer l’identifiant du VLAN puis attribuer des ports dans ce VLAN
On peut donner un nom à un VLAN (optionnel), par exemple :
VLAN 1 – Management
VLAN 2 – Commerciaux
VLAN 3 – Voix
VLAN 4 – Finance
https://www.youtube.com/watch?v=Eh9INNkMM4I&list=PLP0aqyZ5GFdlb7MtCHYNZwUlGhY1BkMS_&index=4
Firewall
Un pare-feu, (de l’anglais firewall) est un logiciel et/ou matériel permettant de faire respecter la politique de sécurité de réseaux, celle-ci définissant quels sont les types de communications autorisés sur un réseau informatique. Il surveille et contrôle les applications et les flux de données (paquets).
Un pare-feu peut être matériel ou logiciel, de type SaaS (logiciels utilisés comme un service), ou hébergé dans un cloud public ou privé (virtuel).
Un pare-feu est parfois appelé coupe-feu, garde-barrière, barrière de sécurité, ou encore firewall. Traduction littérale : pare-feu.
Il est possible de définir des règles de filtrage plus détaillées pour le HTTPS avec le déchiffrement SSL (nécessite la présence d’un certificat côté client).
Il a pour principale tâche de contrôler le trafic entre différentes zones de confiance, en filtrant les flux de données qui y transitent. Généralement, les zones de confiance incluent Internet (une zone dont la confiance est nulle) et au moins un réseau interne (une zone dont la confiance est plus importante).
Le but est de fournir une connectivité contrôlée et maîtrisée entre des zones de différents niveaux de confiance, grâce à l’application de la politique de sécurité et d’un modèle de connexion basé sur le principe du moindre privilège.
Un pare-feu fait souvent office de routeur et permet ainsi d’isoler le réseau en plusieurs zones de sécurité appelées zones démilitarisées ou DMZ. Ces zones sont séparées suivant le niveau de confiance qu’on leur porte.
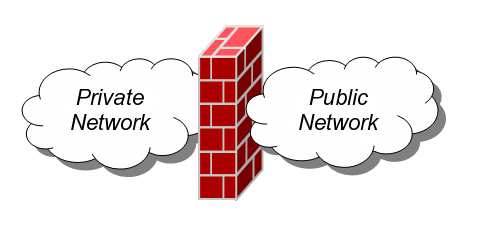
Un pare-feu, représenté par un mur de briques, pour cloisonner le réseau privé.
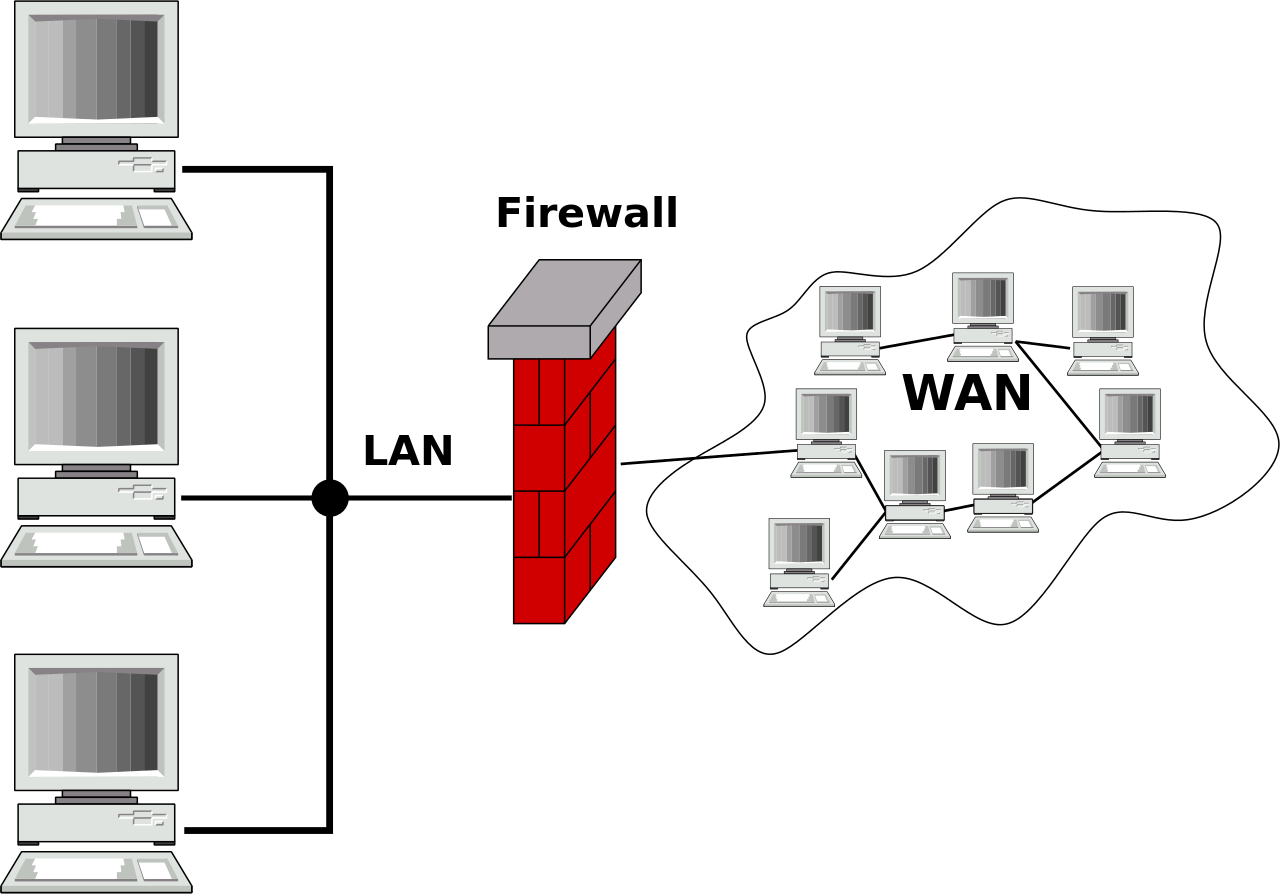
Pare-feu passerelle entre LAN et WAN.
.
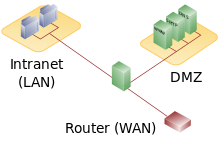
Pare-feu routeur, avec une zone DMZ.
https://www.youtube.com/watch?v=6Swt51w3EjY&t=14s
https://www.youtube.com/watch?v=mY-TvNXFHl0
RAID
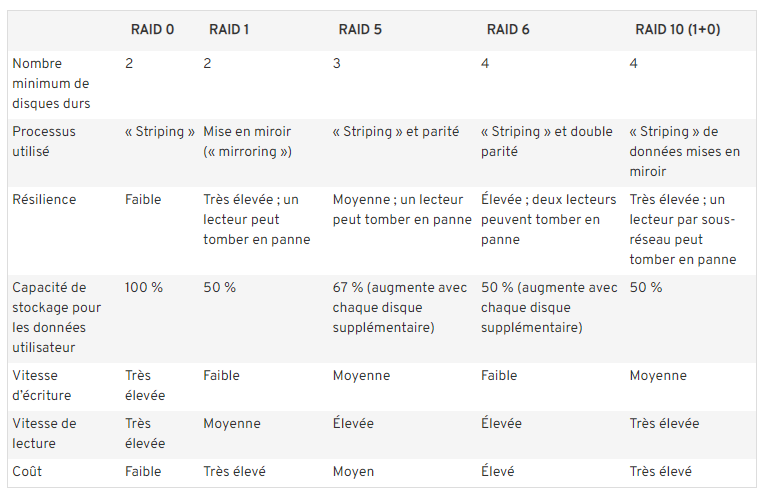
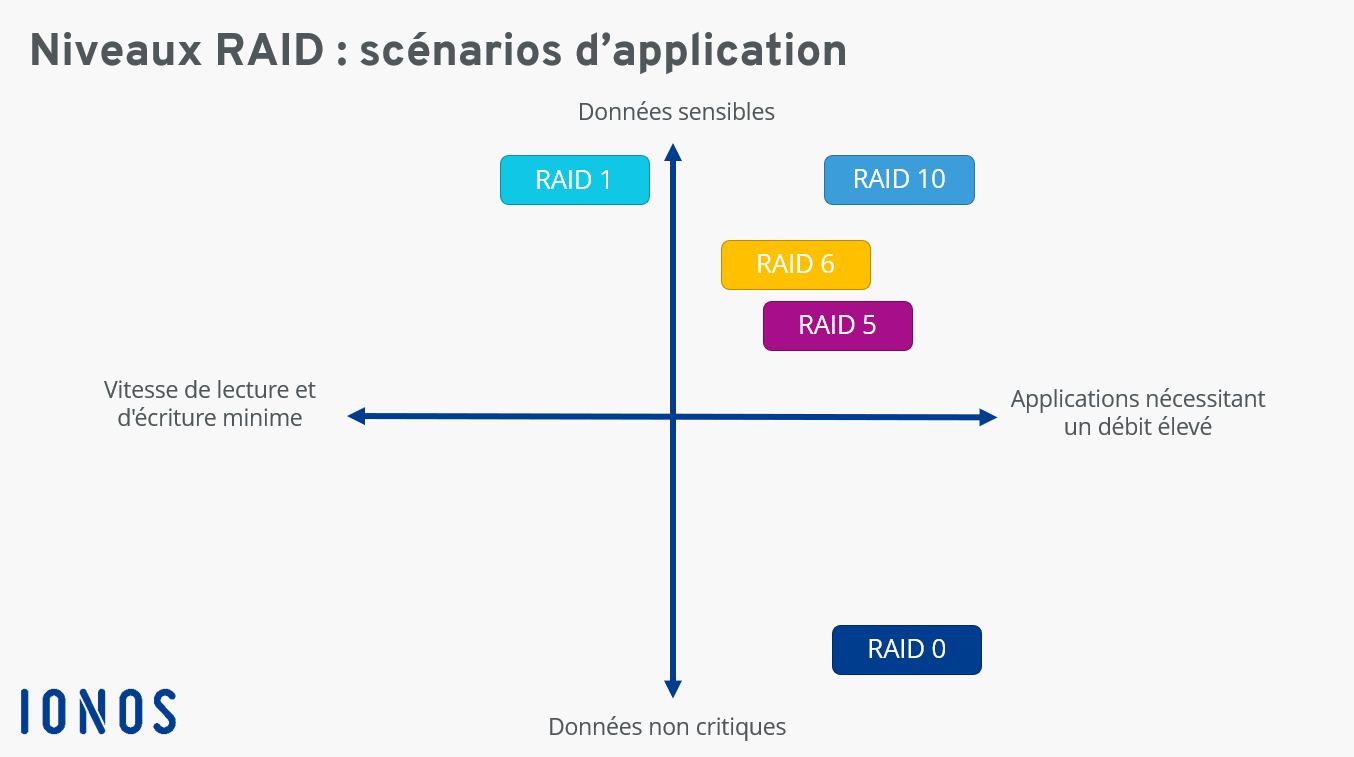
RAID (Redundant Array of Independent Disks) désigne l’action de créer une matrice contenant un minimum de deux solutions de stockage différentes et formant un seul grand disque logique.
Sa fonction spécifique est déterminée par la configuration de ses disques durs respectifs, également appelée « niveau RAID ».
Voici les principales propriétés au niveau desquelles les niveaux RAID diffèrent aujourd’hui les uns des autres :
- Niveau de résilience
- Vitesse de lecture (débit de sortie)
- Vitesse d’écriture (débit d’entrée)
- Utilisation de la capacité de stockage disponible
- Nombre minimum de disques durs nécessaires
https://www.youtube.com/watch?v=WqGeTOt6A0Q
MBR/GPT
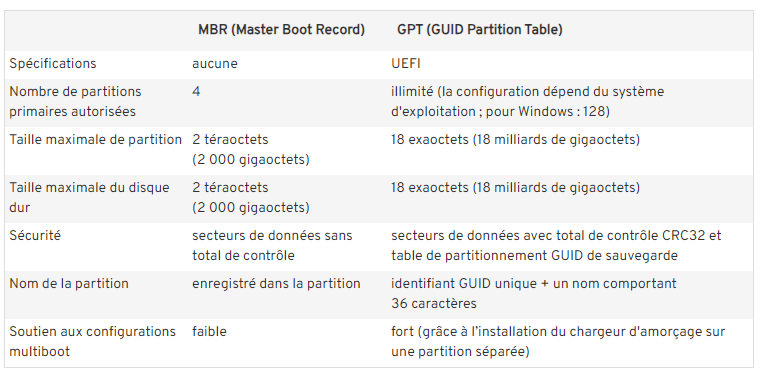
MBR (Master Boot Record) et GPT (GUID Partition Table) sont deux manières différentes de stocker les informations de partitionnement sur un disque.
Master Boot Record, car le MBR est un secteur de démarrage situé au début d’un lecteur. Ce secteur contient un boot loader pour le système d’exploitation installé ainsi que des informations sur les partitions logiques. Le Bios charge le MBR. Ce sont les 512 premiers octets du disque. À partir des informations du MBR, il détermine l’emplacement du chargeur d’amorçage.
MBR fonctionne avec des disques jusqu’à 2 To maximum, il ne peut pas gérer les disques de plus de 2 To d’espace. MBR prend en charge jusqu’à quatre partitions primaires, si vous en voulez plus, vous devez faire de l’une de vos partitions primaires une « partition étendue » et créer des partitions logiques.
Sur un disque en MBR, les données de partitionnement et de démarrage sont stockées dans un seul endroit.
GPT veut dire « GUID Partition Table« . C’est une nouvelle norme qui permet de remplacer progressivement le vieillissent MBR. Elle est associée à UEFI qui lui, remplace le BIOS. On l’appelle « GUID Partition Table », car chaque partition sur votre disque dur a un identifiant unique (GUID = Globally Unique IDentifier).
Ce système n’a pas les limites du MBR. Les disques peuvent être beaucoup, beaucoup plus gros et les limites de taille dépendront du système d’exploitation et de son système de fichiers. GPT permet presque un nombre illimité de partitions, et la limite ici sera votre système d’exploitation. Par exemple, Windows permet jusqu’à 128 partitions sur un disque GPT, et vous n’avez pas à créer de partition étendue.
SNMP
Simple Network Management Protocol (abrégé SNMP), en français « protocole simple de gestion de réseau », est un protocole de communication qui permet aux administrateurs réseau de gérer les équipements du réseau, de superviser et de diagnostiquer des problèmes réseaux et matériels à distance.
Concrètement, dans le cadre d’un réseau, SNMP est utilisé :
pour administrer les équipements ;
pour surveiller le comportement des équipements.
Une requête SNMP est un datagramme UDP habituellement envoyé par le manager à destination du port 161 de l’agent.
| Port | UDP 161 et 162 |
Outils
https://www.youtube.com/watch?v=mqzb_4lz_gs
Pop/SMTP
SMTP et POP3 sont deux des aspects techniques les plus importants de l’ensemble du processus d’envoi d’un courriel. En un mot, le SMTP (acronyme de Simple Mail Transfer Protocol) s’occupe de la livraison, tandis que le protocole POP (acronyme de Post Office Protocol) s’occupe du téléchargement sur votre ordinateur. (Un autre protocole très populaire que vous pouvez utiliser à la place de POP est IMAP: Internet Message Access Protocol).
Quelle est la différence entre POP3 et IMAP ?
Le POP3 est un protocole d’e-mail entrant à sens unique qui télécharge une copie des e-mails à partir du serveur et les stocke localement.Une fois le processus terminé, le protocole postal supprime les données originales de la boîte de réception du serveur. Contrairement à l’IMAP qui synchronise les messages électroniques entre plusieurs appareils et les stocke sur le serveur.
Des connexions TCP sont utilisées par le protocole POP. Il s’appuie sur le port « 110 » par défaut, et pour la déclinaison chiffrée, POP over SSL, le port est le « 995 » POP3S
IMAP (Internet Message Access Protocol), par opposition à POP3, est un protocole de courrier entrant bidirectionnel qui ne télécharge que les en-têtes des messages électroniques au lieu de leur contenu intégral.
Par conséquent, les messages électroniques sont toujours conservés sur le serveur après avoir été récupérés pour être visualisés, ce qui les rend accessibles à partir d’une autre plateforme. Ce protocole synchronise également les modifications apportées par le client de messagerie avec le serveur, d’où la communication bidirectionnelle.
Port IMAP par défaut utilisé par la connexion IMAP :
Basé sur des connexions TCP, IMAP utilise le port « 143 » ou « 220 » en fonction des versions du protocole. Pour la version sécurisée, qui est bien sûr recommandée et que l’on appelle IMAPS, le port est le « 993 ».
SMTP :
Le protocole SMTP (Simple Mail Transfer Protocol) a pour objectif d’acheminer les e-mails envoyés depuis un client, en s’appuyant sur le serveur de messagerie. Ce protocole fonctionne selon le mode client/serveur avec des connexions TCP.
Port SMTP par défaut utilisé par ce protocole :
Le protocole SMTP s’appuie sur le port « 25 » par défaut. Dans sa déclinaison sécurisée, que l’on appelle SMTPS ou SMTP over SSL, le port utilisé est le « 587 ». Pendant un temps, le port pour les connexions sécurisées était le numéro « 465 » et il reste supporté par certains hébergeurs.
POP3 et l’IMAP, ont le même objectif, mais des approches différentes : l’IMAP laisse le contenu des e-mails sur le serveur, tandis que le POP3 le télécharge sur votre ordinateur. Nous avons également appris ce qu’est le SMTP et les ports utilisés par ces trois composants.
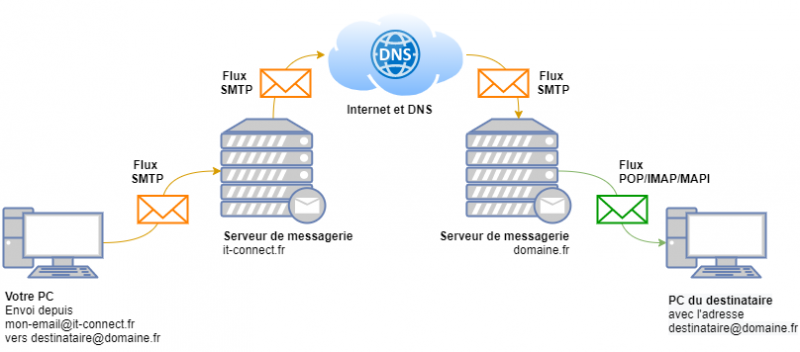
➡ SMTP – Simple Mail Transfer Protocol : transférer/envoyer les e-mails
➡ POP – Post Office Protocol : télécharger e-mails sur le client
➡ IMAP – Internet Message Access Protocol : synchroniser e-mails sur le client
➡ MAPI – Messaging Application Programming Interface : protocole de communication client/serveur Exchange pour synchroniser les e-mails, le calendrier et les contacts
➡ MUA – Mail User Agent : client de messagerie (exemple : Outlook / Thunderbird)
➡ MTA – Mail Transfer Agent : logiciel qui reçoit les e-mails d’un MUA dans le but de les acheminer
➡ MDA – Mail Delivery Agent : logiciel qui stocke les e-mails dans les boîtes aux lettres
https://www.youtube.com/watch?v=CFx2K1rDfGU
Ports
Def :
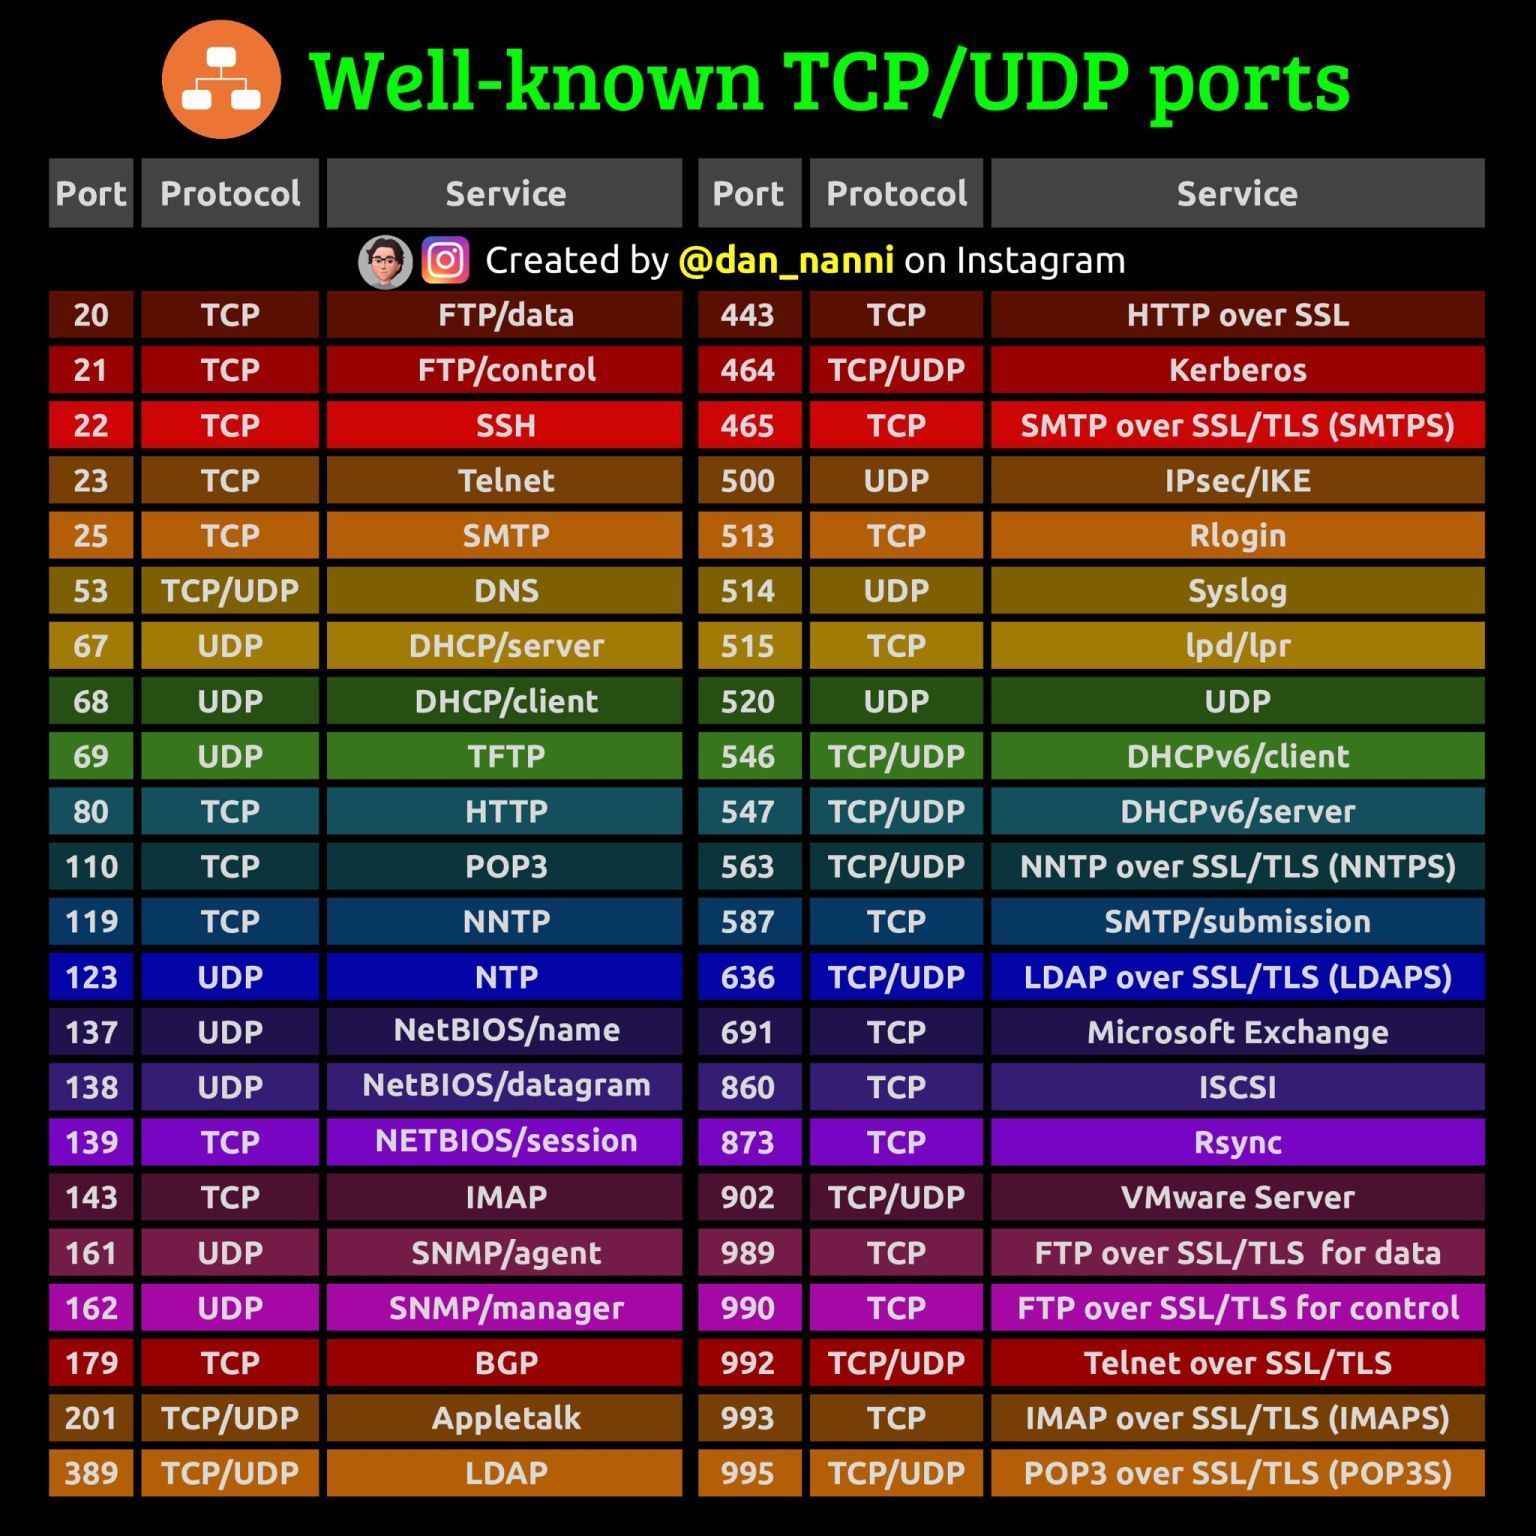
Un port est un point virtuel où les connexions réseau commencent et se terminent. Les ports sont basés sur des logiciels et gérés par le système d’exploitation d’un ordinateur. Chaque port est associé à un processus ou à un service spécifique. Les ports permettent aux ordinateurs de différencier facilement les différents types de trafic : les courriers électroniques sont acheminés vers un port différent de celui des pages web, par exemple, même si les deux atteignent un ordinateur via la même connexion Internet.
Les ports sont normalisés sur tous les périphériques connectés au réseau, et un numéro est attribué à chaque port. La plupart des ports sont réservés à certains protocoles, par exemple, tous les messages Hypertext Transfer Protocol (HTTP) vont au port 80. Alors que les adresses IP permettent aux messages d’aller vers et depuis des périphériques spécifiques, les numéros de port permettent de cibler des services ou des applications spécifiques au sein de ces périphériques.
65 000 ports existants
- 9, pour le WoL, Wake-on-LAN, c’est-à-dire le démarrage à distance par un câble réseau ethernet,
- 20/21, pour l’échange de fichiers via FTP,
- 22, pour l’accès à un shell sécurisé Secure SHell, également utilisé pour l’échange de fichiers sécurisés SFTP,
- 23, pour le port telnet,
- 25, pour l’envoi d’un courrier électronique via un serveur dédié SMTP,
- 53, pour la résolution de noms de domaine en adresses IP : DNS,
- 67/68, pour DHCP et BOOTP,
- 69, pour le TFTP,
- 80, pour la consultation d’un serveur HTTP par le biais d’un navigateur web,
- 110, pour la récupération de son courrier électronique via POP,
- 123, pour la synchronisation de l’horloge : Network Time Protocol (NTP),
- 143, pour la récupération de son courrier électronique via IMAP,
- 389, pour la connexion à un LDAP,
- 443, pour les connexions HTTP utilisant une surcouche de sécurité de type SSL : HTTPS,
- 465, pour l’envoi d’un courrier électronique via un serveur dédié utilisant une surcouche de sécurité de type SSL : SMTPS,
- 500, port utilisé pour le canal d’échange de clés IPsec,
- 554, port utilisé pour accepter les connexions client RTSP entrantes et pour fournir des paquets de données aux clients qui diffusent en utilisant RTSPT,
- 636, pour l’utilisation d’une connexion à un LDAP sécurisé par une couche SSL/TLS,
- 1352, pour le protocole Lotus Notes Domino,
- 1433, serveur de base de données MS SQL,
- 1521, serveur de base de données Oracle Database ,
- 1723, pour l’utilisation du protocole de VPN PPTP,
- 3306, serveur de base de données MySQL,
- 3389, pour la prise de contrôle à distance RDP,
- 5432, serveur de base de données PostgreSQL,
- 6667, pour la connexion aux serveurs IRC,
- 7777, port souvent utilisé pour des serveurs de jeux-vidéo tels que Terraria ou Unreal Tournament 2,
- 25565, port par défaut des serveurs Minecraft3,4,5
https://www.youtube.com/watch?v=YSl6bordSh8
Le port 465 était initialement destiné au SMTPS (SMTP over SSL), mais il a depuis été déclaré comme obsolète et réaffecté. Cependant, de nombreux FAI et fournisseurs d’hébergement sur le cloud continuent malgré tout de prendre en charge le port 465 pour la soumission SMTP.
Lorsque vous souhaitez créer une connexion chiffrée avec un chiffrage SSL, ce port constitue une autre solution viable.
Quel port SMTP dois-je utiliser ?
Récapitulons comment choisir le bon port SMTP :
- Si vous souhaitez créer une connexion chiffrée avec un chiffrage TLS, vous devez utiliser le port 587. Lorsque vous configurez votre site Web ou votre client email pour envoyer des emails via SMTP, il est recommandé d’utiliser le port 587 par défaut.
- Toutefois, si le port 587 n’est pas disponible en raison de certaines restrictions, le port 2525 constitue une autre solution courante. Bien que le port 2525 ne soit pas officiellement reconnu comme un port SMTP, la plupart des fournisseurs de services l’utilisent et le prennent en charge.
- Si vous souhaitez créer une connexion chiffrée avec un chiffrage SSL, vous devez utiliser le port 465 pour le SMTP.
FTP
Le File Transfer Protocol (FTP) est l’un des plus anciens protocoles d’Internet. Le protocole de transfert de fichiers est souvent utilisé lors de la création de sites Web. Les fichiers HTML peuvent être transférés sur le serveur via un accès FTP.
Le File Transfer Protocol s’exécute dans la couche application de la pile des protocoles TCP/IP. Il est ainsi sur la même couche que le HTTP ou POP. Ces protocoles se caractérisent par le fait qu’ils fonctionnent avec des programmes tels que des navigateurs ou des clients de messagerie électronique pour assurer leurs services. Il existe également des logiciels FTP spéciaux pour le protocole de transfert de fichiers.
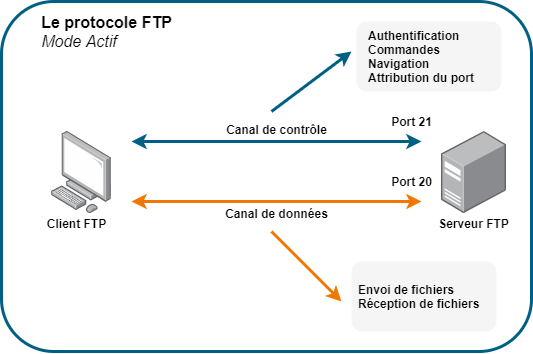
Comme nous pouvons le voir sur le schéma ci-dessous, qui représente le mode actif, le canal de contrôle s’établit sur le port 21 du serveur FTP. Ensuite, le canal de données s’établit sur le port 20. Par conséquent, le mode actif s’appuie sur deux ports : 20 et 21.
Autrement dit, le port 20 n’est pas utilisé avec le mode passif mais un autre port supérieur à 1024.
SFTP
SFTP (Secure File Transfer Protocol) est un protocole de transfert de fichiers qui exploite un ensemble d’utilitaires qui fournissent un accès sécurisé à un ordinateur distant pour fournir des communications sécurisées.
Quelle est la différence entre FTP et SFTP ?
La principale différence entre le FTP et le SFTP est que le SFTP utilise un canal sécurisé pour transférer des fichiers alors que le FTP ne le fait pas. Avec le SFTP, votre connexion est toujours sécurisée et les données qui circulent entre votre client FTP et votre serveur web sont cryptées.
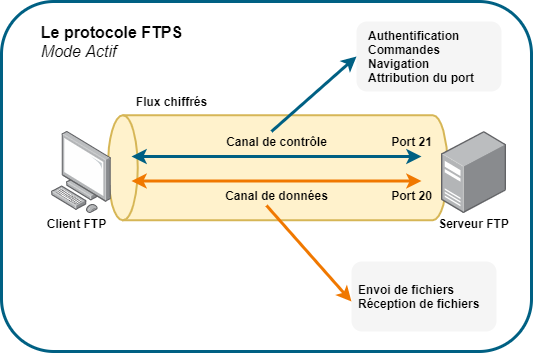
Le chiffrement SSL/TLS vient s’ajouter pour sécuriser les communications entre le client FTP et le serveur FTP. Pour le reste, c’est identique.
Néanmoins, il faut préciser que le FTPS fonctionne selon deux modes :
- FTP explicite : dans ce cas la connexion s’établie sur le port 21 et le client FTP négocie avec le serveur FTP pour chiffrer la connexion. Des commandes FTP sont utilisées : « AUTH TLS » ou « AUTH SSL » et « PROT P »
- FTP implicite : le client commence directement la connexion avec le chiffrement SSL et va utiliser plutôt le port 990 que le port 21
En fonction du mode, le protocole FTPS peut utiliser le port 990 en TCP pour le canal de contrôle et le port 989 pour le canal de données. Le port 21 peut également être utilisé.
- Le protocole SFTP
Pour terminer intéressons nous au protocole SFTP. Tout d’abord, il faut savoir que le SFTP signifie « SSH File Transfer Protocol » ou « Secure File Transfer Protocol« . Nous pouvons dire les deux.
En plus du protocole FTP, il va s’appuyer sur un deuxième protocole : le SSH. Le poste client va établir un tunnel SSH avec le serveur distant, et le flux FTP passera dans ce tunnel SSH, ce qui signifie que le flux est sécurisé.
Il n’est pas nécessaire d’avoir un serveur FTP pour établir une connexion à l’aide du SFTP. Par contre, vous devez avoir un serveur SSH sur le serveur distant donc la connexion s’effectue sur le port SSH, à savoir le port 22 par défaut. Une seule connexion à établir et ensuite tout se passe dans le tunnel SSH.
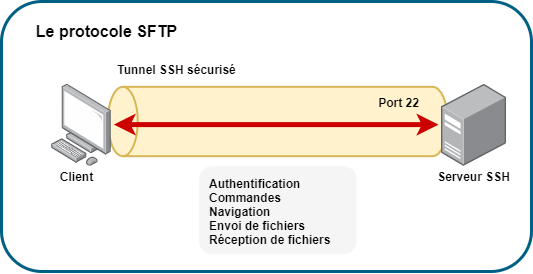
Lorsque le tunnel est établi, vous pouvez effectuer du transfert de fichiers de façon sécurisée via FTP, avec les logiciels habituels : FileZilla et WinSCP.
Pour en savoir plus, je vous oriente vers ce chapitre de notre cours :⭐ SFTP
HTTP
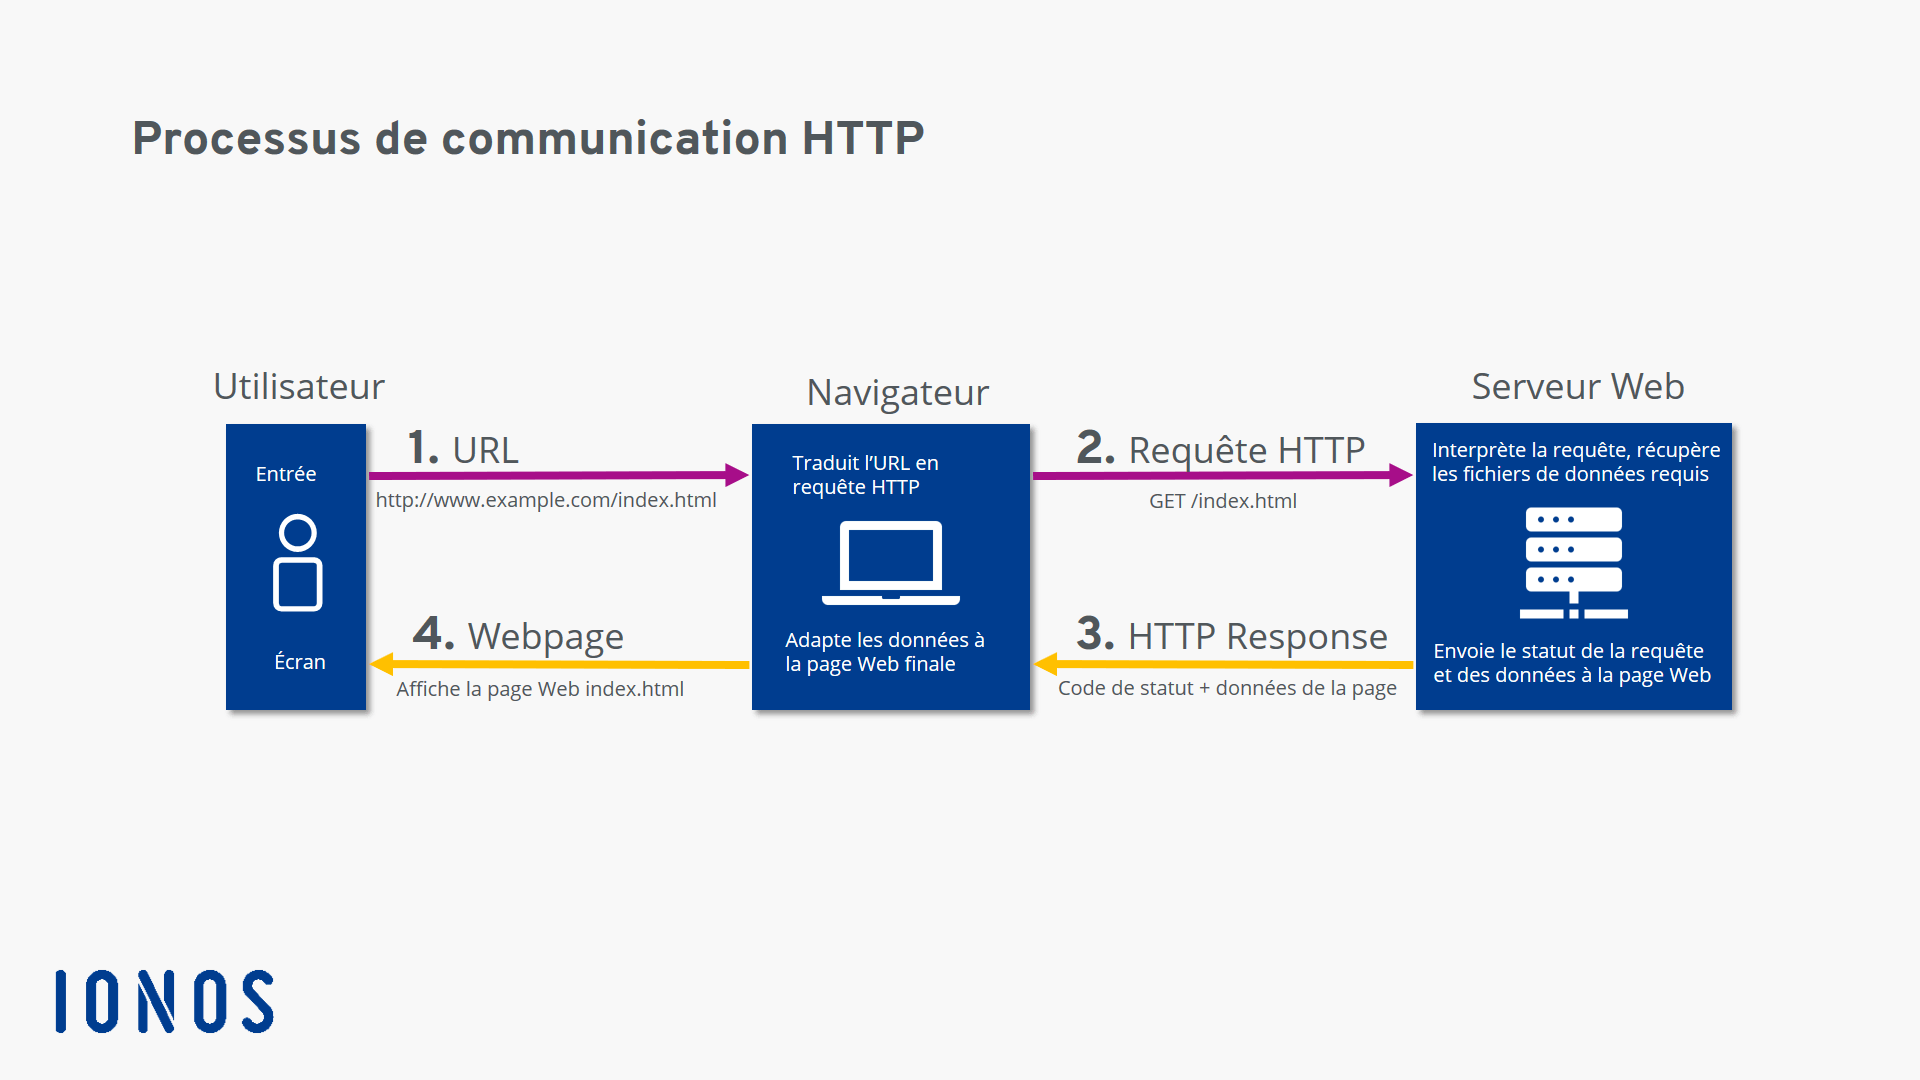
HTTP signifie « Hypertext Transfer Protocol ».
Alors que le HTML (Hypertext Markup Language) définit comment un site Internet est construit, le HTTP détermine comment la page est transmise du serveur au client. Le troisième concept, l’URL (Uniform Resource Locator), fixe la façon dont une ressource (par exemple un site Internet) doit être adressée sur le Web.
https://www.youtube.com/watch?v=WGdOWtKL5nA
- HTTPS :
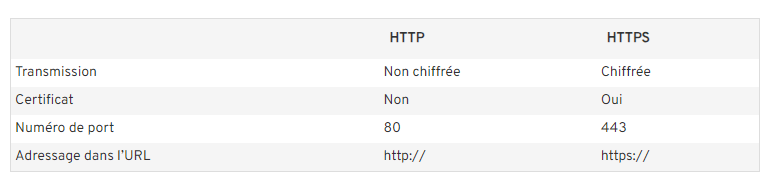
- L’abréviation HTTPS signifie « Hypertext Transfer Protocol Secure », qui se traduit par « Protocole hypertexte de transmission sécurisé ». Le protocole de transmission est en quelque sorte le langage par lequel le client – en règle générale le navigateur – et le serveur Web se comprennent. Le HTTPS est la version du protocole de transmission qui opère en transmission chiffrée.
Le HTTPS remplit deux fonctions :
La communication entre le client Web et le serveur Web est chiffrée. Ceci afin d’empêcher qu’un tiers non autorisé « écoute » la communication en prenant par exemple connaissance du trafic en réseau WLAN.
Le serveur Web est authentifié par le fait qu’en tout début de communication, un certificat est envoyé au client Web pour attester de la crédibilité du domaine. Cette mesure contribue à combattre les tromperies résultant de faux sites Web.
https://www.youtube.com/watch?v=7W7WPMX7arI&t=359s
- NTP :
Network Time Protocol (litt. « protocole de temps réseau »), parfois appelé protocole de synchronisation de réseau1, est un protocole qui permet de synchroniser, via un réseau informatique, l’horloge locale d’ordinateurs sur une référence d’heure.
https://www.youtube.com/watch?v=7grXjecIHpw
- ICMP :
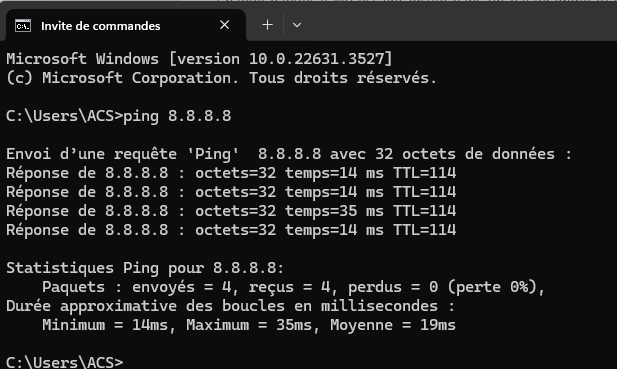
- Le protocole ICMP, pour Internet Control Message Protocol, est très utile sur les réseaux IP puisqu’en cas de problème d’émission d’un paquet, il va être capable d’informer l’émetteur du paquet qu’il y a eu une erreur dans la transmission du paquet. En cas d’incident pour joindre un service, un hôte ou un routeur, le protocole ICMP peut informer l’adresse IP source de ce dysfonctionnement.
-
-
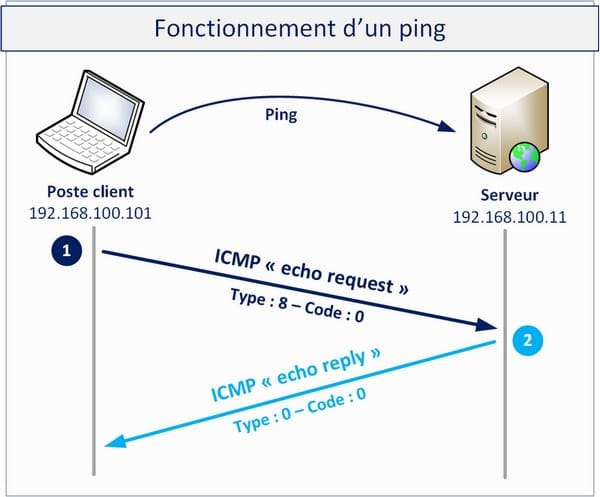
- 8 paquets, 4 demandes, 4 réponses.
- Le NAT
NAT (Network Address Translation) est un processus de modification des adresses IP et des ports source et de destination. La traduction d’adresses réduit le besoin d’adresses publiques IPv4 et masque les plages d’adresses réseau privées. Le processus est généralement effectué par des routeurs ou des pare-feu.
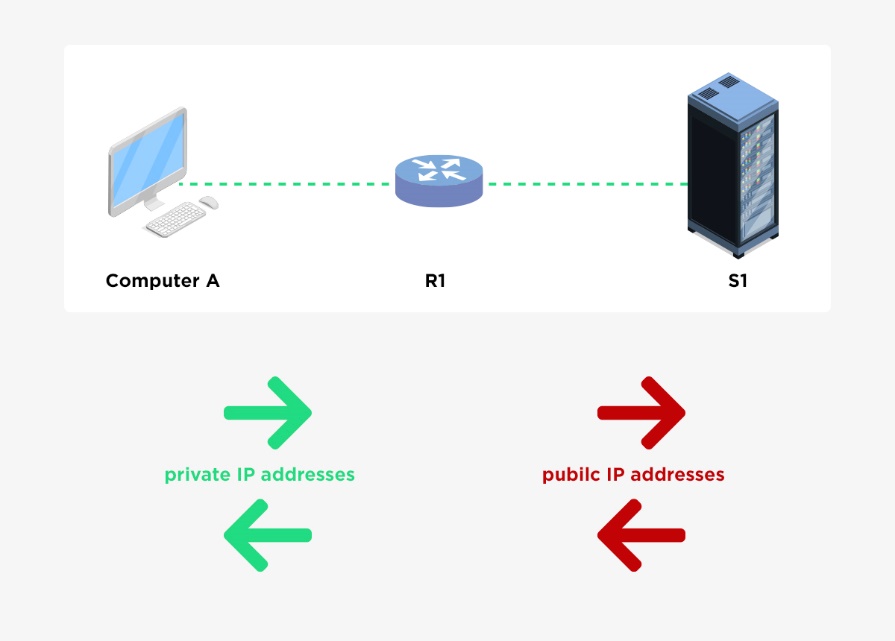
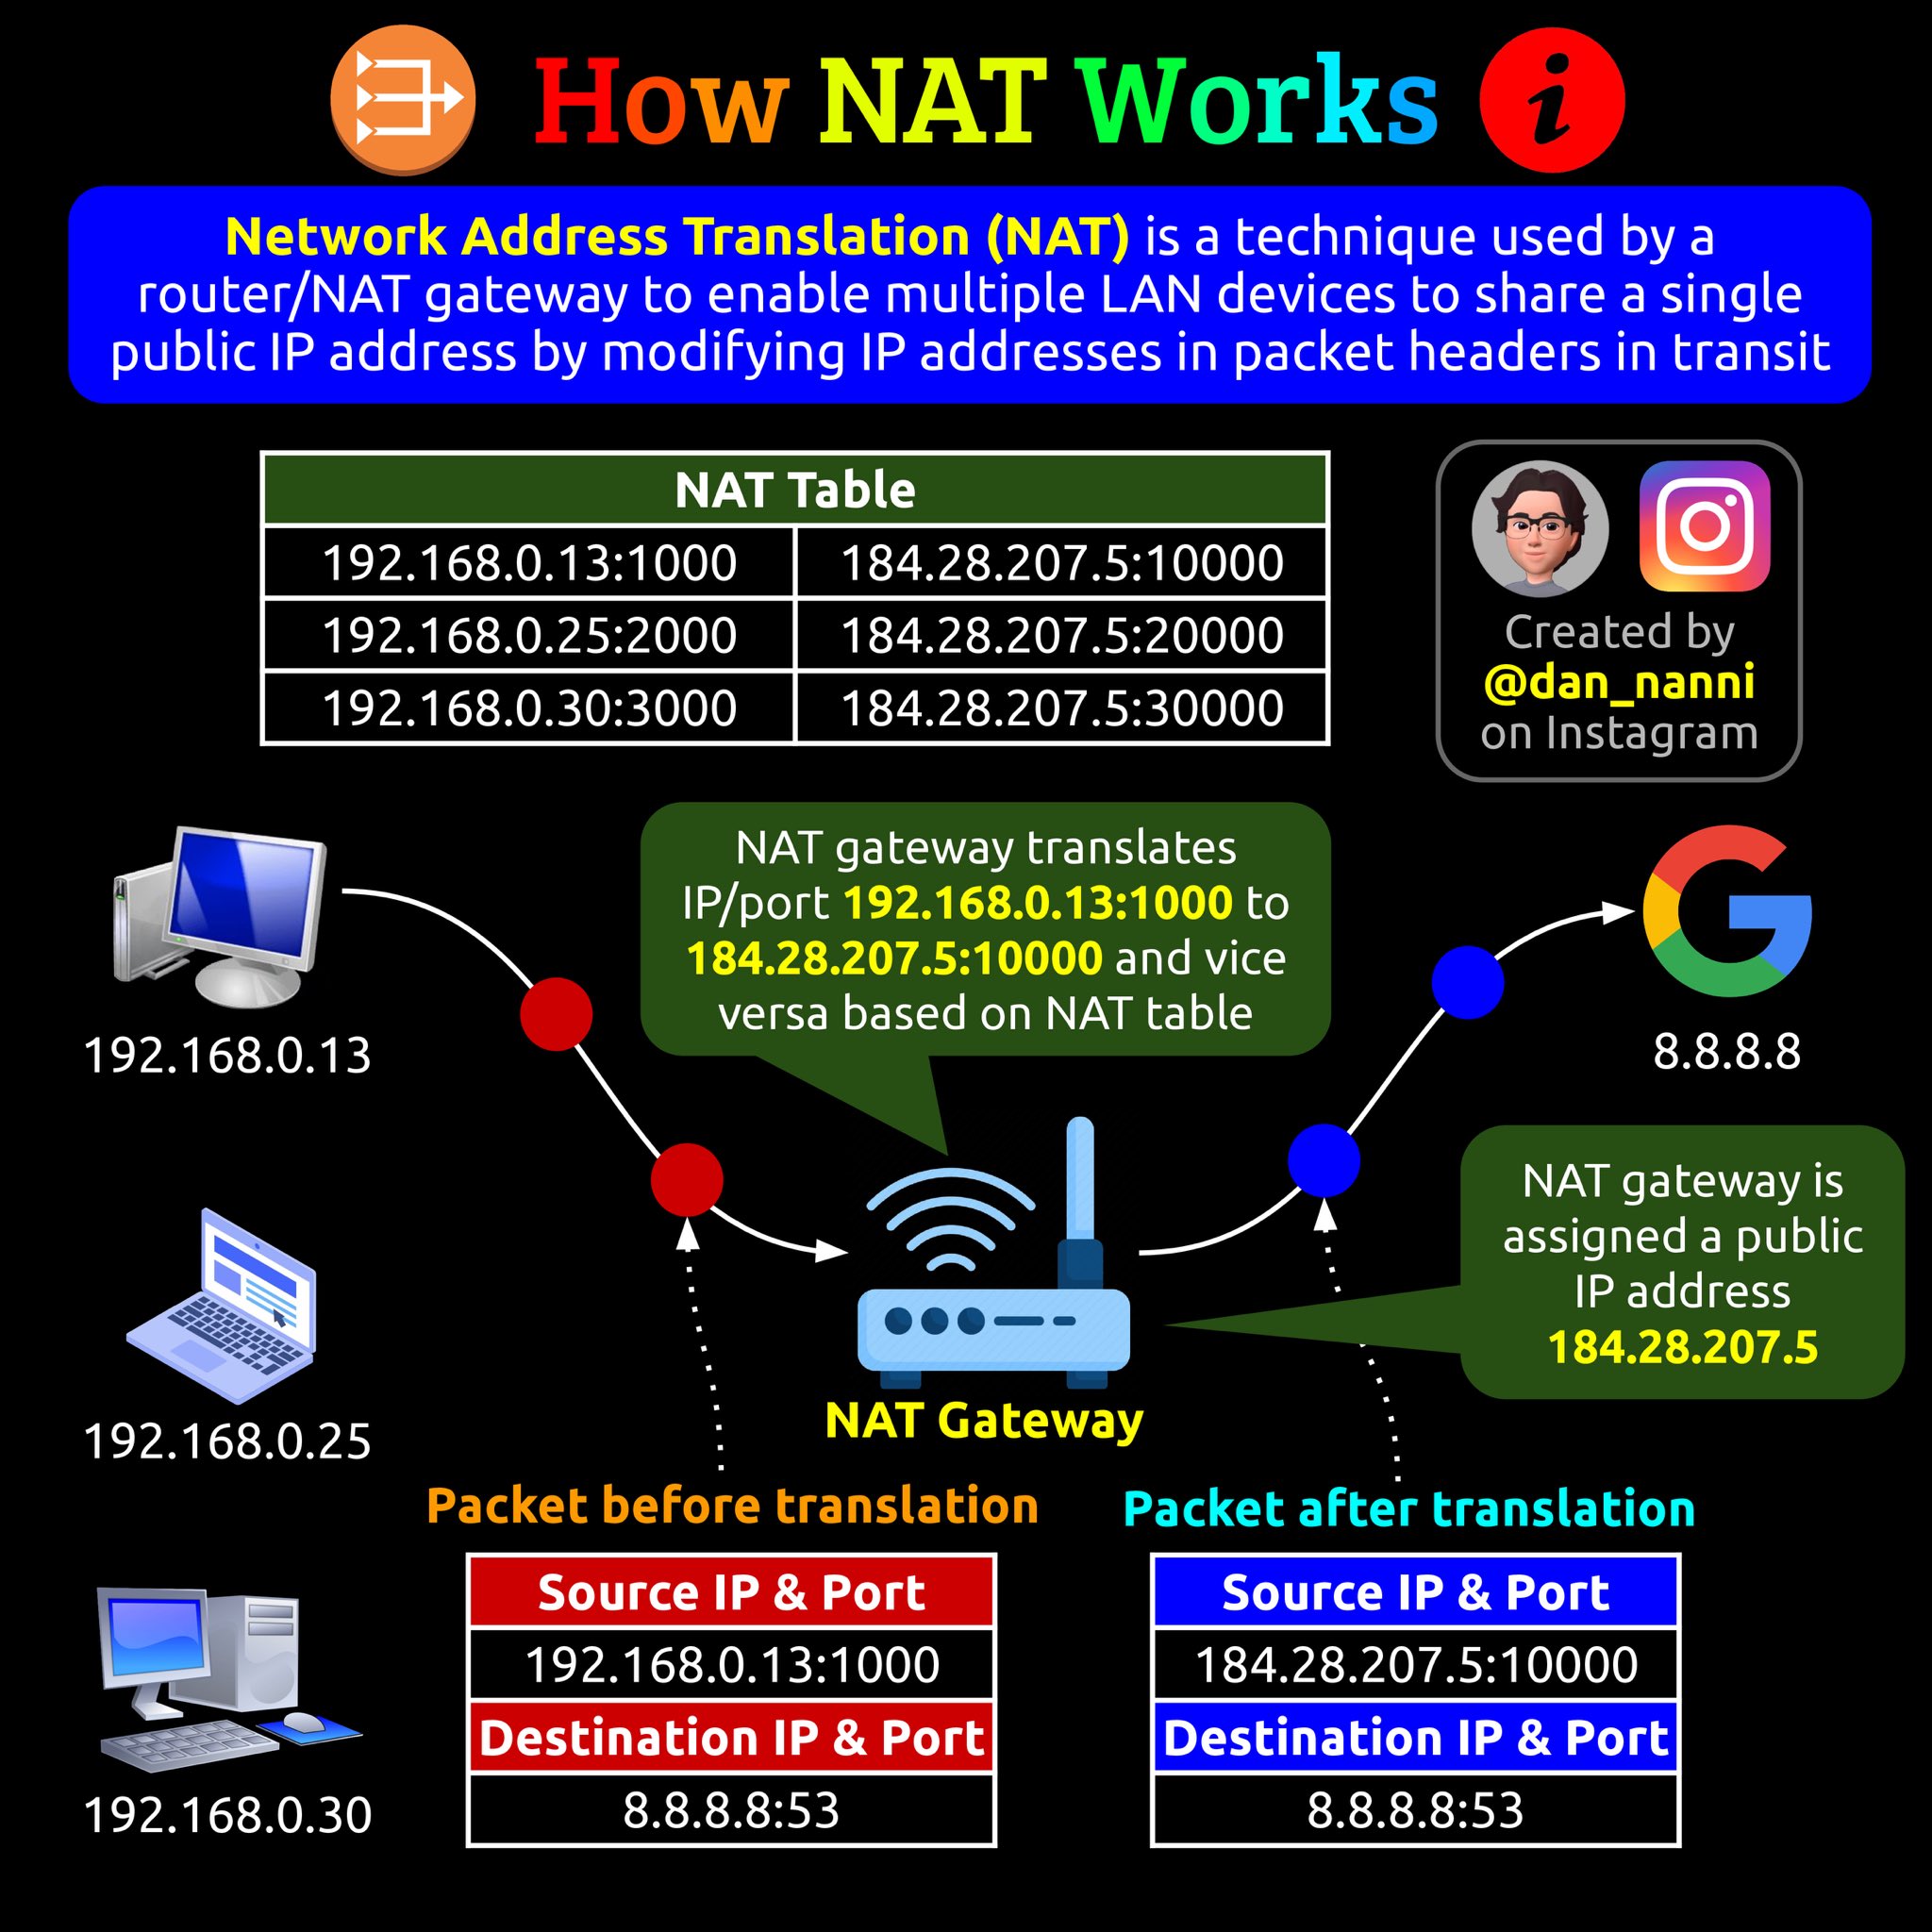
NAT permet à un seul appareil, tel qu’un routeur, d’agir comme un agent entre Internet (ou réseau public) et un réseau local (ou réseau privé), ce qui signifie qu’une seule adresse IP unique est requise pour représenter un groupe entier d’ordinateurs à quoi que ce soit en dehors de leur réseau.
- Il existe trois types de traduction d’adresses:
- NAT statique – traduit une adresse IP privée en une adresse publique. L’adresse IP publique est toujours la même.
- NAT dynamique – les adresses IP privées sont mappées au pool d’adresses IP publiques.
- Traduction d’adresse de port (PAT) – une adresse IP publique est utilisée pour tous les périphériques internes, mais un port différent est attribué à chaque adresse IP privée. Également connu sous le nom de surcharge NAT.
SUIVEZ LES LIENS EN BLEU POAUR ACCEDER AUX COMMANDES CISCO ET AUX EXEMPLES COMPLETS
Configuration du NAT statique sur les appareils Cisco
Avec le NAT statique, les routeurs ou les pare-feu traduisent une adresse IP privée en une seule adresse IP publique. Chaque adresse IP privée est mappée sur une seule adresse IP publique. Le NAT statique n’est pas souvent utilisé car il nécessite une adresse IP publique pour chaque adresse IP privée.
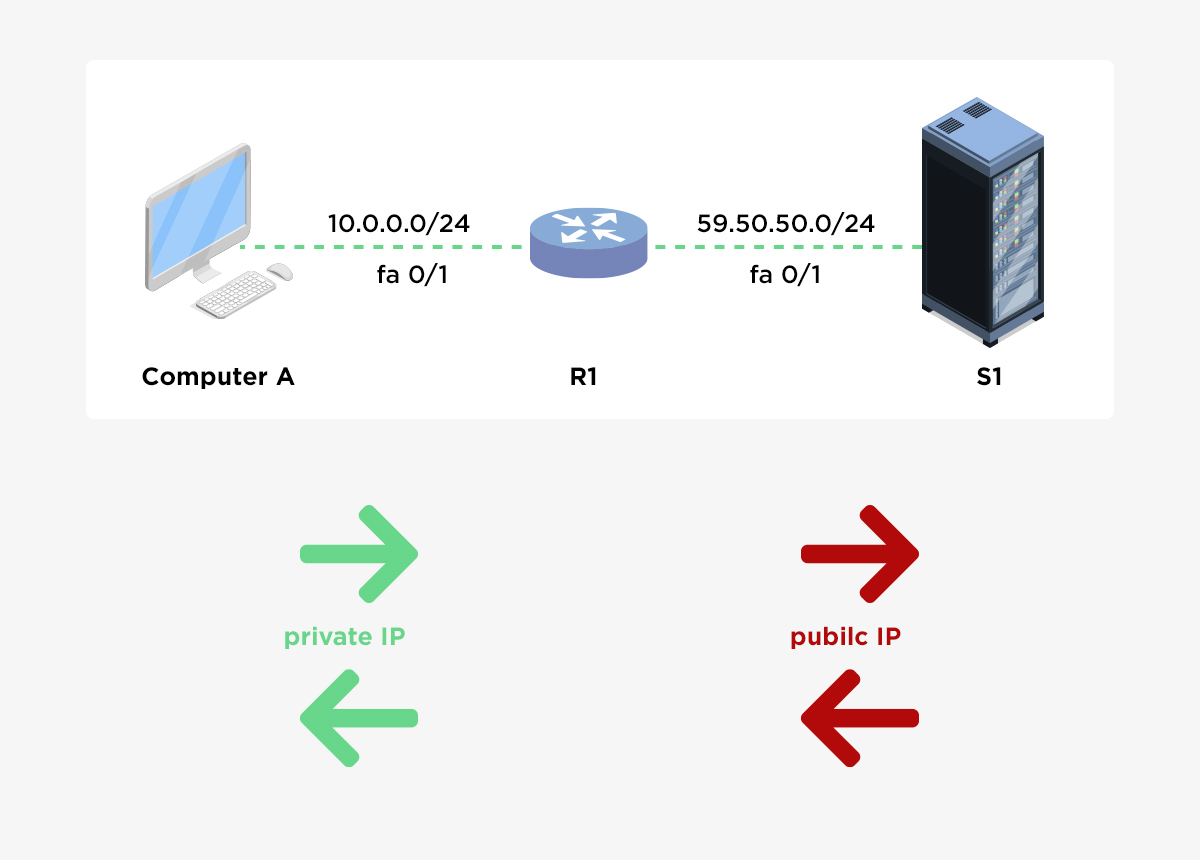
Configuration du NAT dynamique dans les appareils Cisco
Cet article vous aidera à travers les étapes de configuration du NAT dynamique sur les appareils Cisco. Vous pourrez créer les commandes de configuration correspondantes à l’aide de l’application Network Configuration Manager. Cela vous aidera à effectuer la même opération sur plusieurs appareils simultanément.
Avec le NAT dynamique, vous spécifiez deux ensembles d’adresses sur votre routeur Cisco:
- Adresses internes qui seront traduites.
- Un pool d’adresses globales.
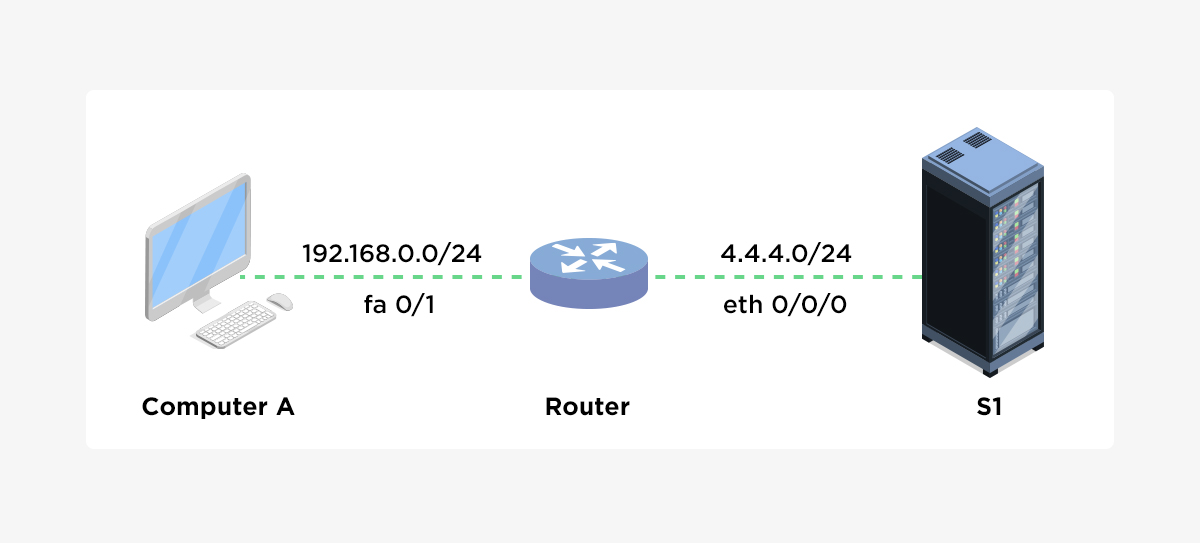
Contrairement au NAT statique, où vous deviez définir manuellement un mappage statique entre une adresse privée et publique, avec le NAT dynamique, le mappage d’une adresse locale à une adresse globale se produit de manière dynamique. Cela signifie que le routeur sélectionne dynamiquement une adresse du pool d’adresses global qui n’est pas actuellement affectée. Il peut s’agir de n’importe quelle adresse du pool d’adresses globales. L’entrée dynamique reste dans la table des traductions NAT tant que le trafic est échangé. L’entrée expire après une période d’inactivité et l’adresse IP globale peut être utilisée pour de nouvelles traductions.
Configuration de la traduction d’adresse de port (PAT) sur les appareils Cisco
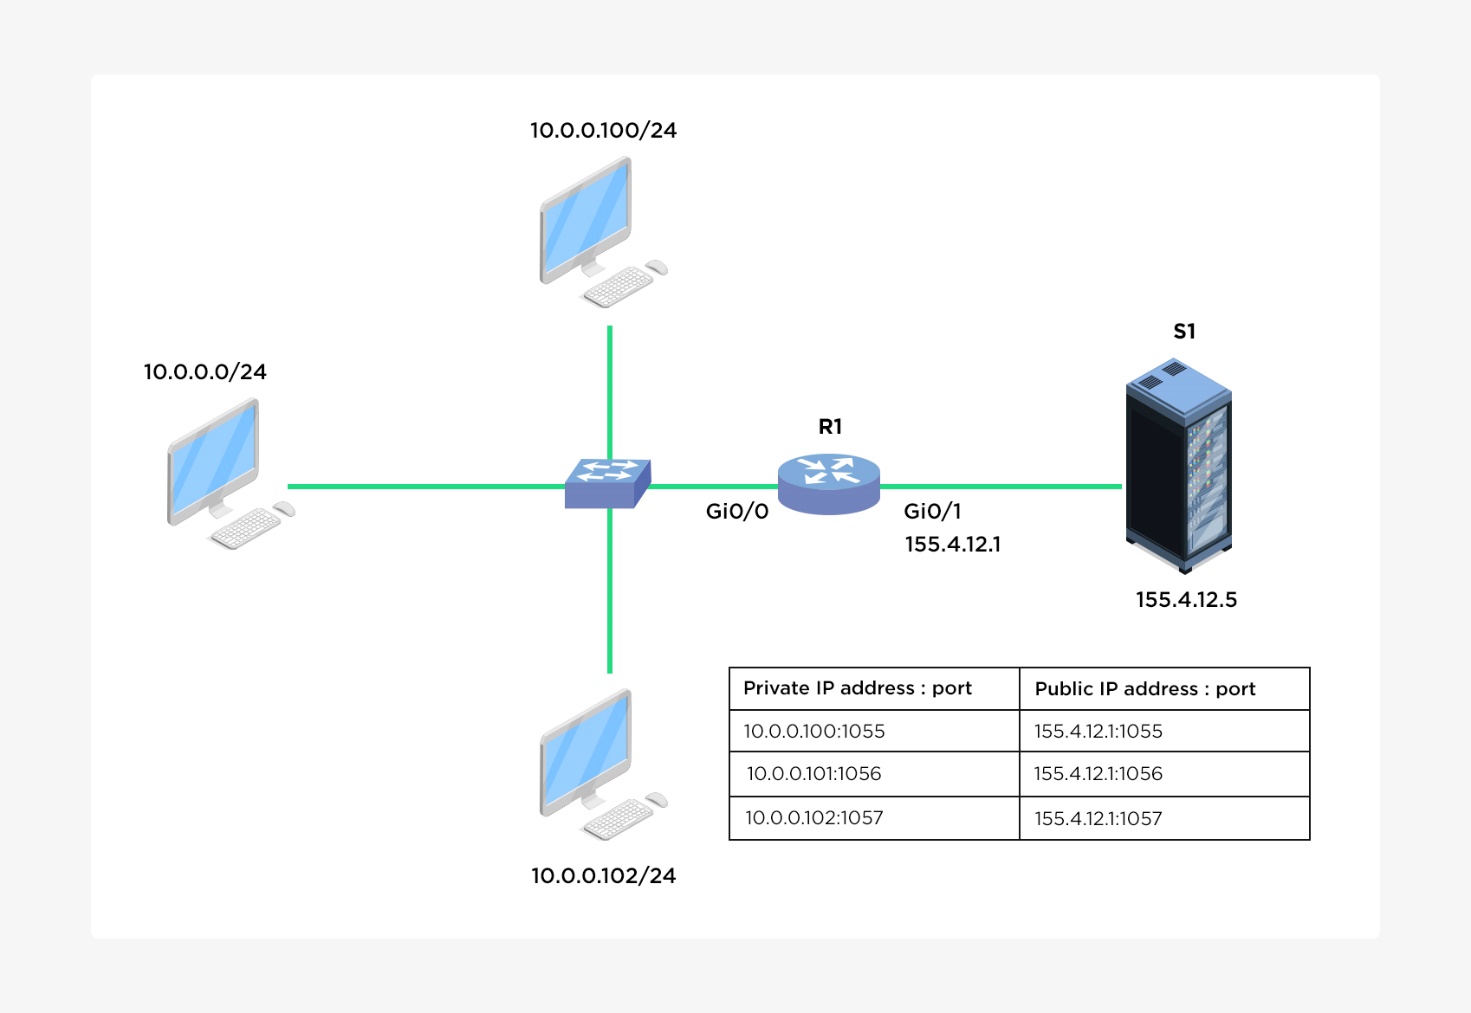
Avec la traduction d’adresse de port (PAT), une seule adresse IP publique est utilisée pour toutes les adresses IP privées internes, mais un port différent est attribué à chaque adresse IP privée. Ce type de NAT est également connu sous le nom de surcharge NAT et est la forme typique de NAT utilisée dans les réseaux d’aujourd’hui. Il est même pris en charge par la plupart des routeurs grand public.
PAT vous permet de prendre en charge de nombreux hôtes avec seulement quelques adresses IP publiques. Il fonctionne en créant un mappage NAT dynamique, dans lequel une adresse IP globale (publique) et un numéro de port unique sont sélectionnés. Le routeur conserve une entrée de table NAT pour chaque combinaison unique de l’adresse IP et du port privés, avec traduction vers l’adresse globale et un numéro de port unique.
Vous pourrez créer les commandes de configuration correspondantes à l’aide de l’application Network Configuration Manager. Cela vous aidera à effectuer la même opération sur plusieurs appareils simultanément.
https://www.youtube.com/watch?v=jq3SLuhIyPI
https://www.youtube.com/watch?v=pS5zp9eBeq8&t=1s
Virtualisation
https://www.youtube.com/watch?app=desktop&v=4J_00mQ5BAs
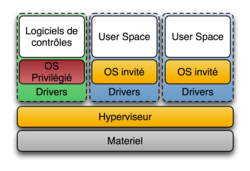
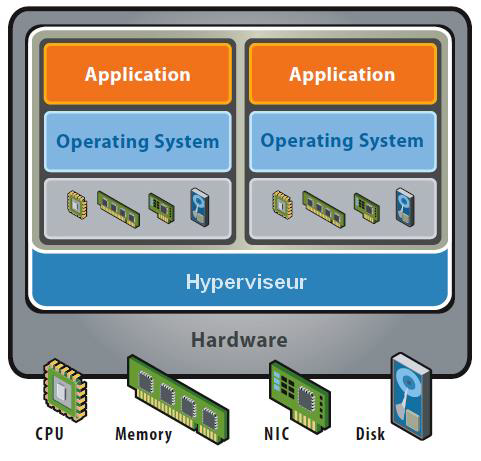
- Hyperviseur de type 1
- Un hyperviseur de type 1 est comme un noyau système très léger et optimisé pour gérer les accès des noyaux d’OS invités à l’architecture matérielle sous-jacente. Si les OS invités fonctionnent en ayant conscience d’être virtualisés et sont optimisés pour ce fait, on parle alors de para-virtualisation (méthode indispensable sur Hyper-V de Microsoft et qui augmente les performances sur ESX de VMware par exemple). Actuellement[Quand ?] l’hyperviseur est la méthode de virtualisation d’infrastructure la plus performante mais elle a pour inconvénient d’être contraignante et onéreuse, bien que permettant plus de flexibilité dans le cas de la virtualisation d’un centre de données.
- Par exemple : XCP-NG (libre) ou son parent Citrix Xen Server, VMware vSphere (anciennement VMware ESXi et VMware ESX), Microsoft Hyper-V Server, Parallels Server Bare Metal, Oracle vm (gratuit), KVM (libre).
- Hyperviseur de type 2
-
Un hyperviseur de type 28 est un logiciel (généralement assez lourd) qui tourne sur l’OS hôte. Ce logiciel permet de lancer un ou plusieurs OS invités. La machine virtualise ou/et émule le matériel pour les OS invités, ces derniers croient dialoguer directement avec ledit matériel. Cette solution est très comparable à un émulateur, et parfois même confondue. Cependant l’unité centrale de calcul, c’est-à-dire le microprocesseur, la mémoire système (RAM) ainsi que la mémoire de stockage (via un fichier) sont directement accessibles aux machines virtuelles, alors que sur un émulateur l’unité centrale est simulée ce qui réduit considérablement les performances par rapport à la virtualisation.
- Cette solution isole bien les OS invités, mais elle a un coût en performance. Ce coût peut être très élevé si le processeur doit être émulé, comme cela est le cas dans l’émulation. En échange cette solution permet de faire cohabiter plusieurs OS hétérogènes sur une même machine grâce à une isolation complète. Les échanges entre les machines se font via les canaux standards de communication entre systèmes d’exploitation (TCP/IP et autres protocoles réseau), un tampon d’échange permet d’émuler des cartes réseaux virtuelles sur une seule carte réseau réelle.
- Par exemple : logiciels Microsoft (Microsoft VirtualPC, Microsoft Virtual Server), logiciels Parallels (Parallels Desktop, Parallels Server), Oracle VM VirtualBox (libre), logiciels VMware (VMware Fusion, VMware Player, VMware Server, VMware Workstation), logiciels libres (QEMU : émulateur de plateformes x86, PPC, Sparc, et bochs : émulateur de plateforme x86).
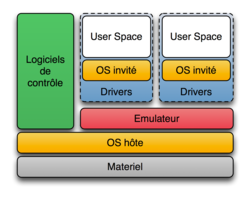
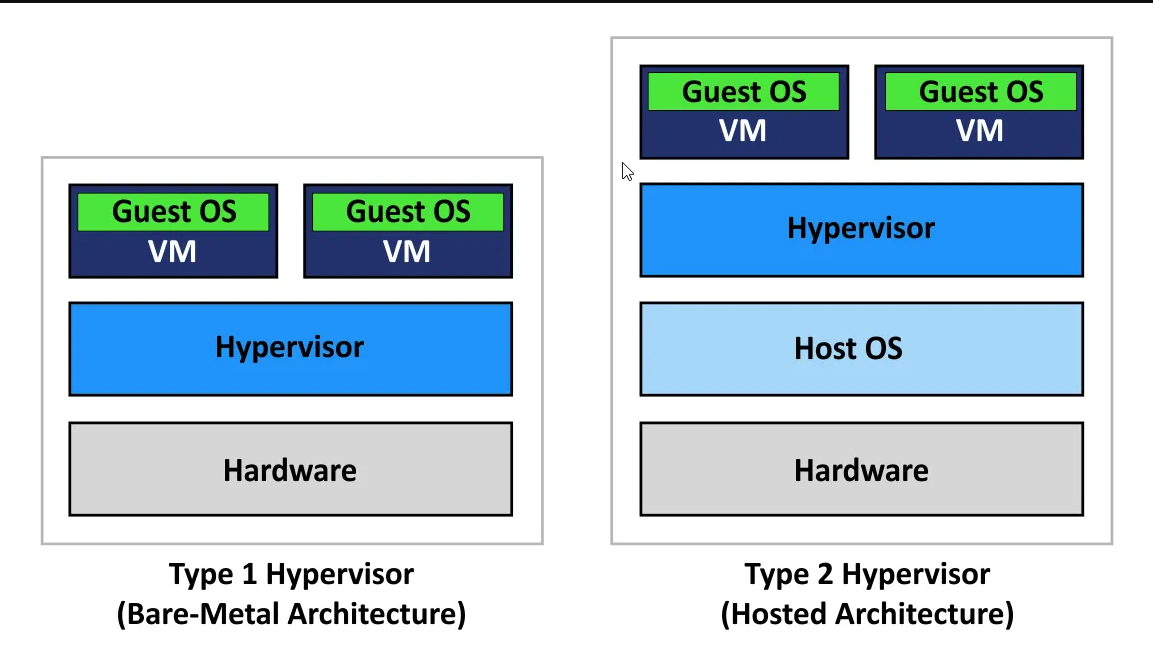
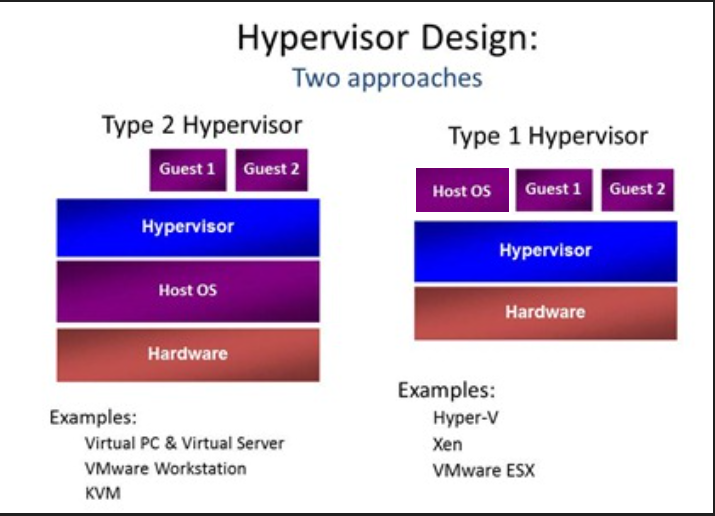
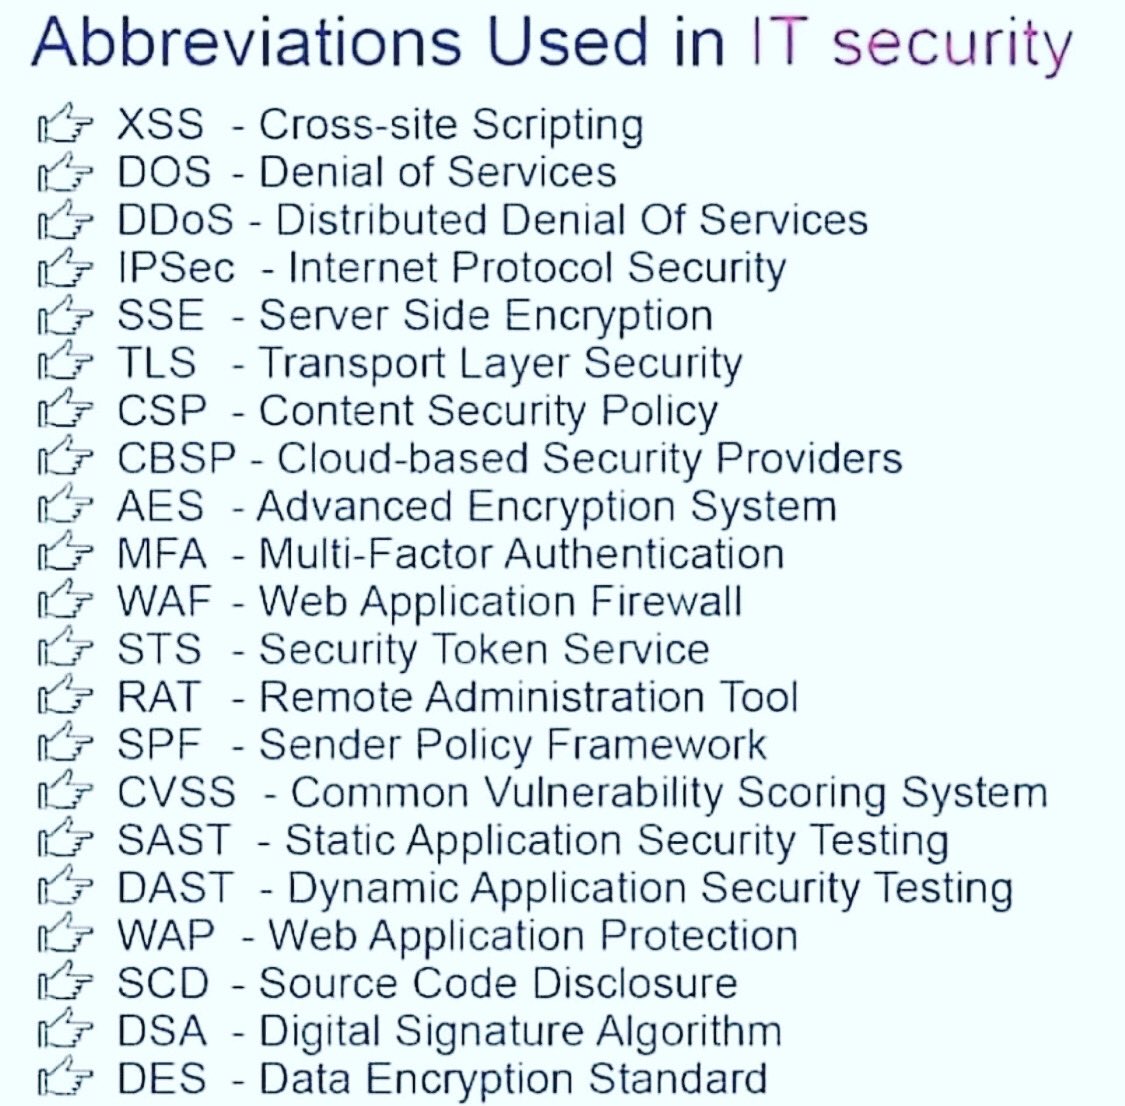
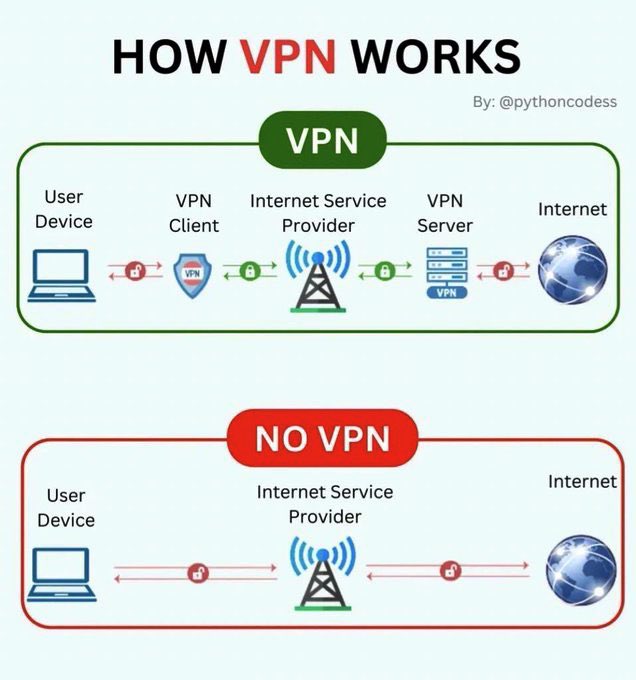
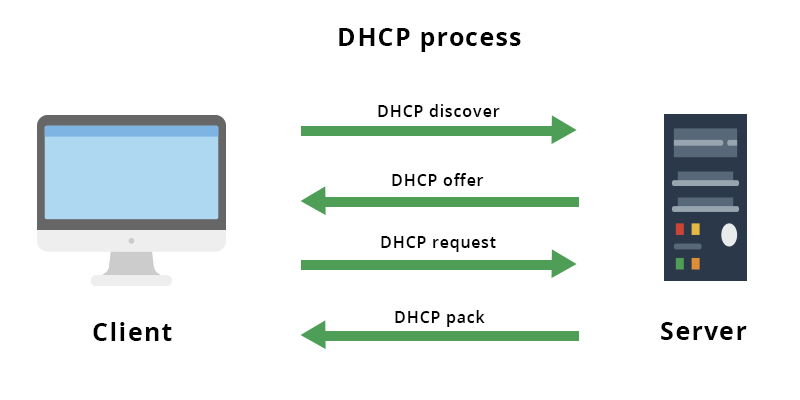
Le protocole DHCP (Dynamic Host Configuration Protocol) est un protocole réseau qui permet à un serveur DHCP/serveur de réseau d’allouer dynamiquement une adresse IP, un masque de sous-réseau, des passerelles par défaut et d’autres paramètres de configuration réseau aux périphériques demandeurs. Il automatise la tâche de configuration IP banale de l’administrateur réseau en automatisant efficacement les allocations IP et en minimisant le gaspillage IP et les conflits IP. Le serveur DHCP peut attribuer dynamiquement des adresses IP aux périphériques réseau à partir de son pool d’adresses et les récupérer
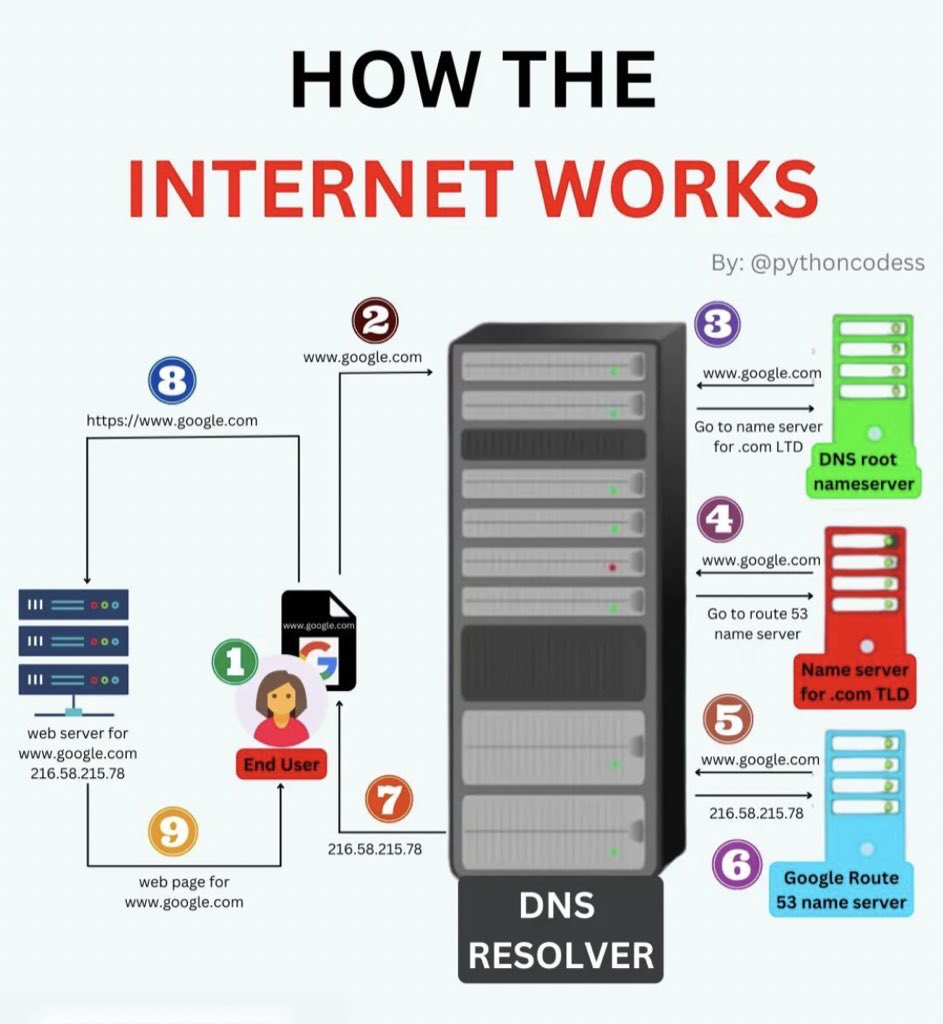
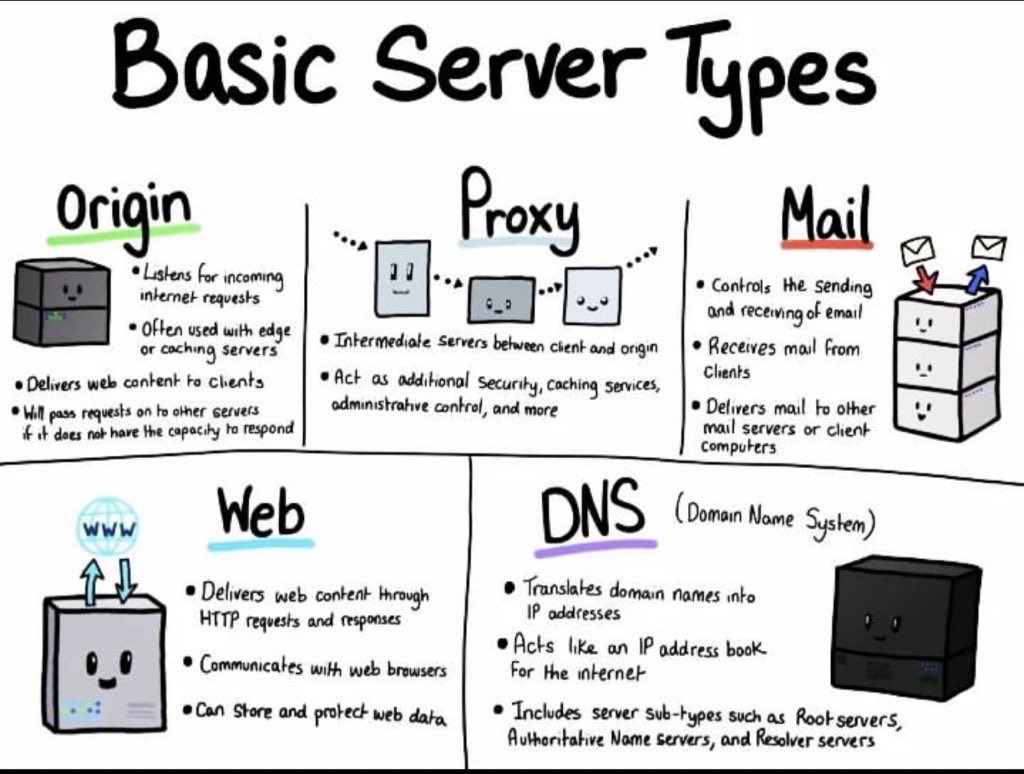
…
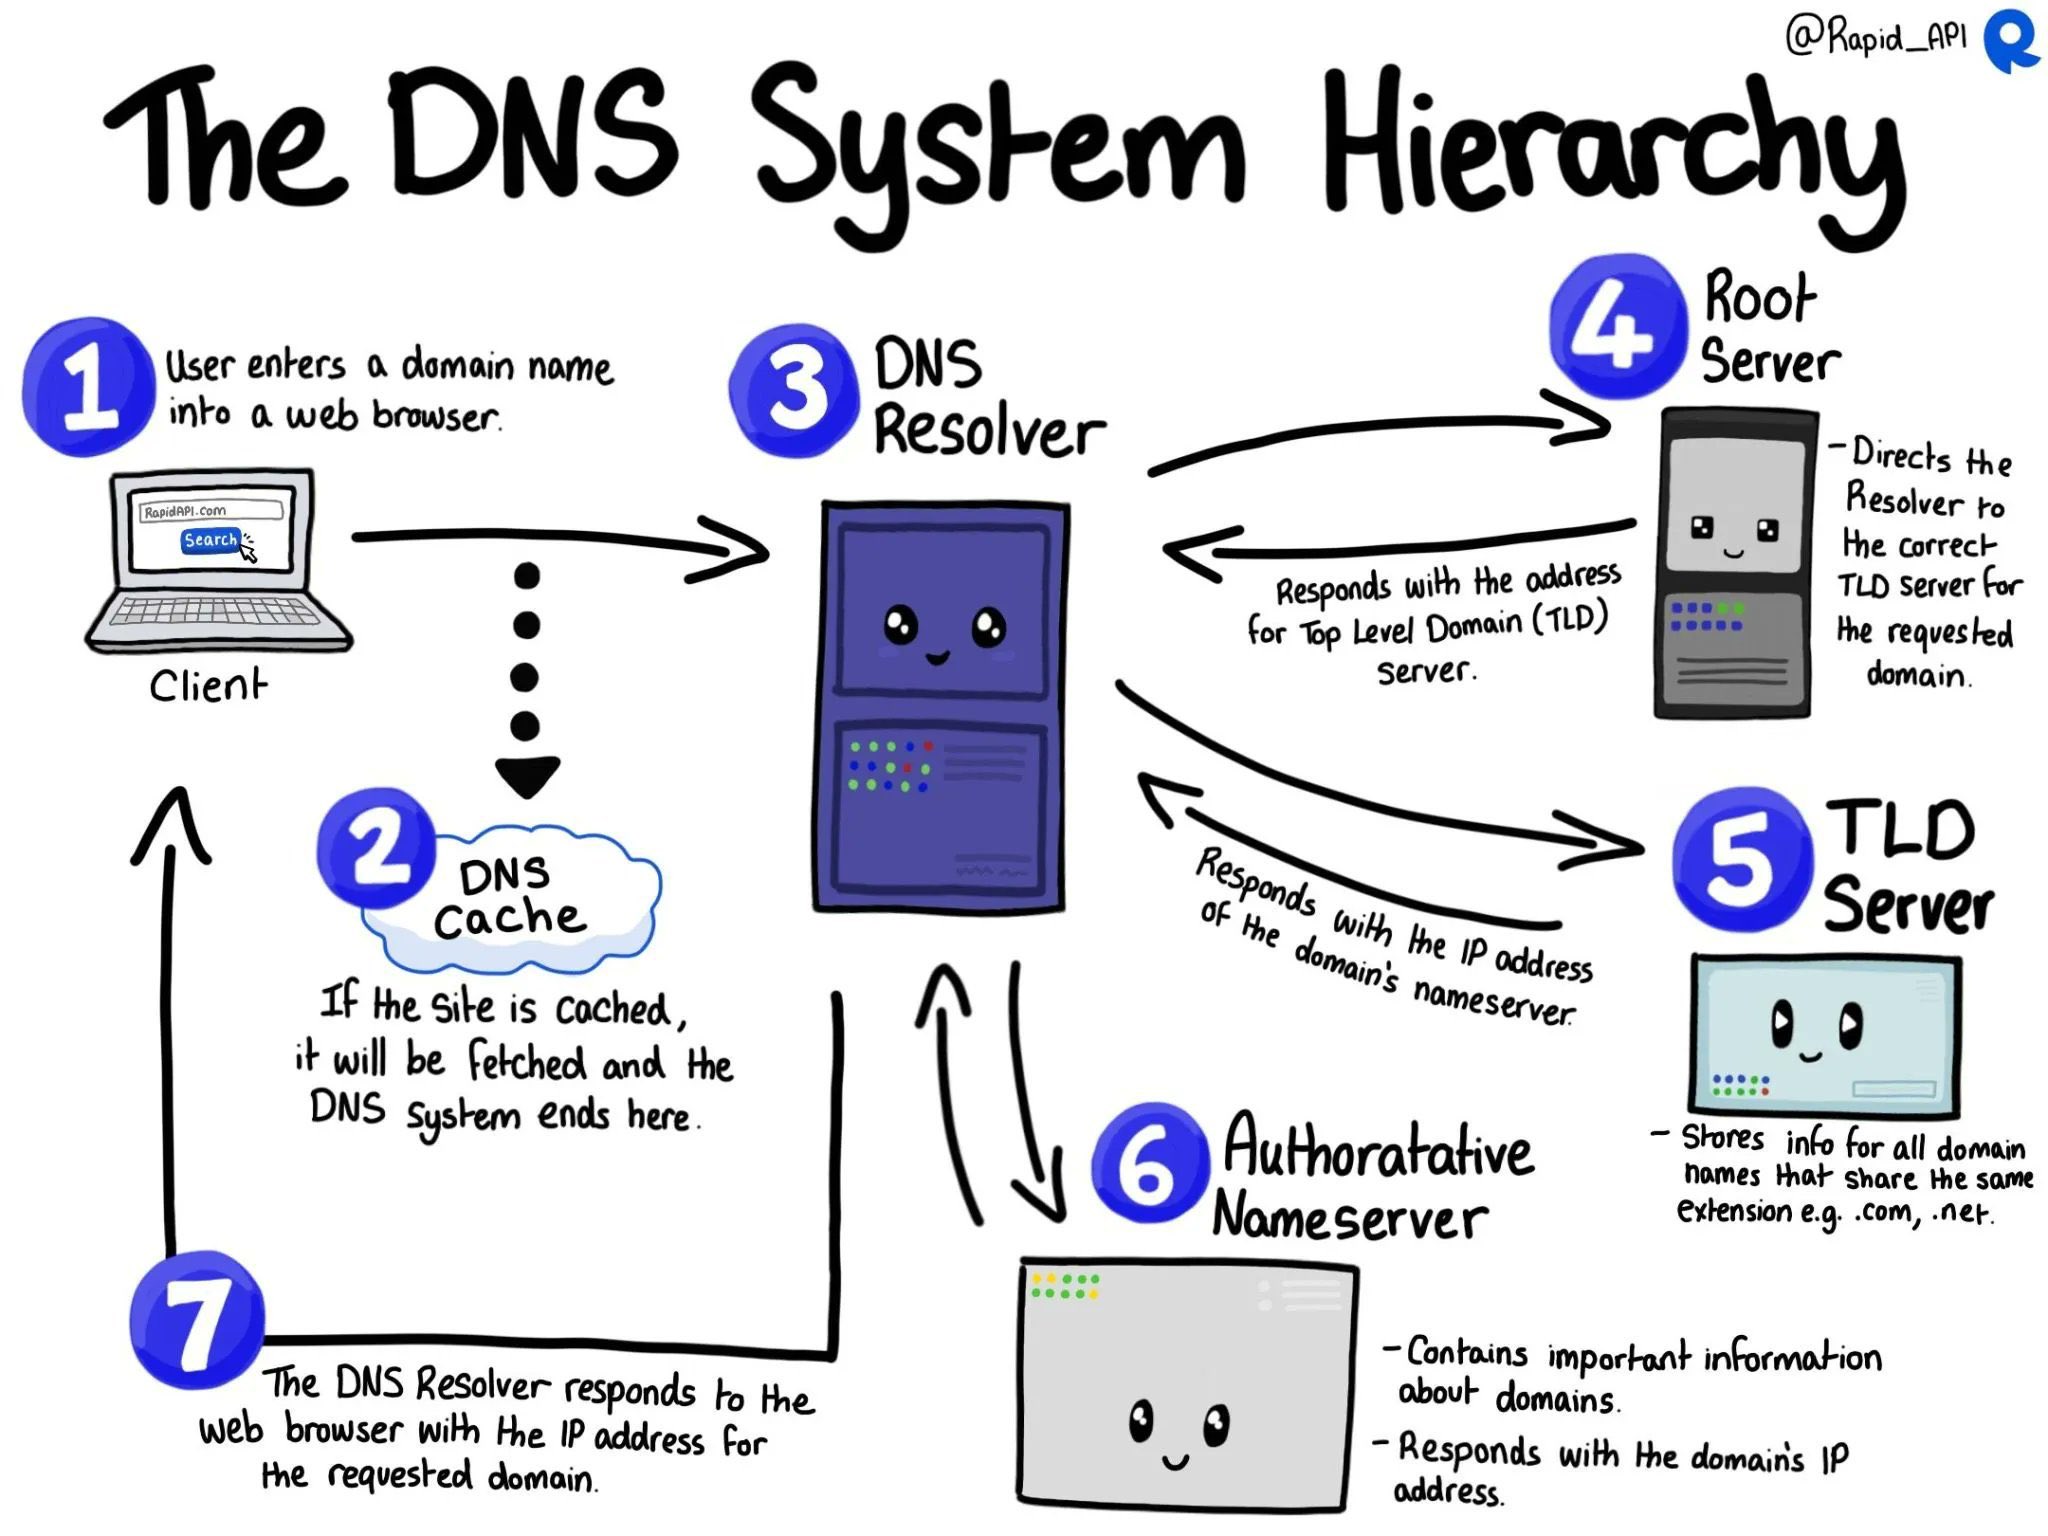
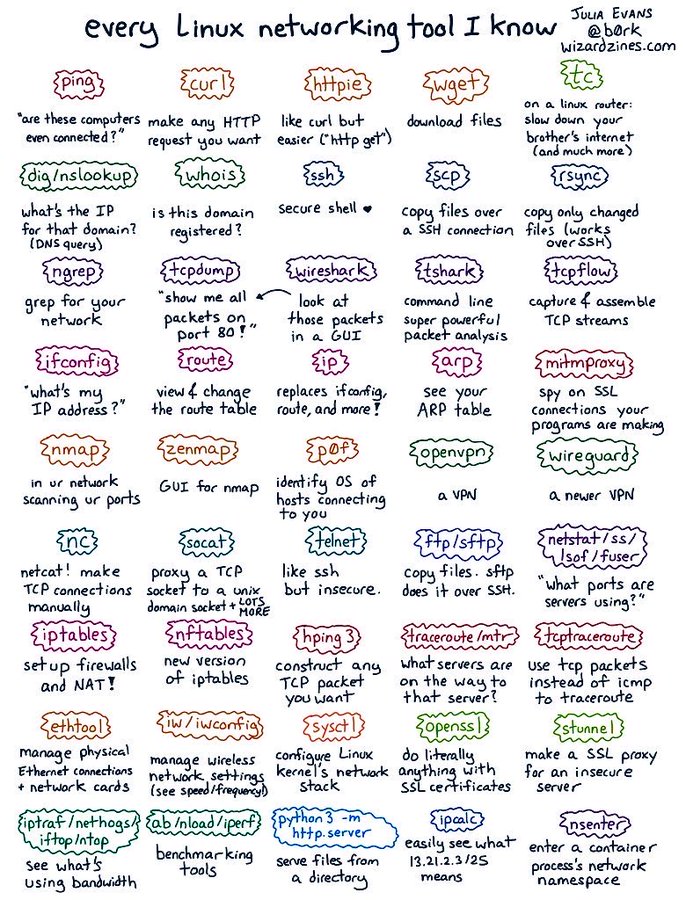
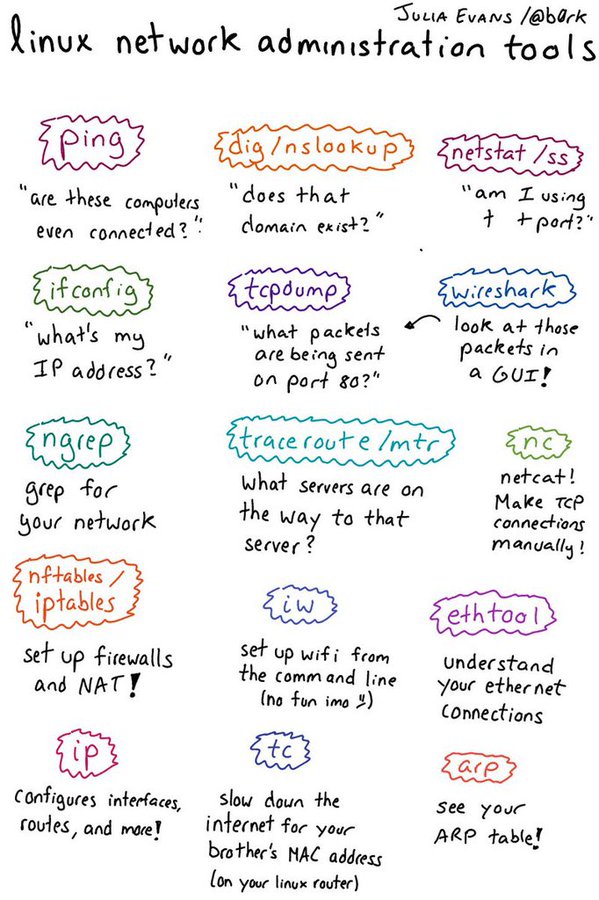
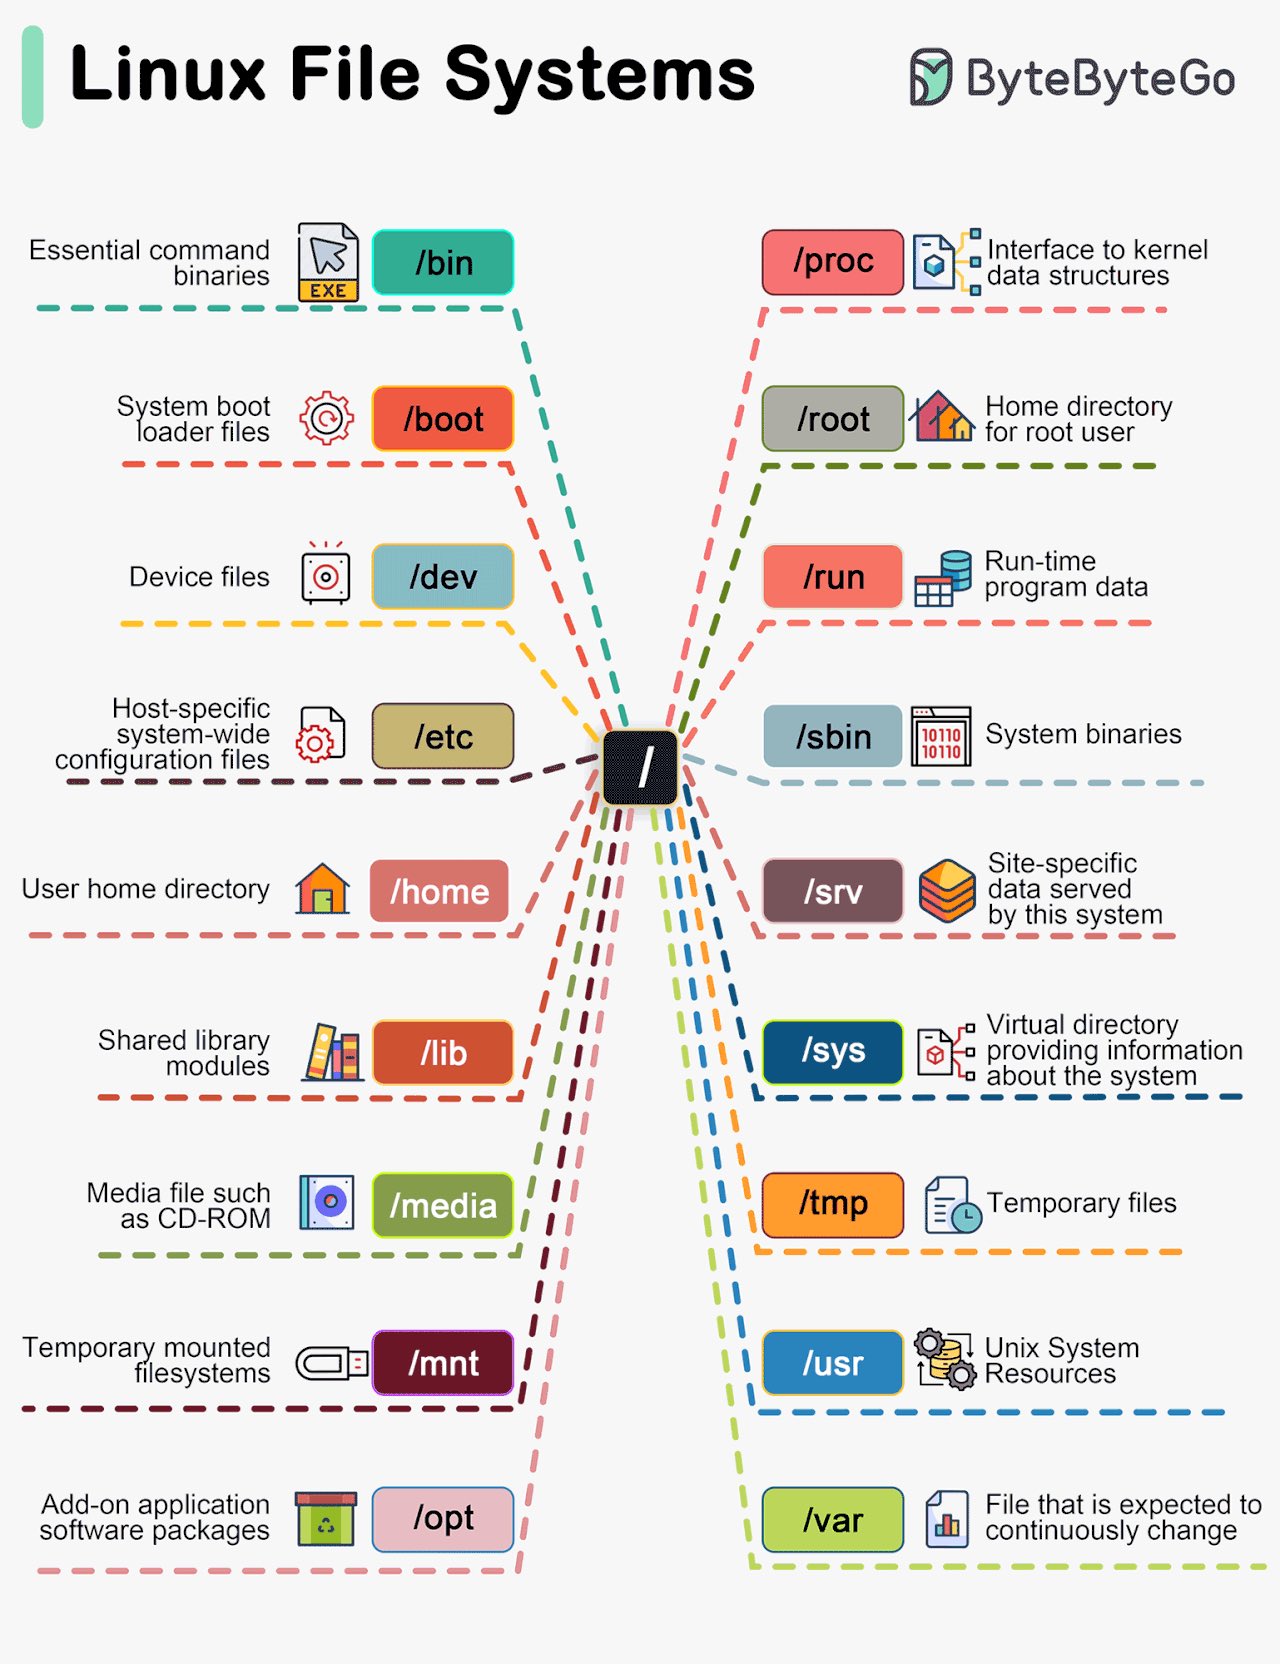
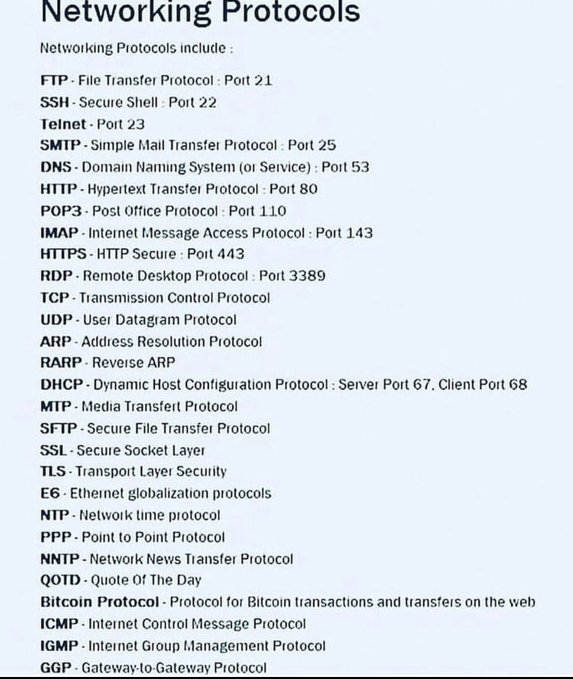
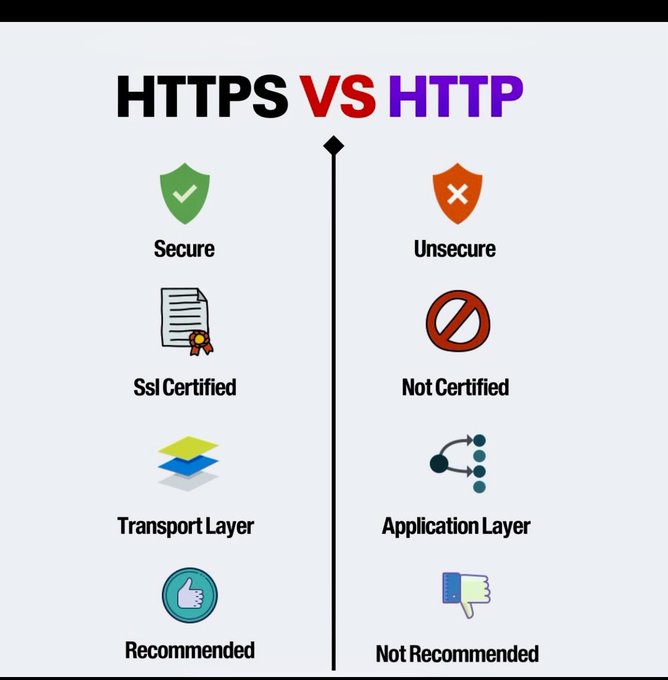
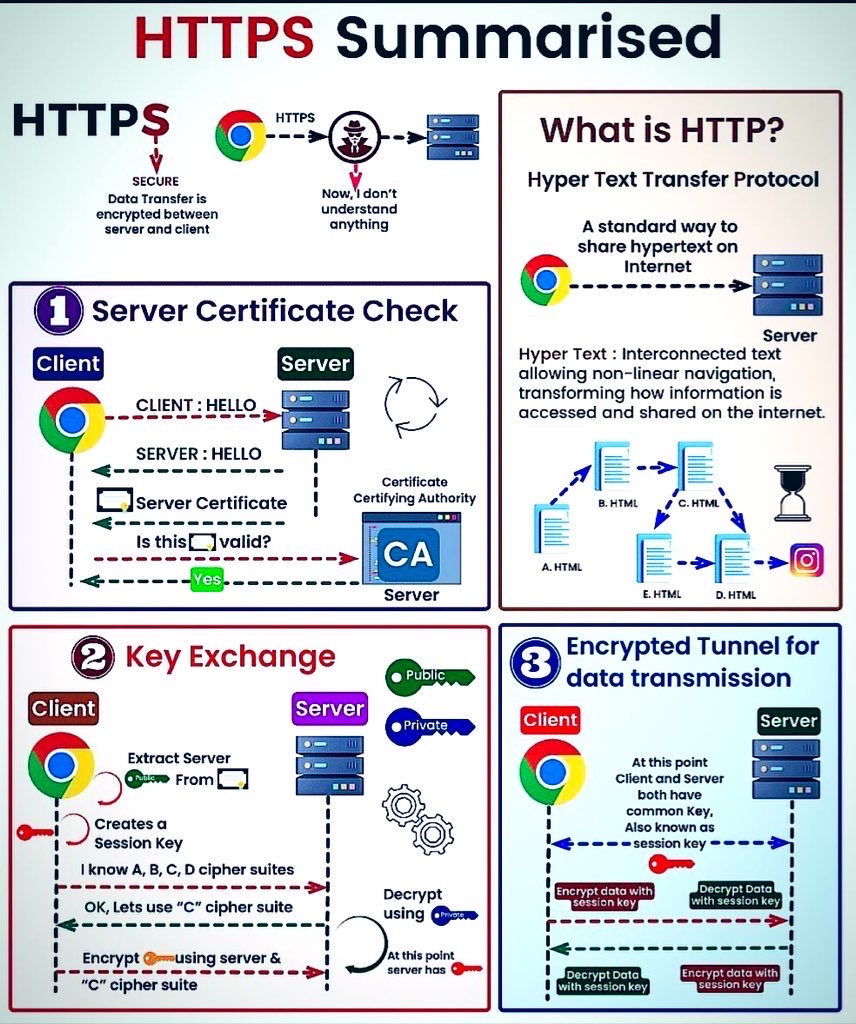
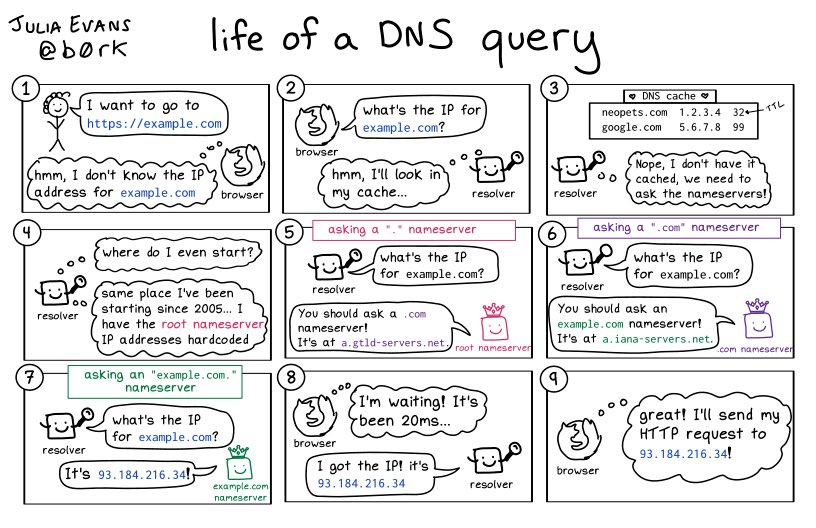
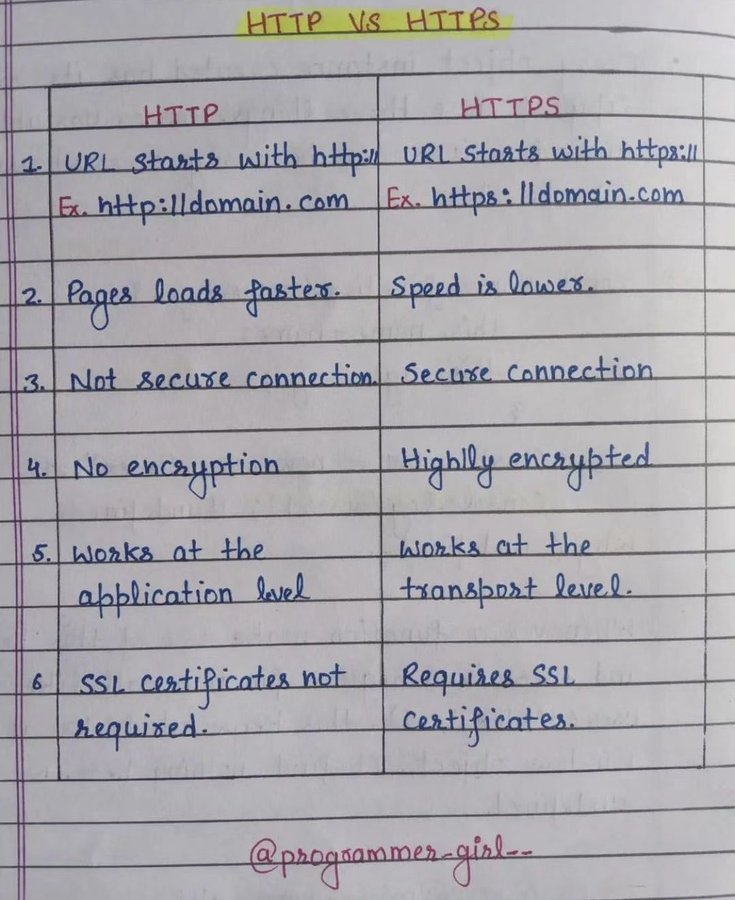
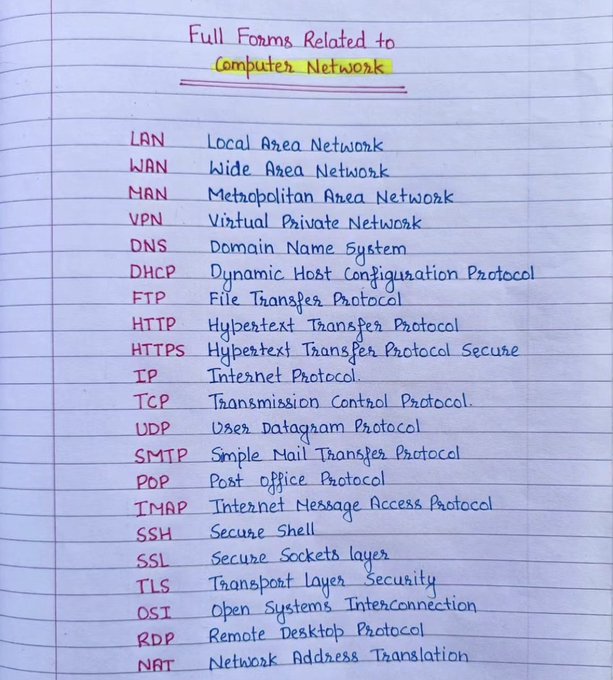
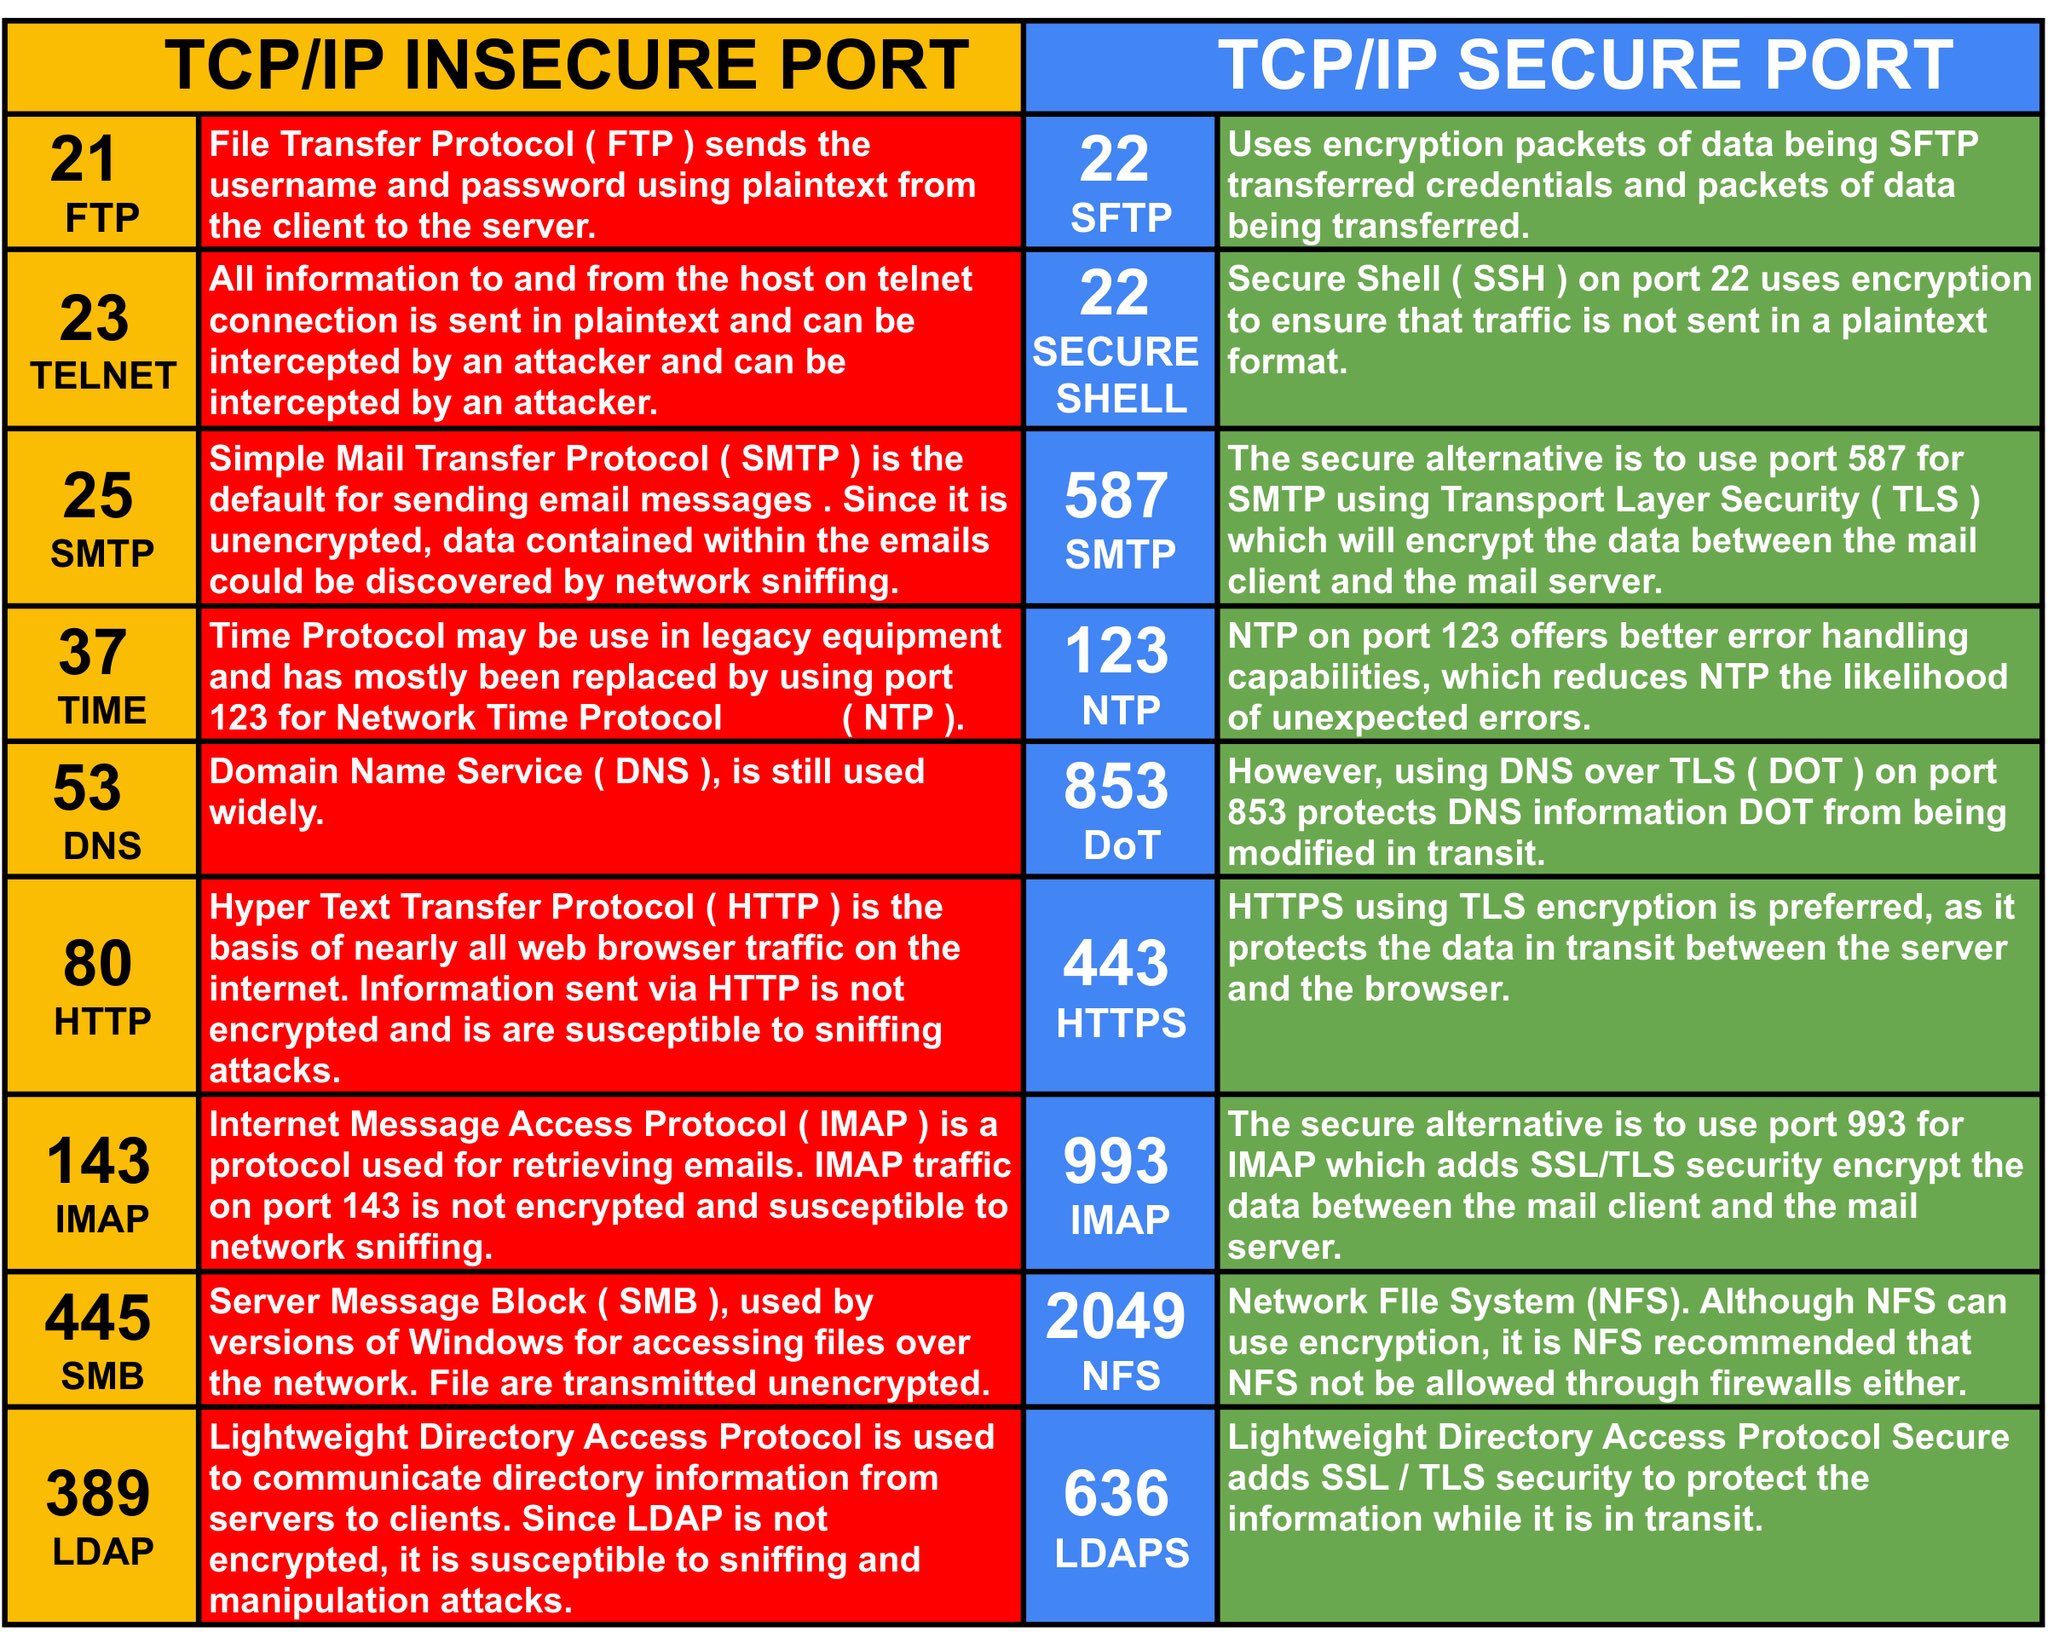
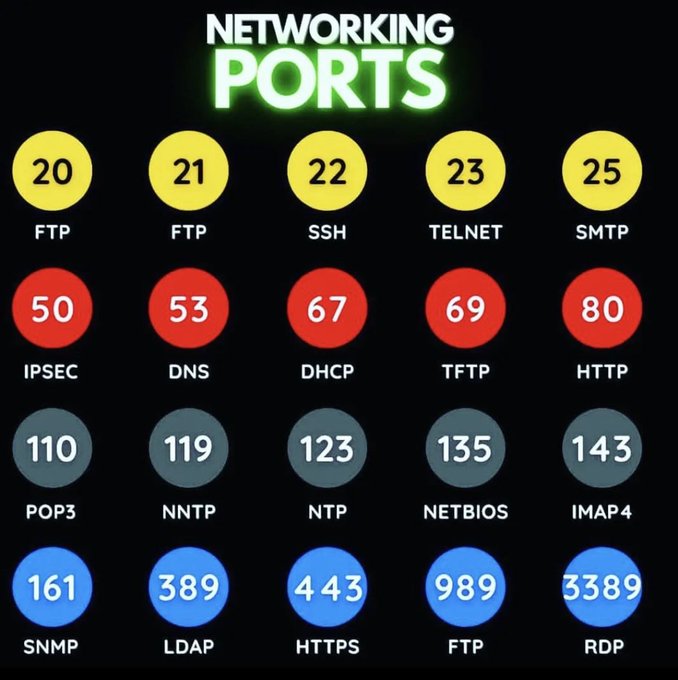
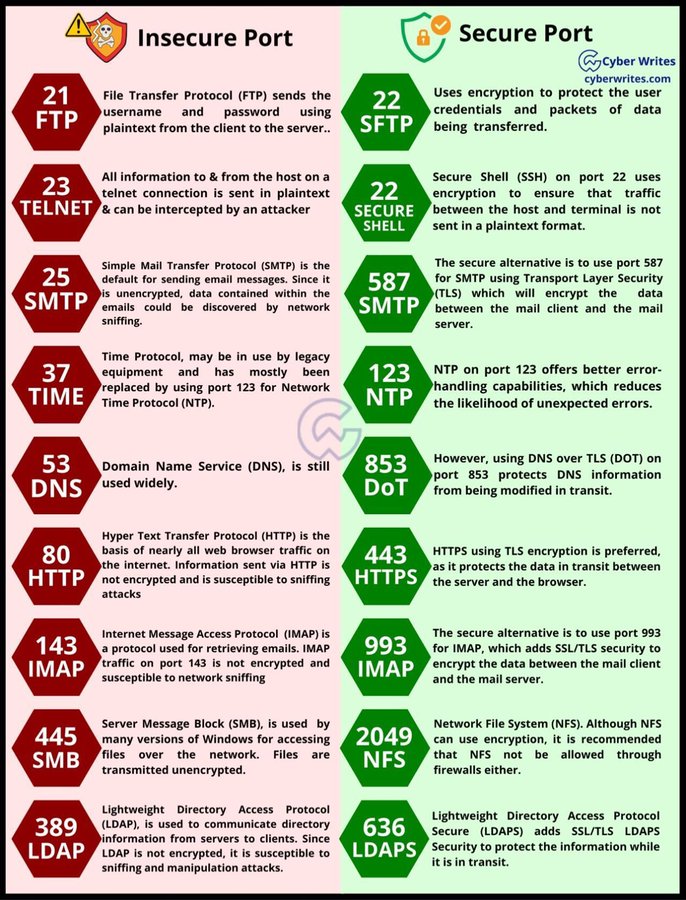
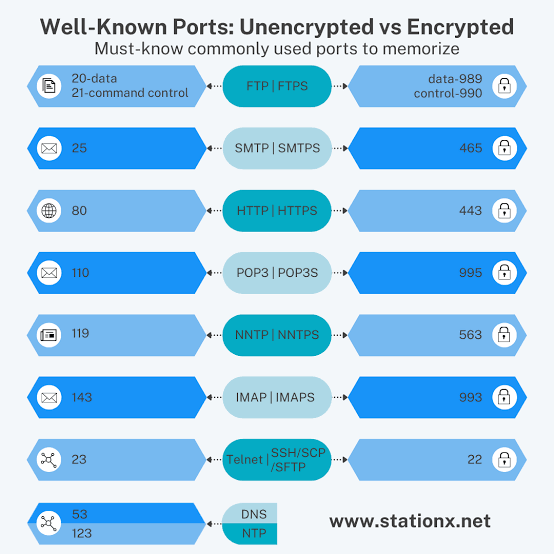
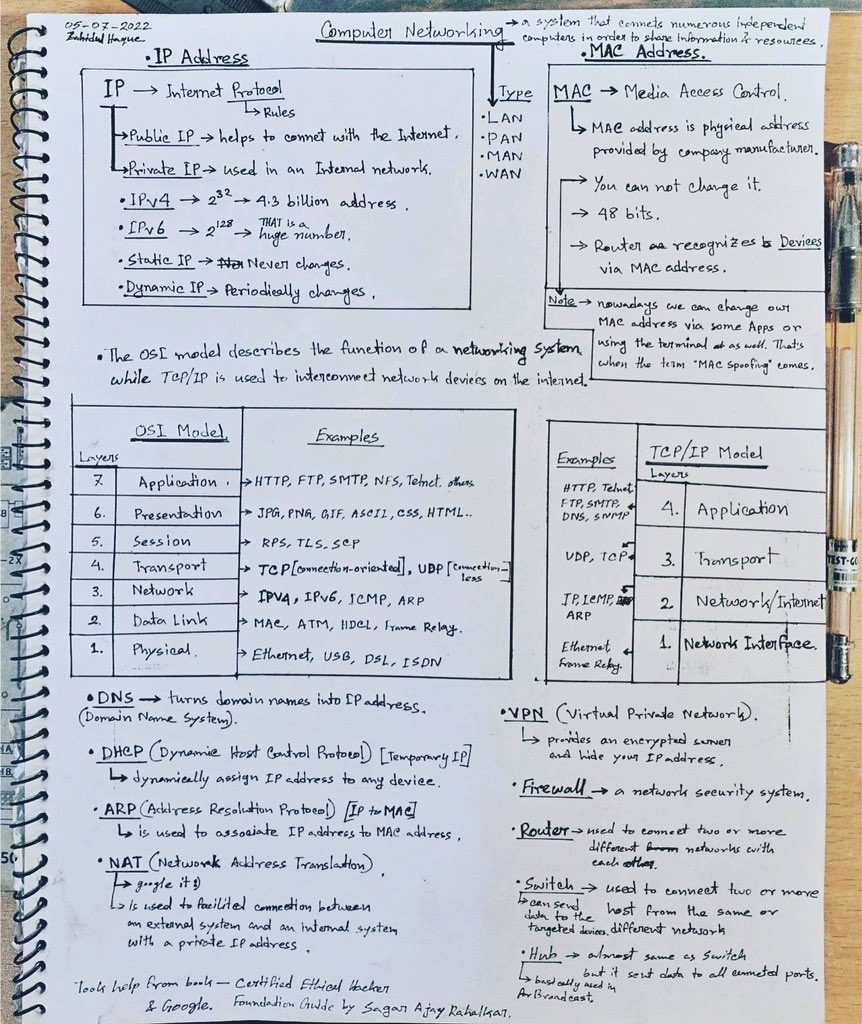
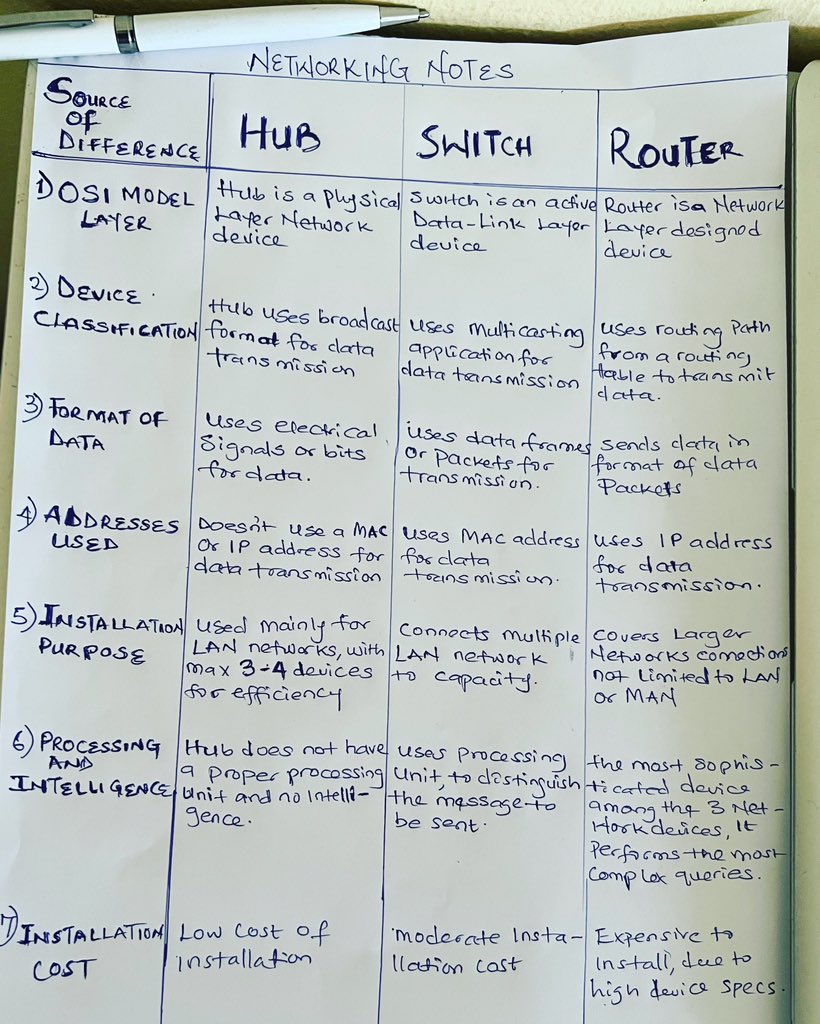
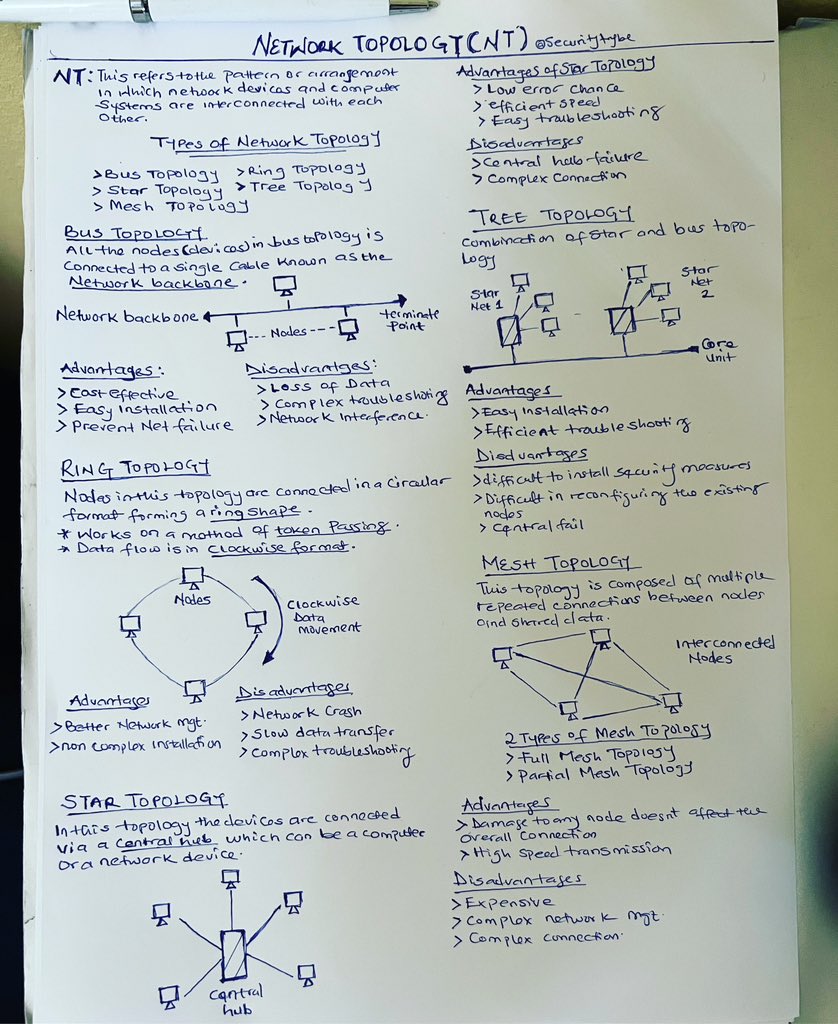
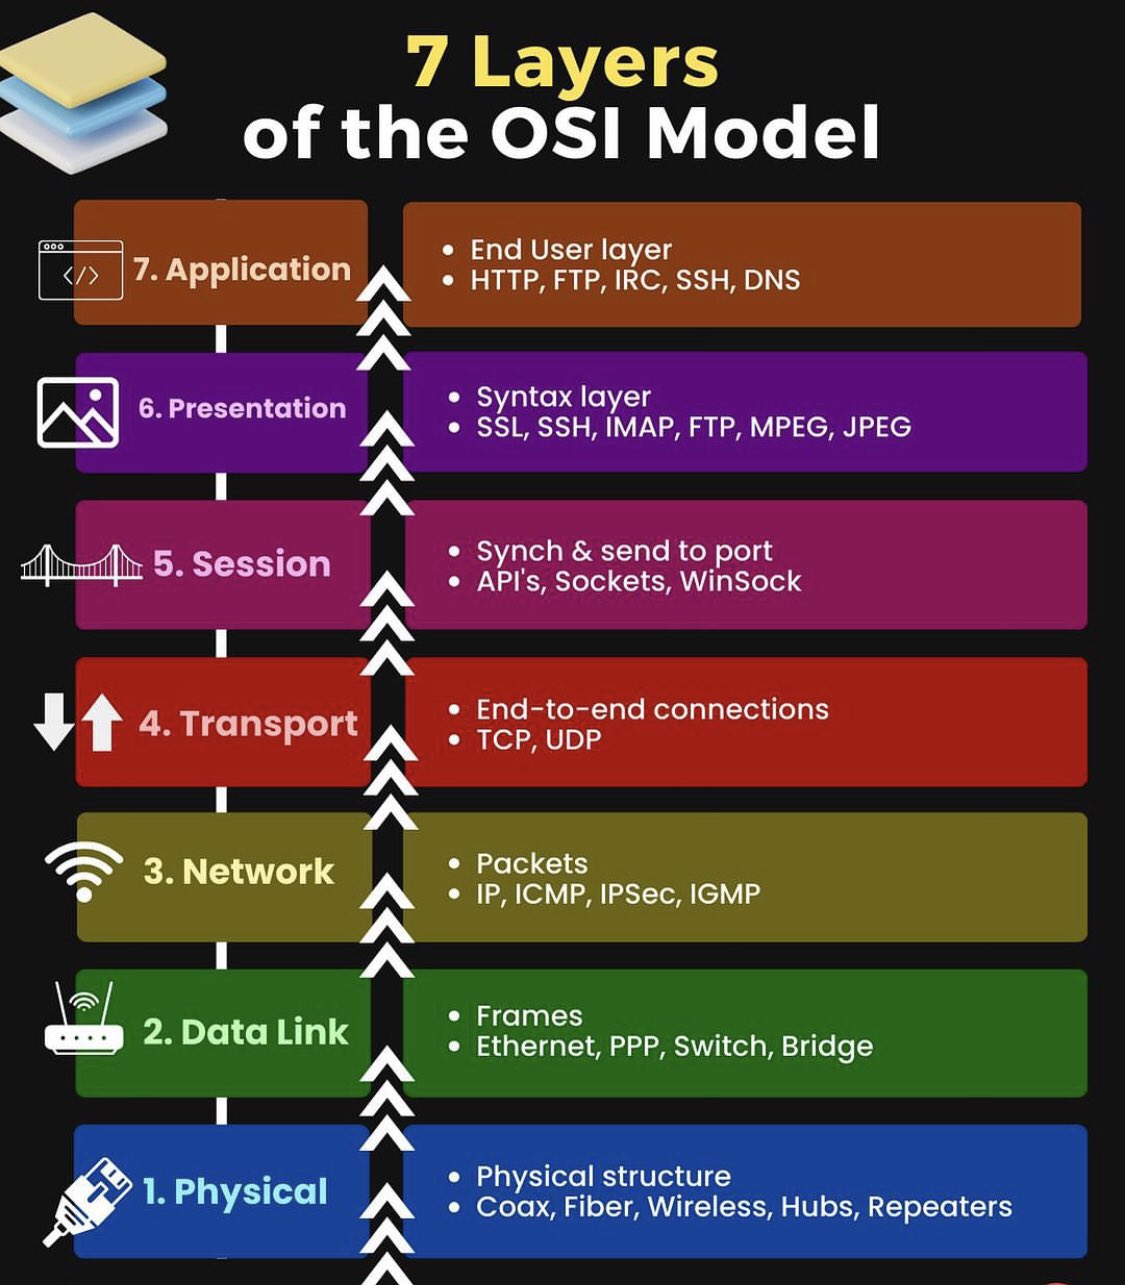
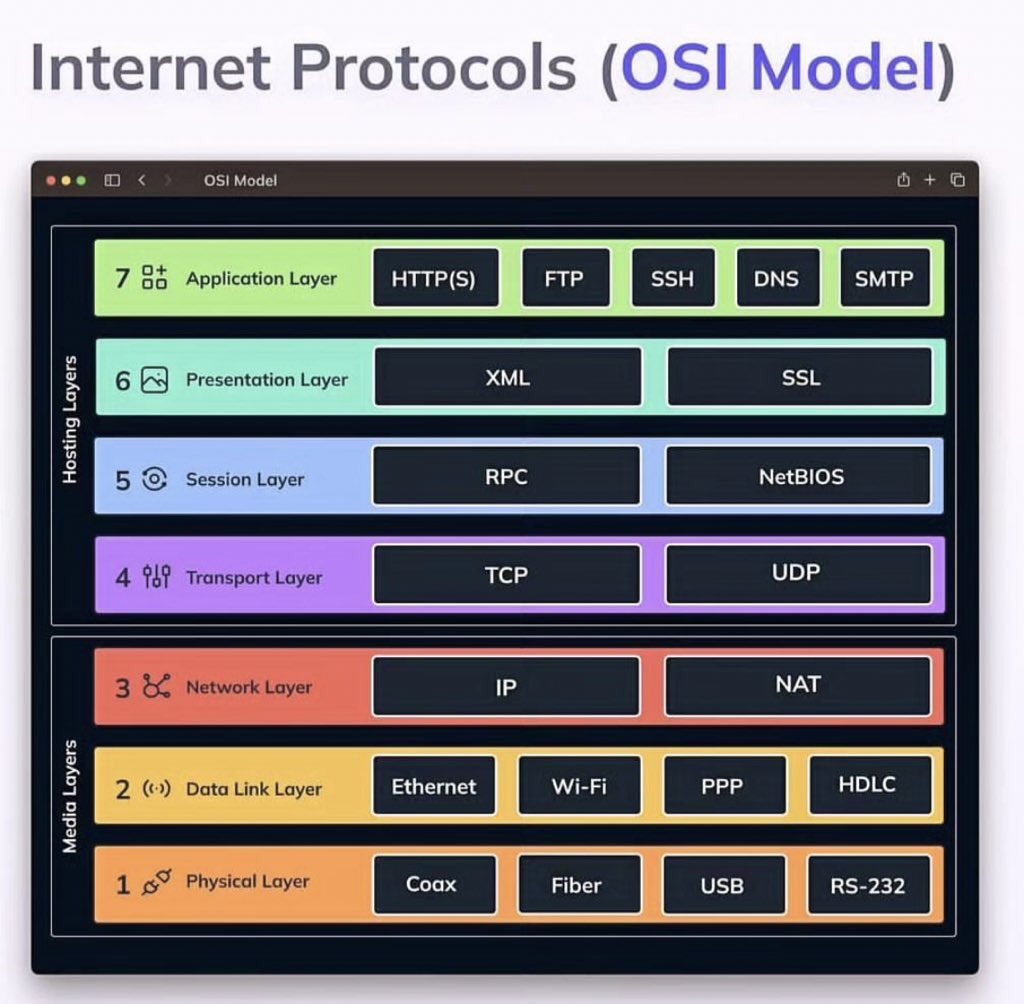
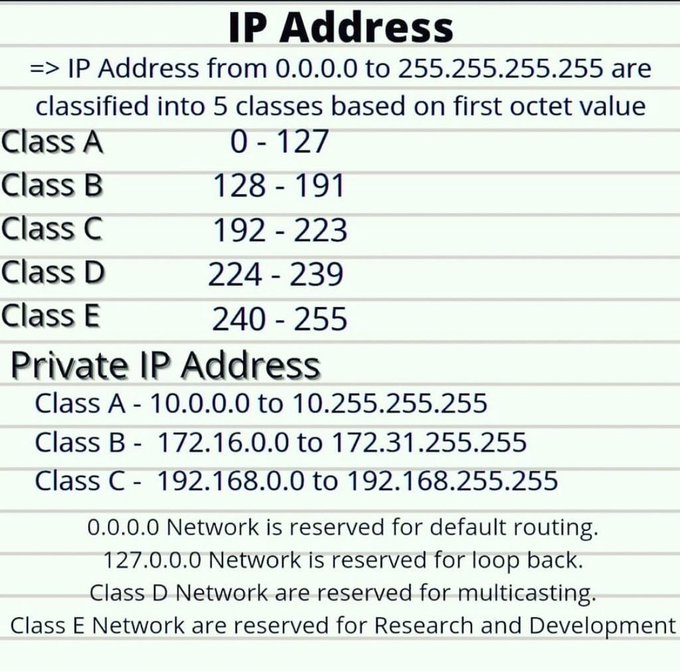
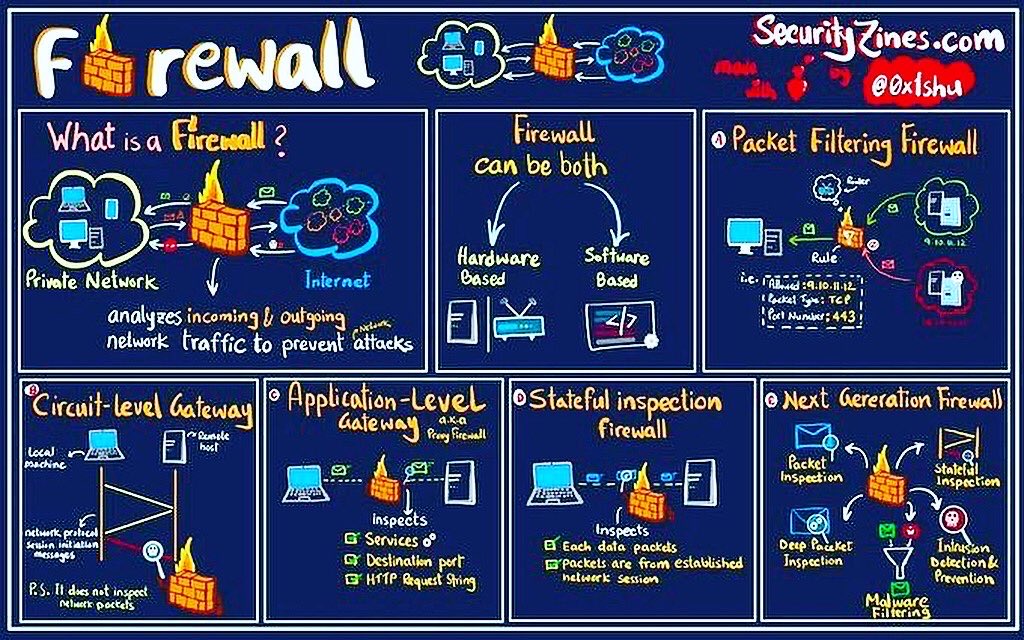
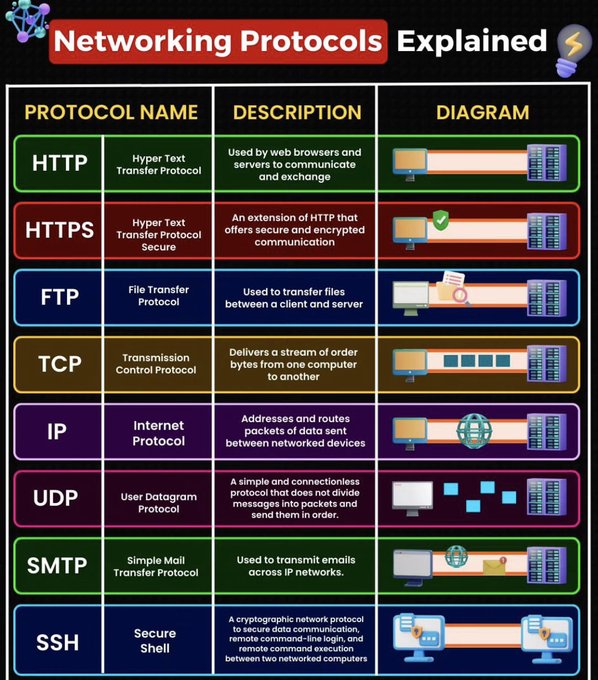
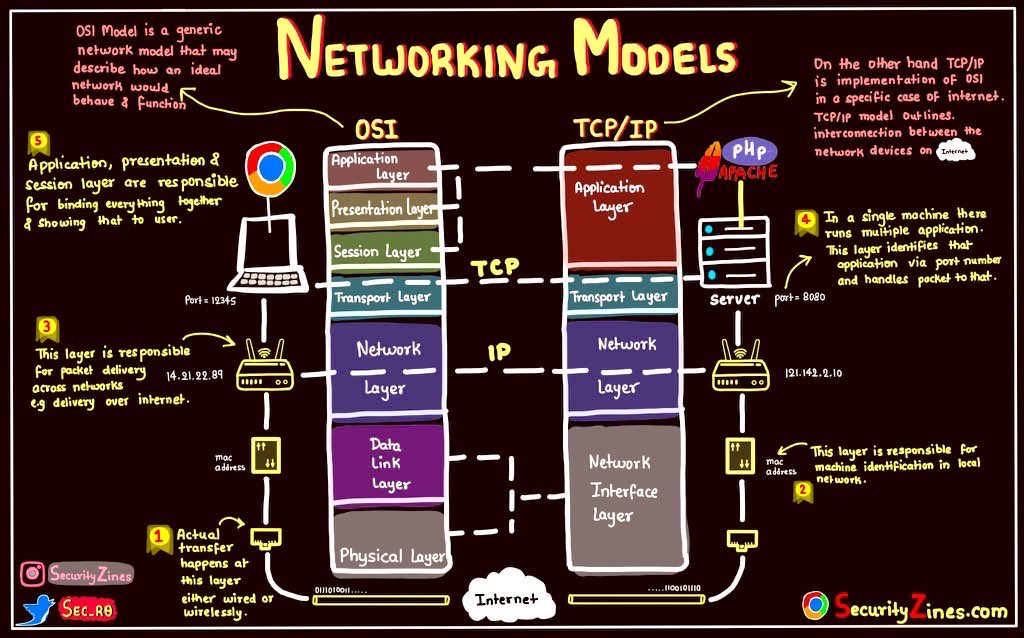
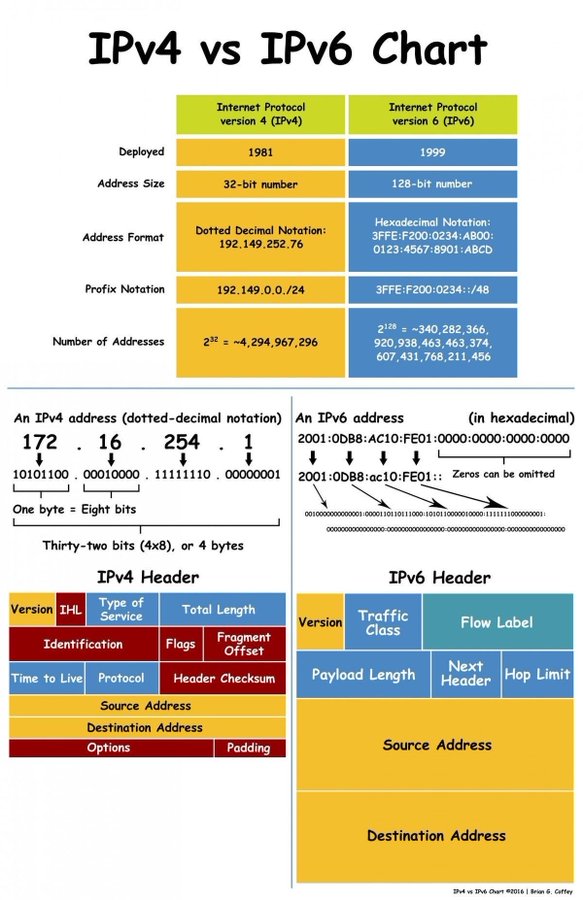
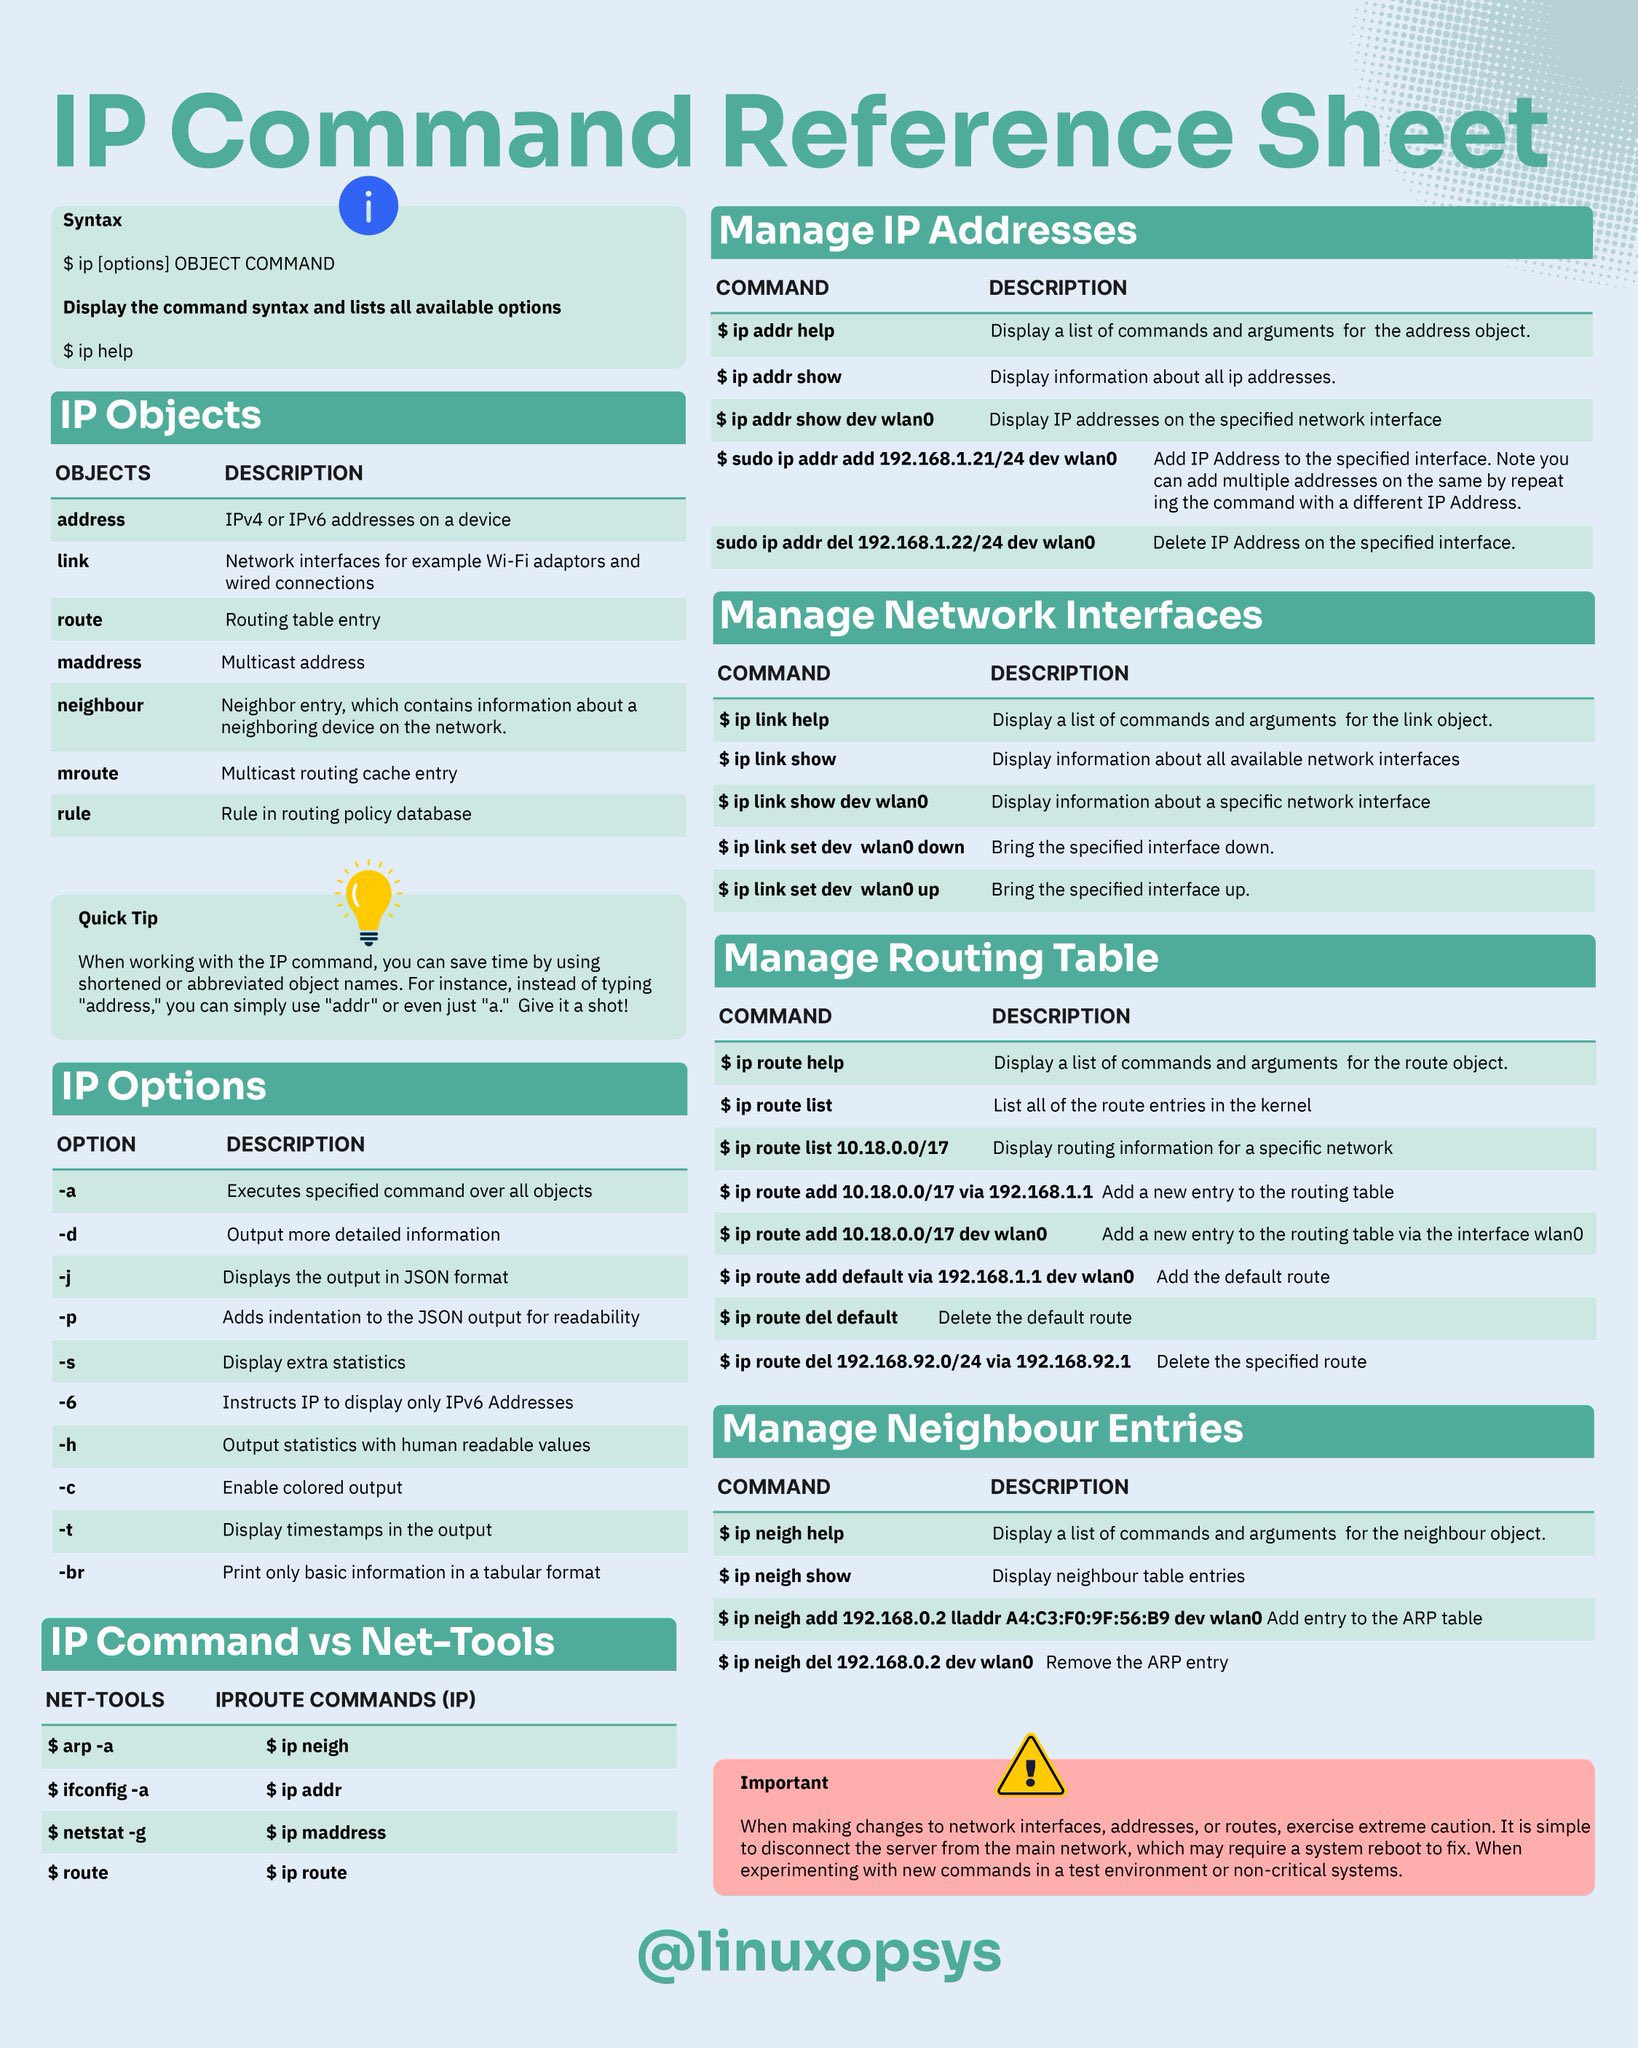
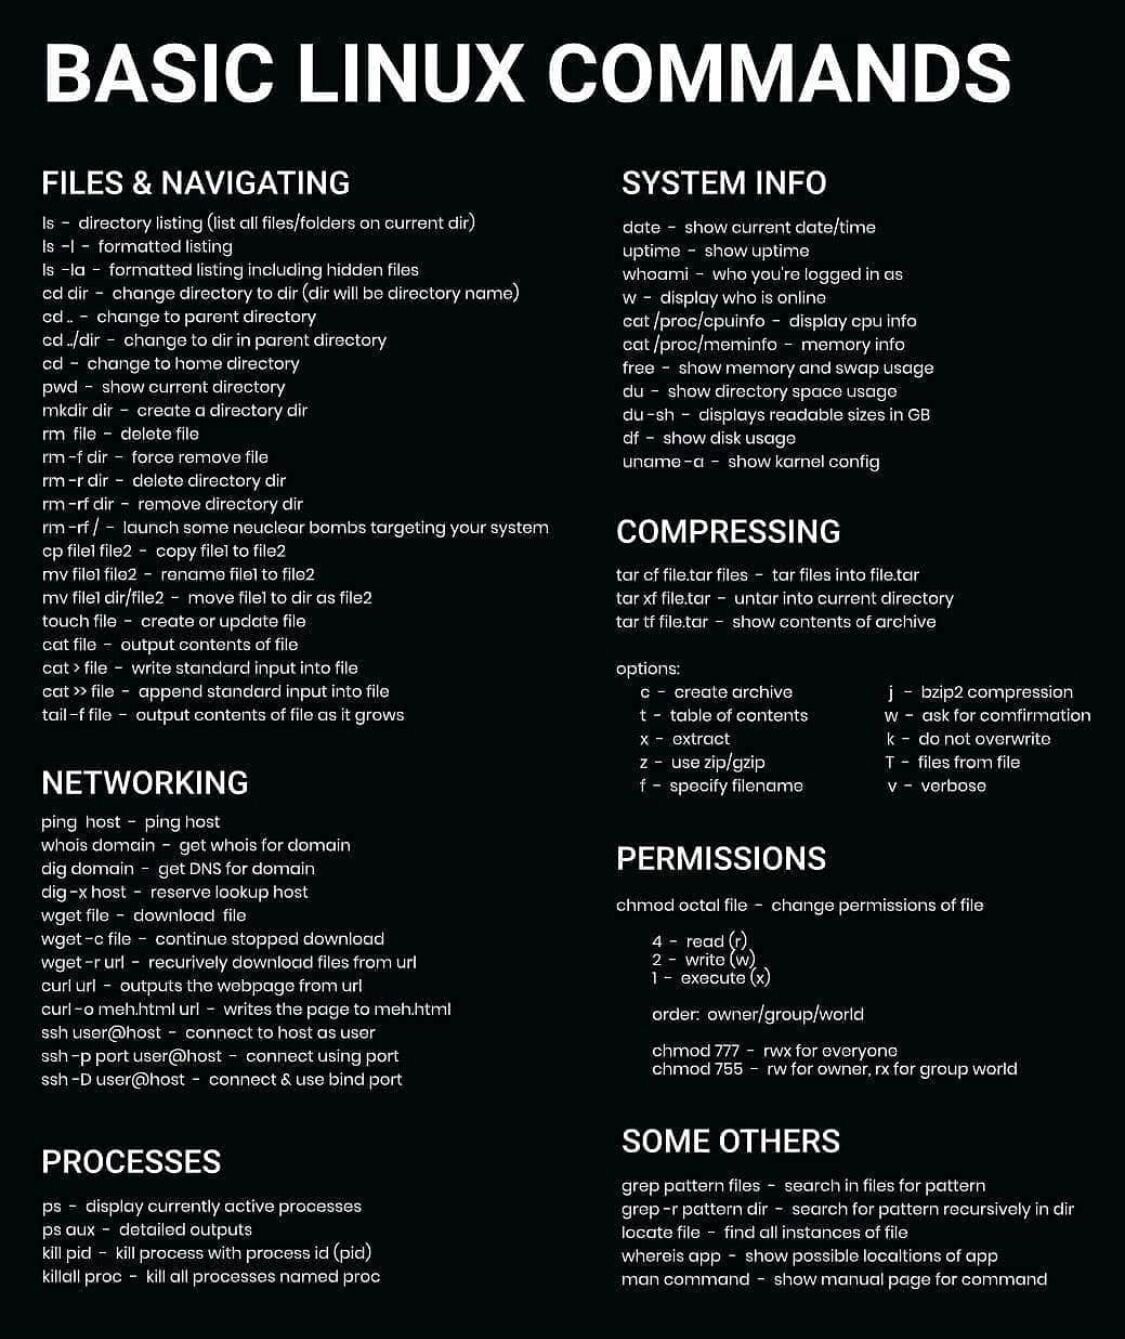
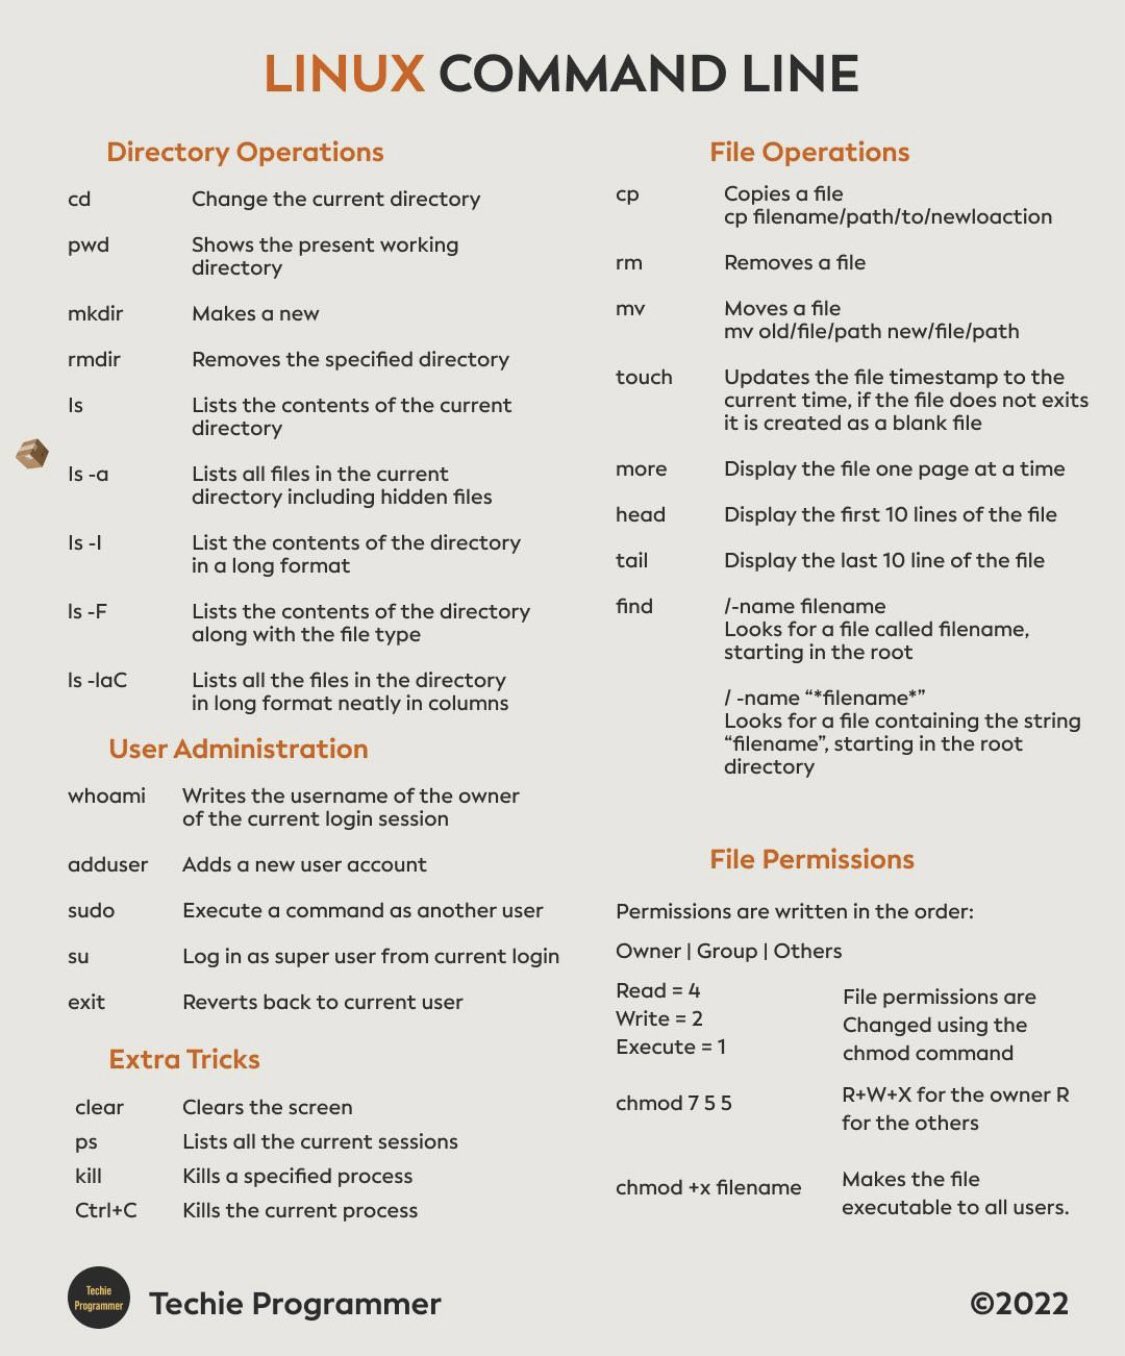
4
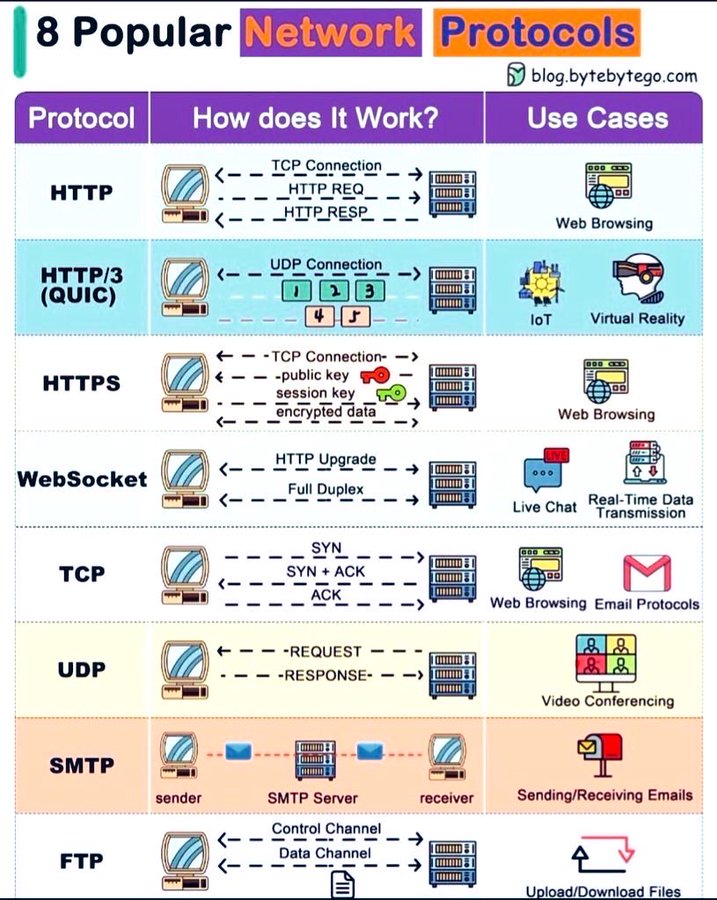
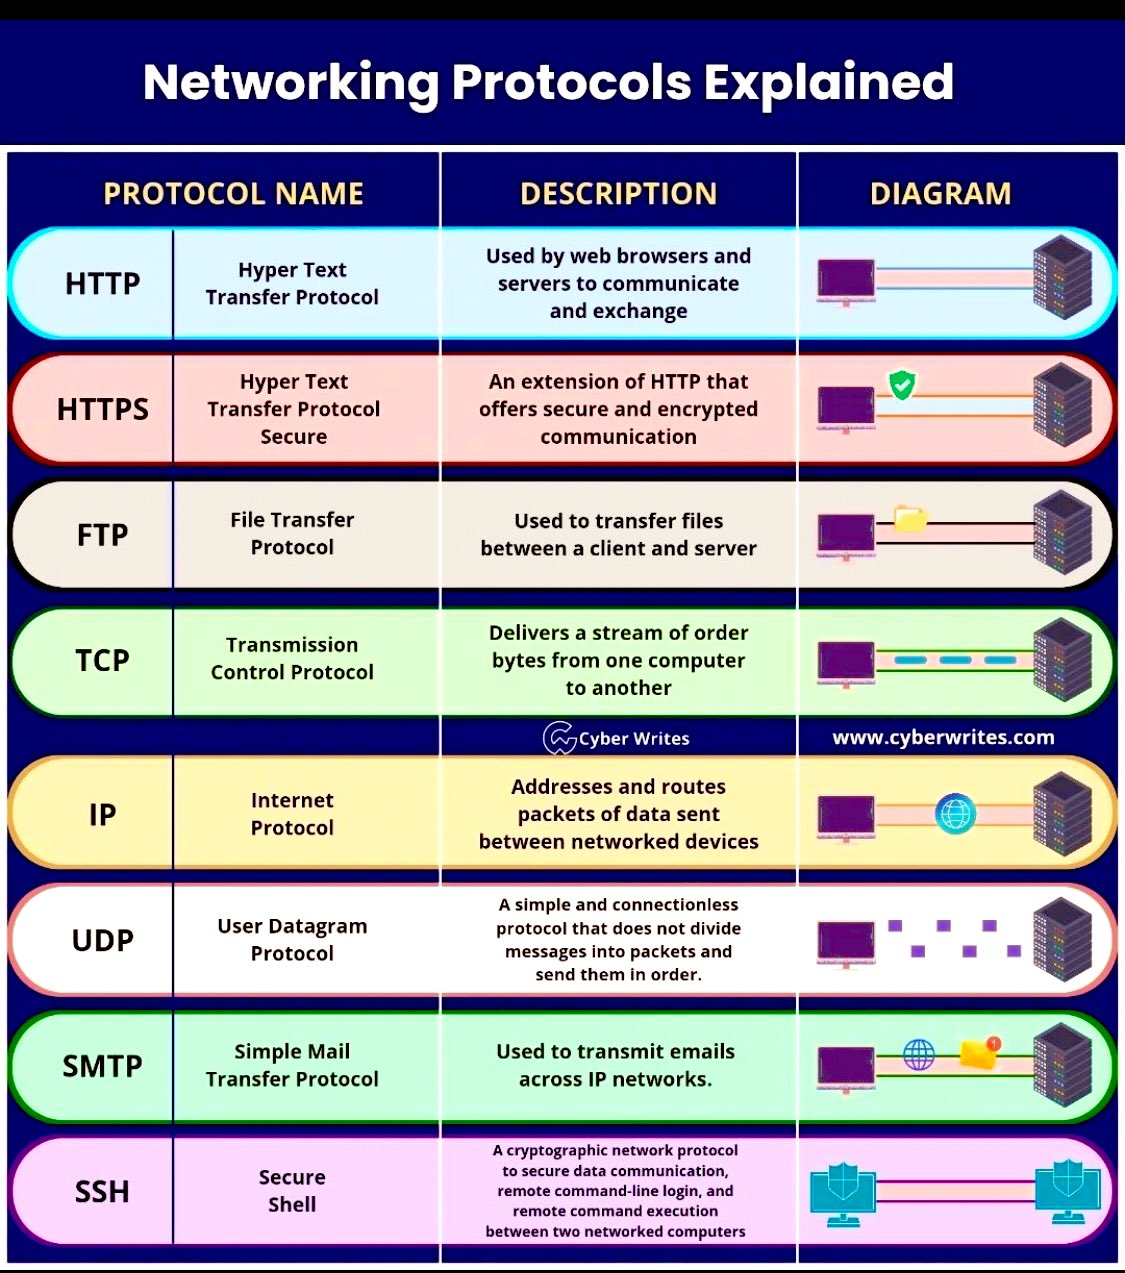
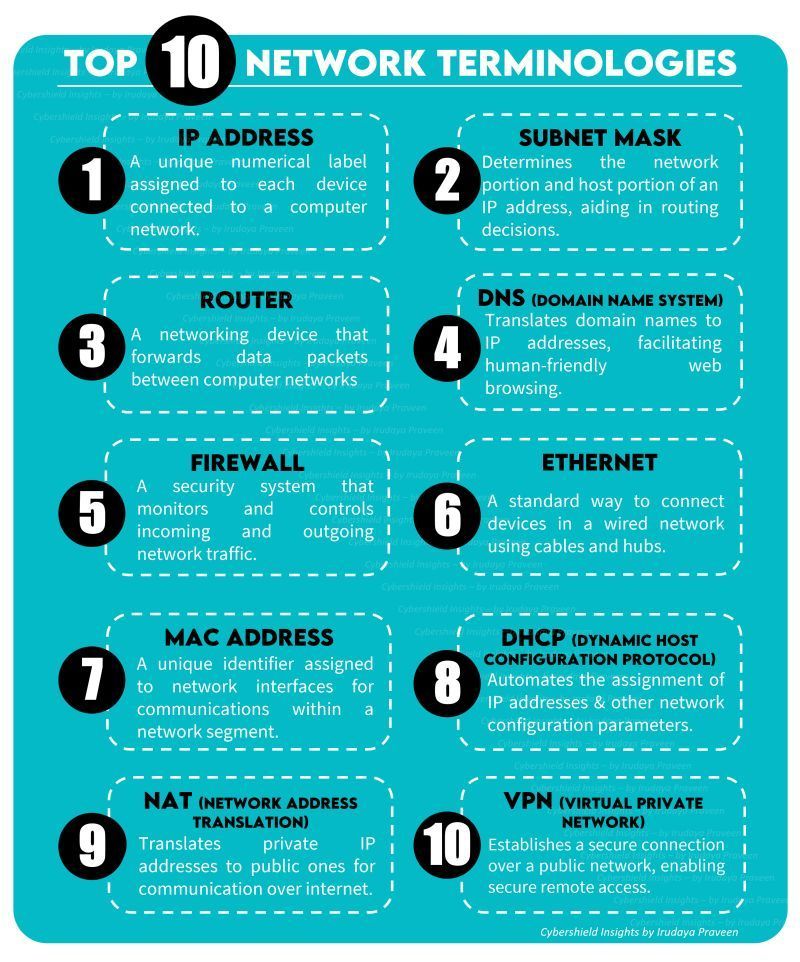
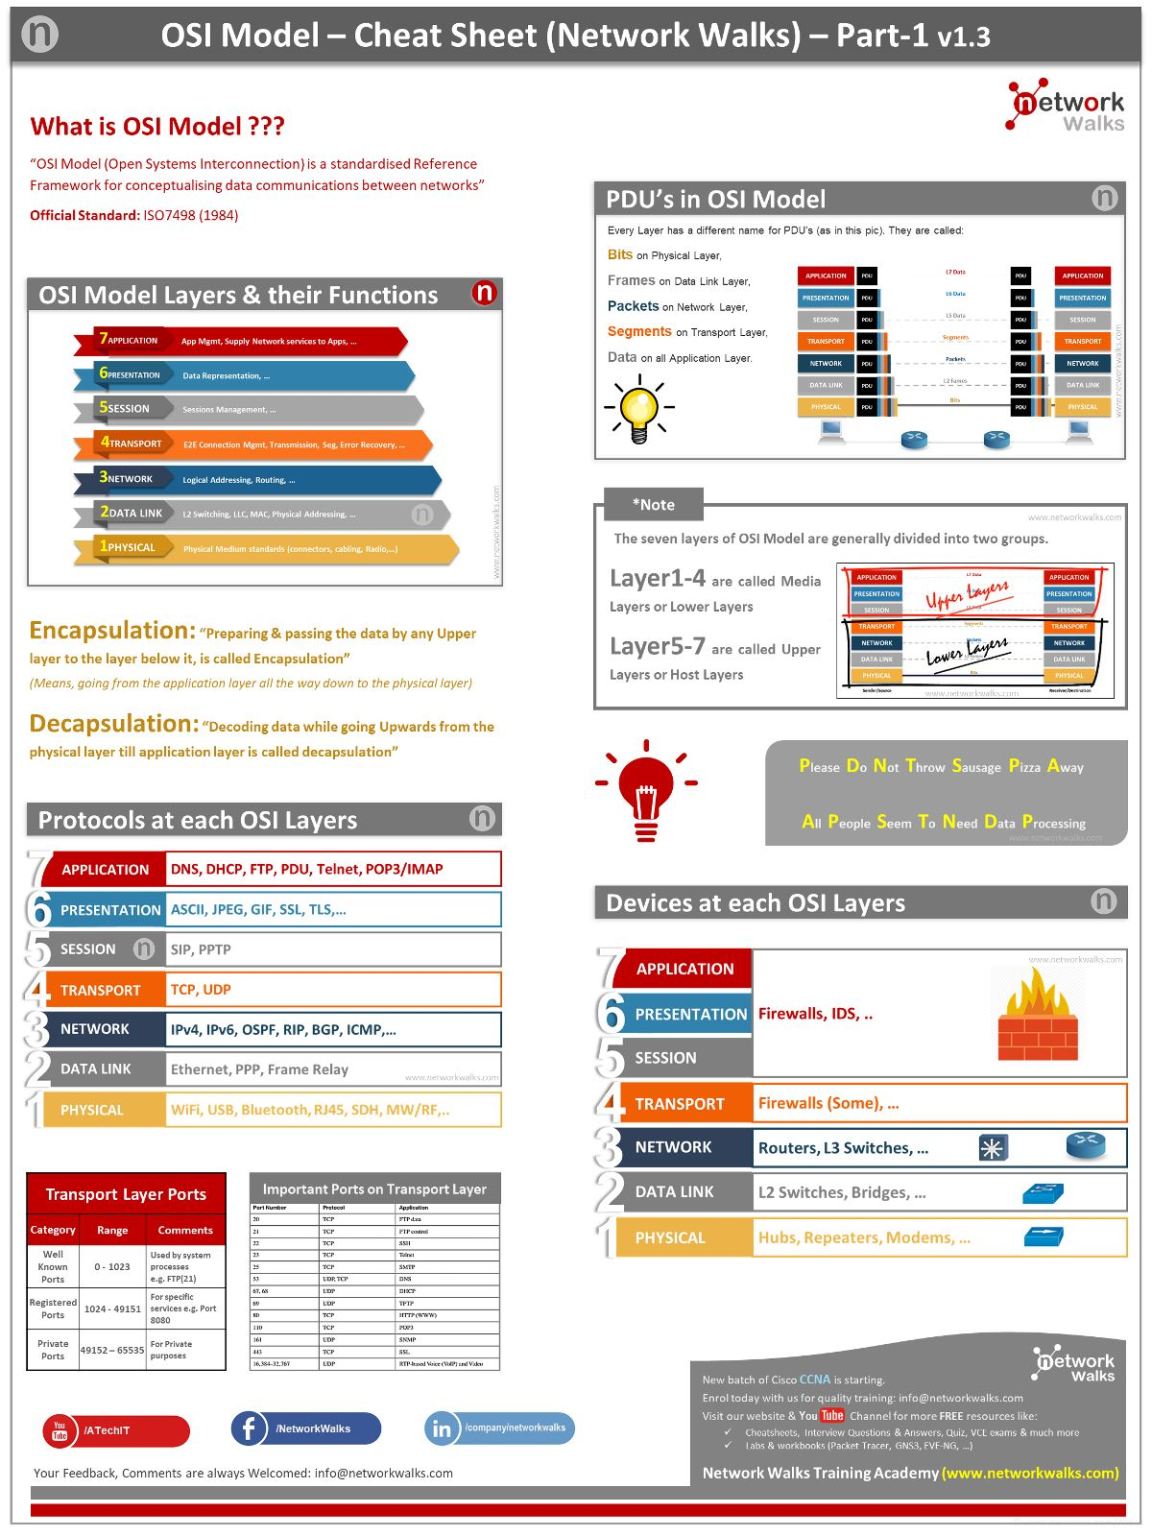
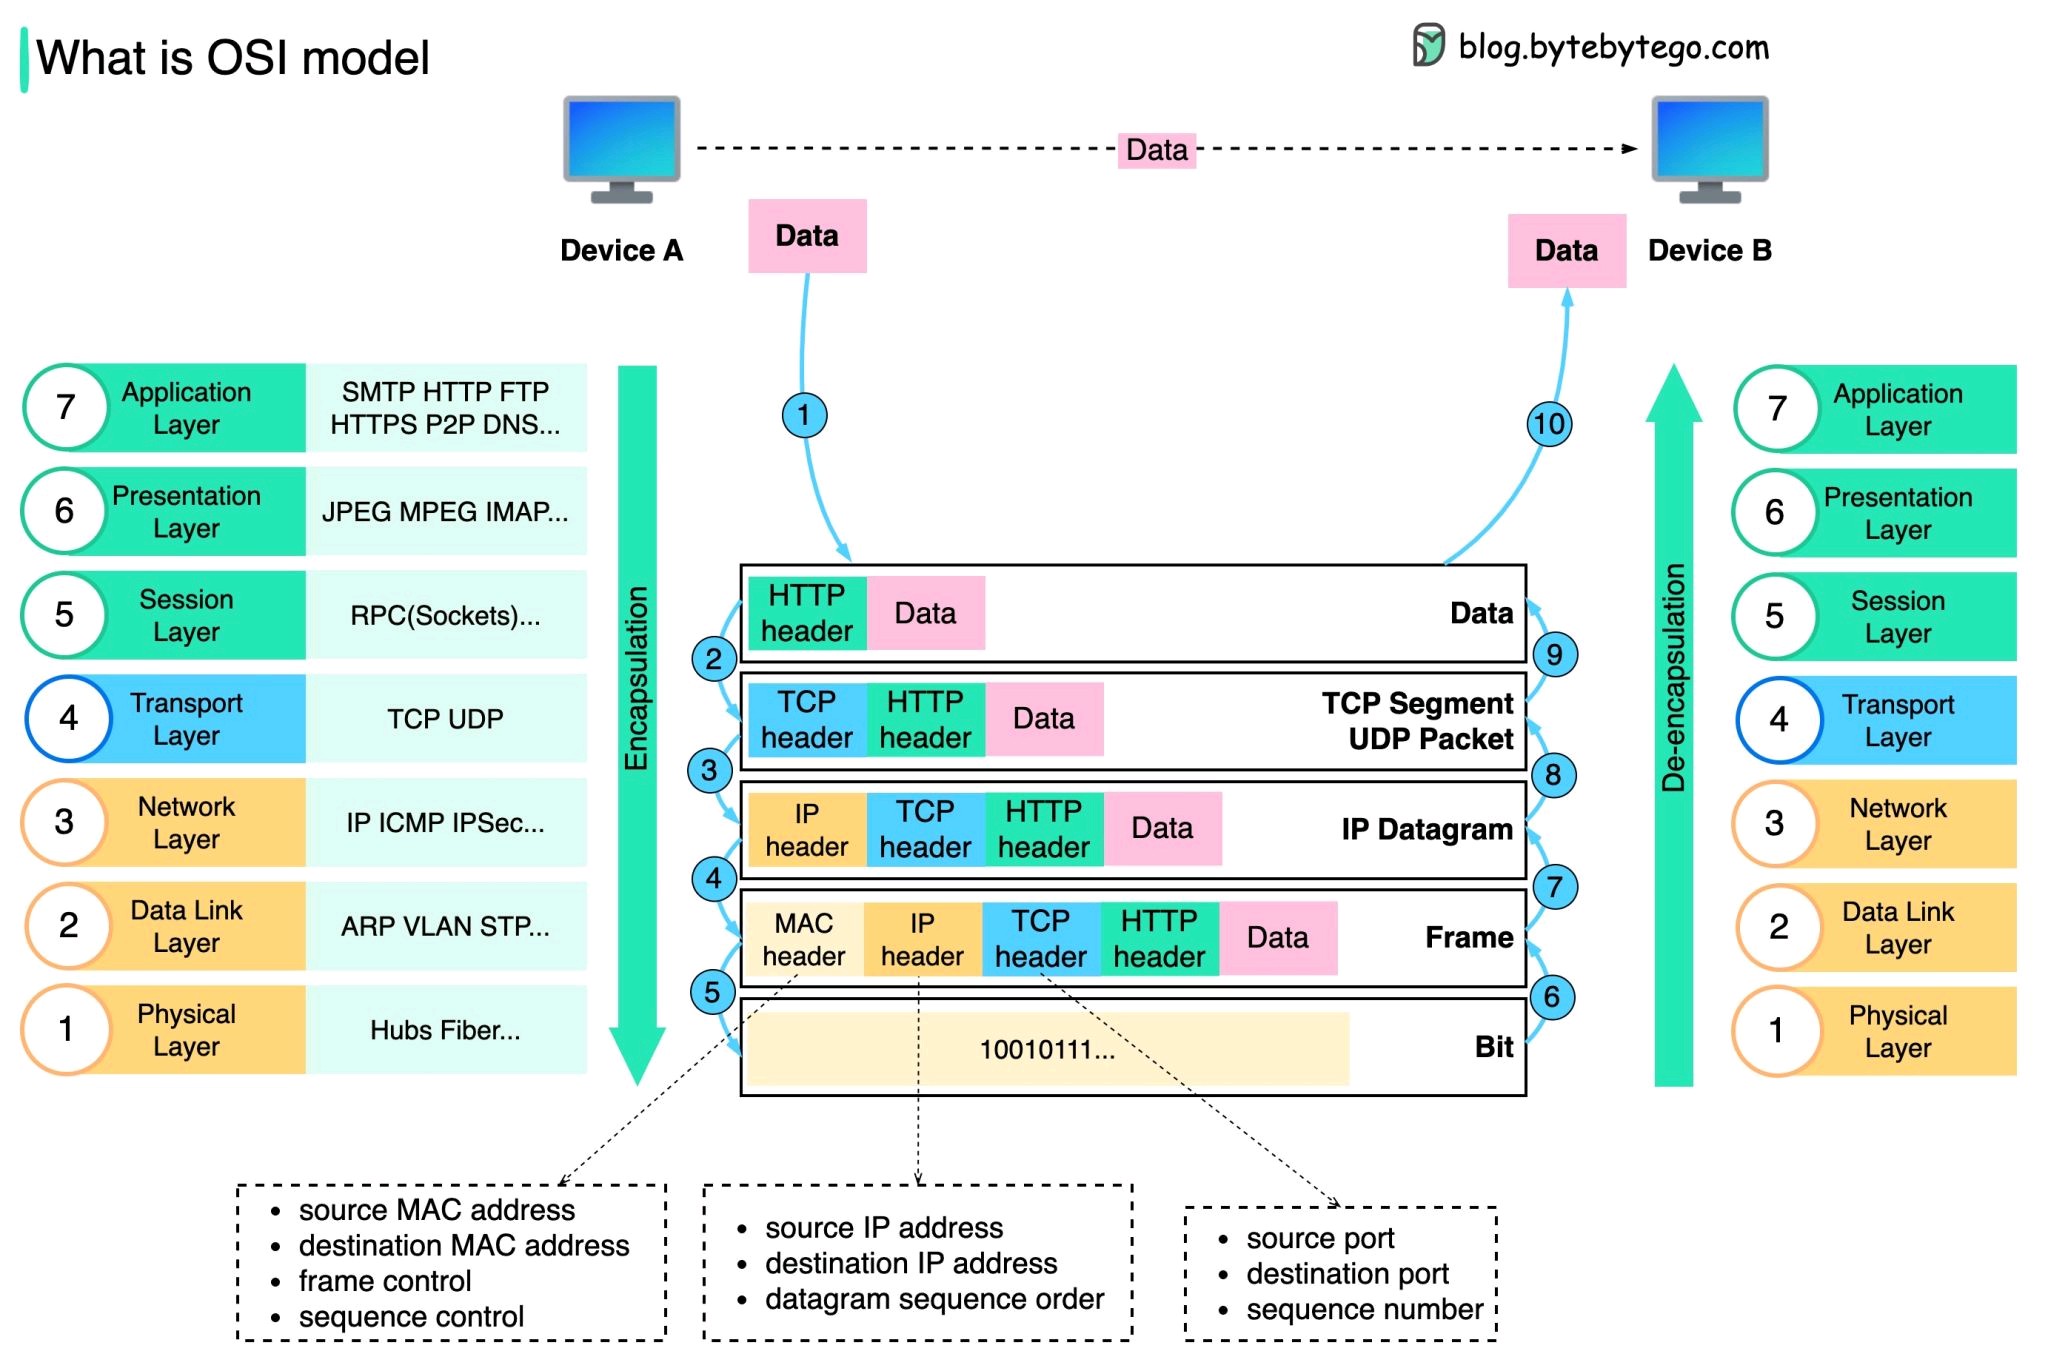
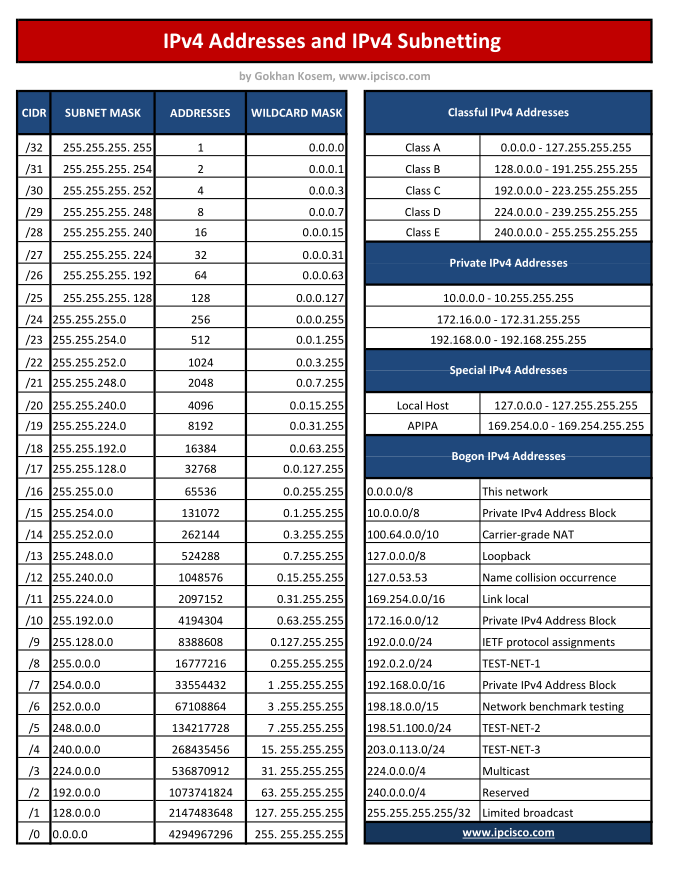
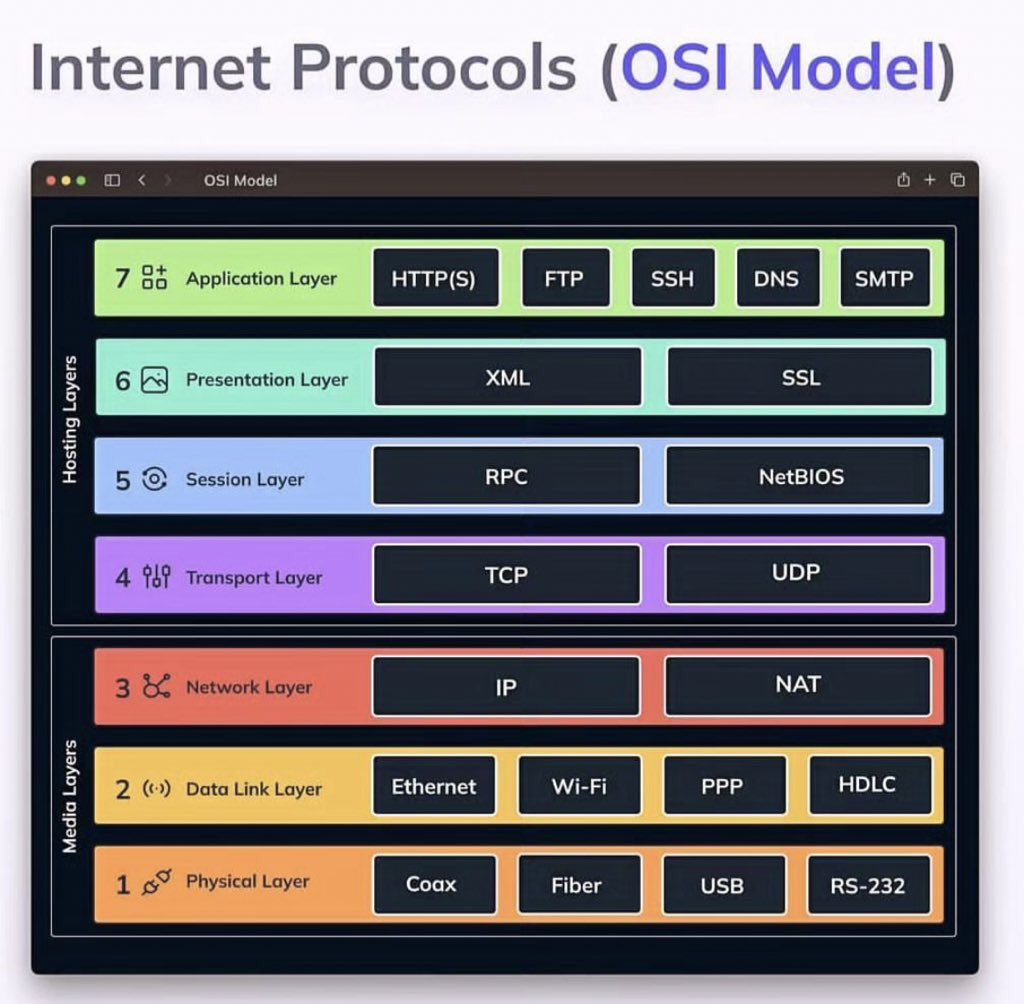
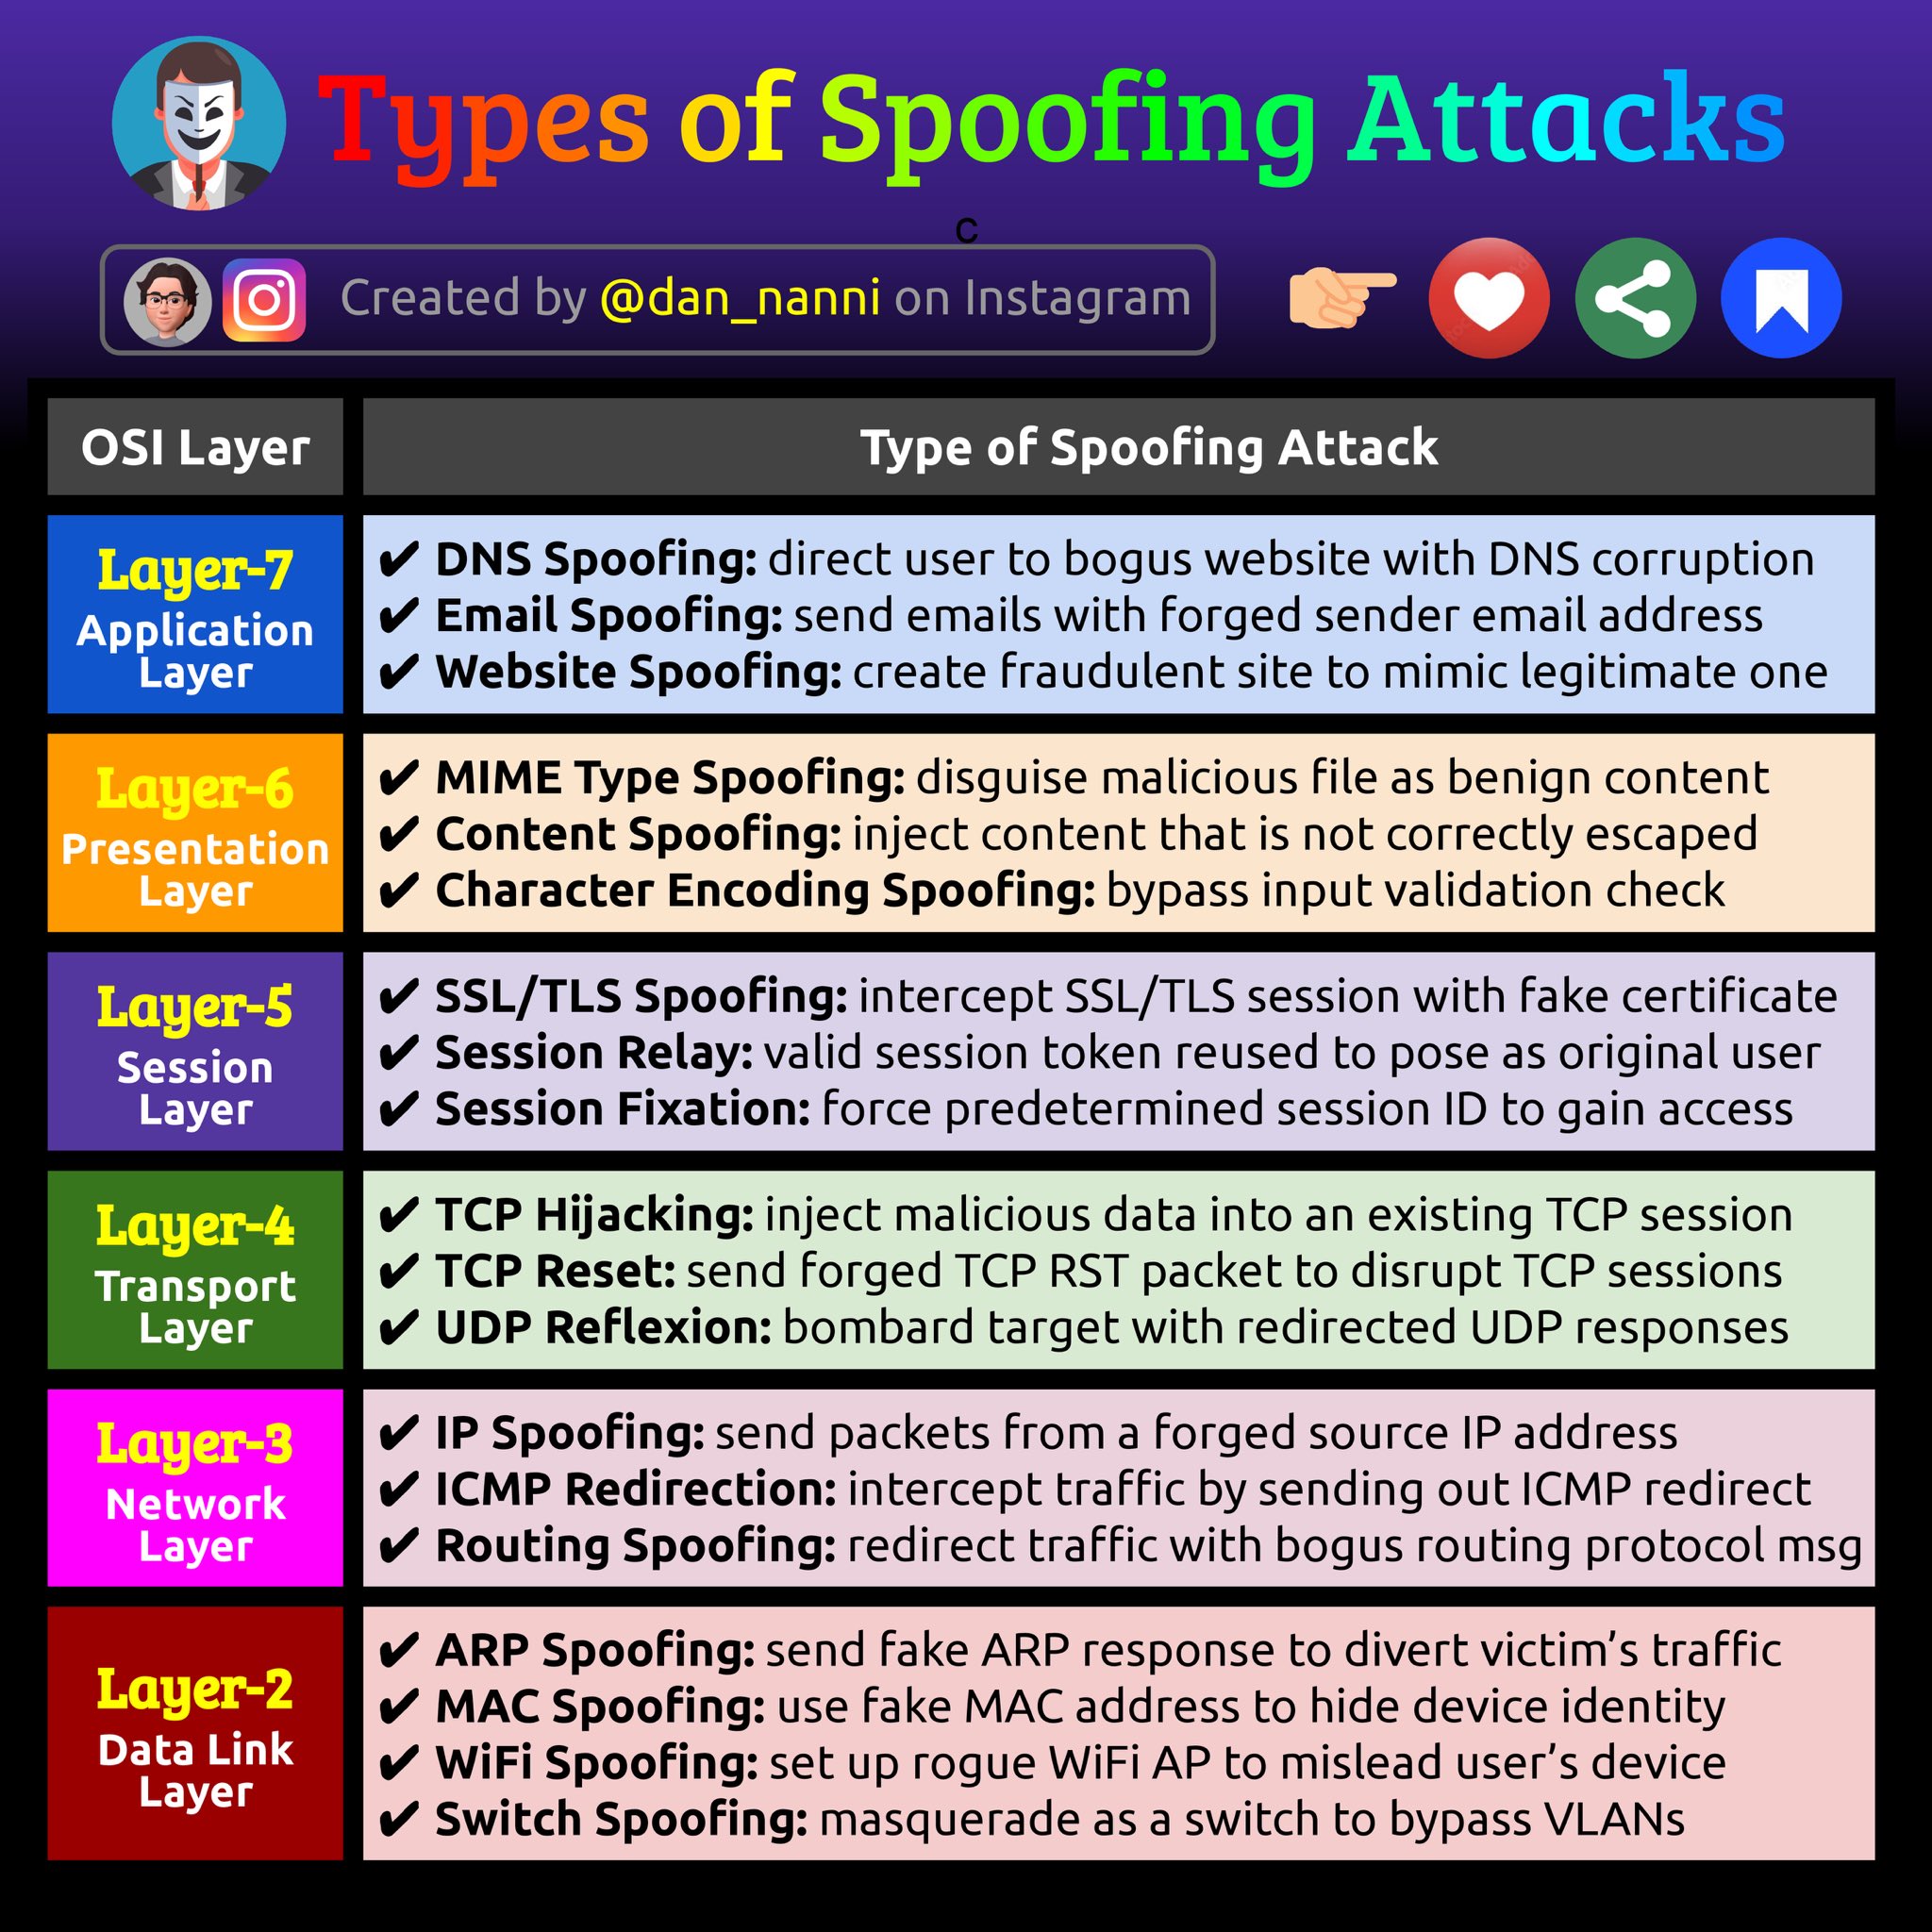
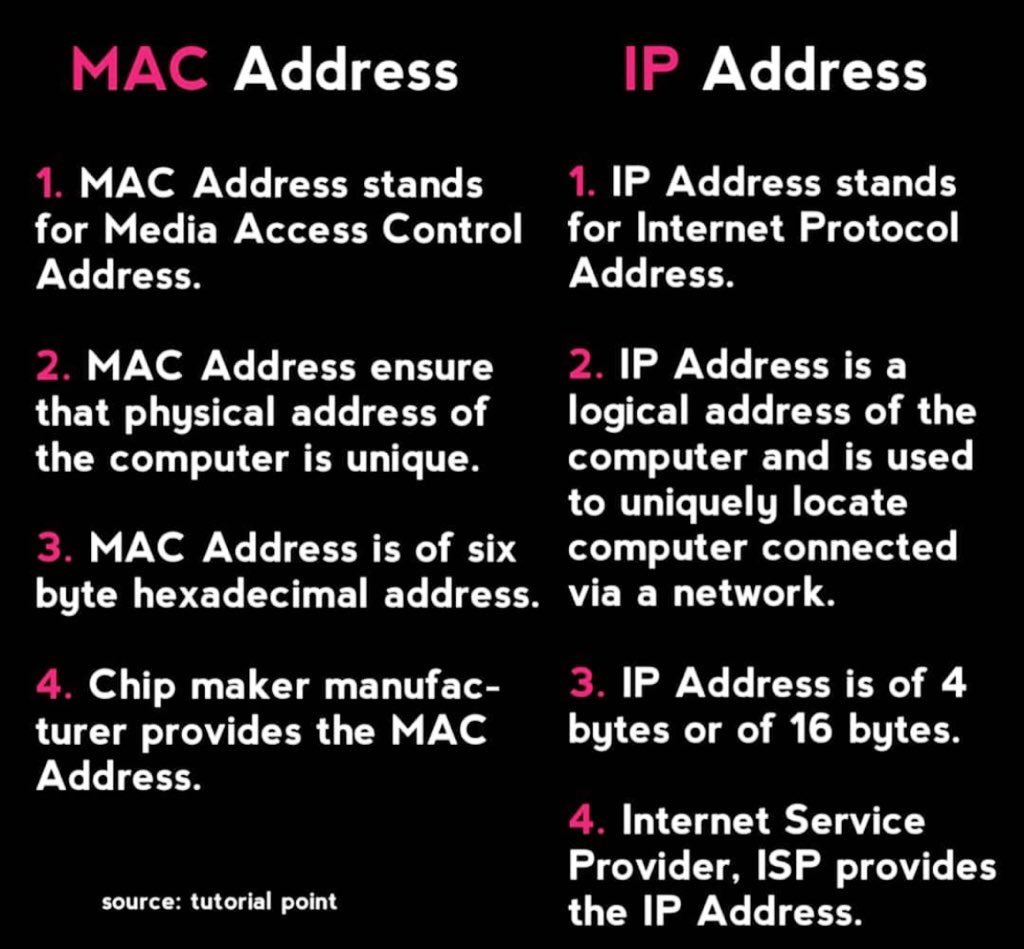
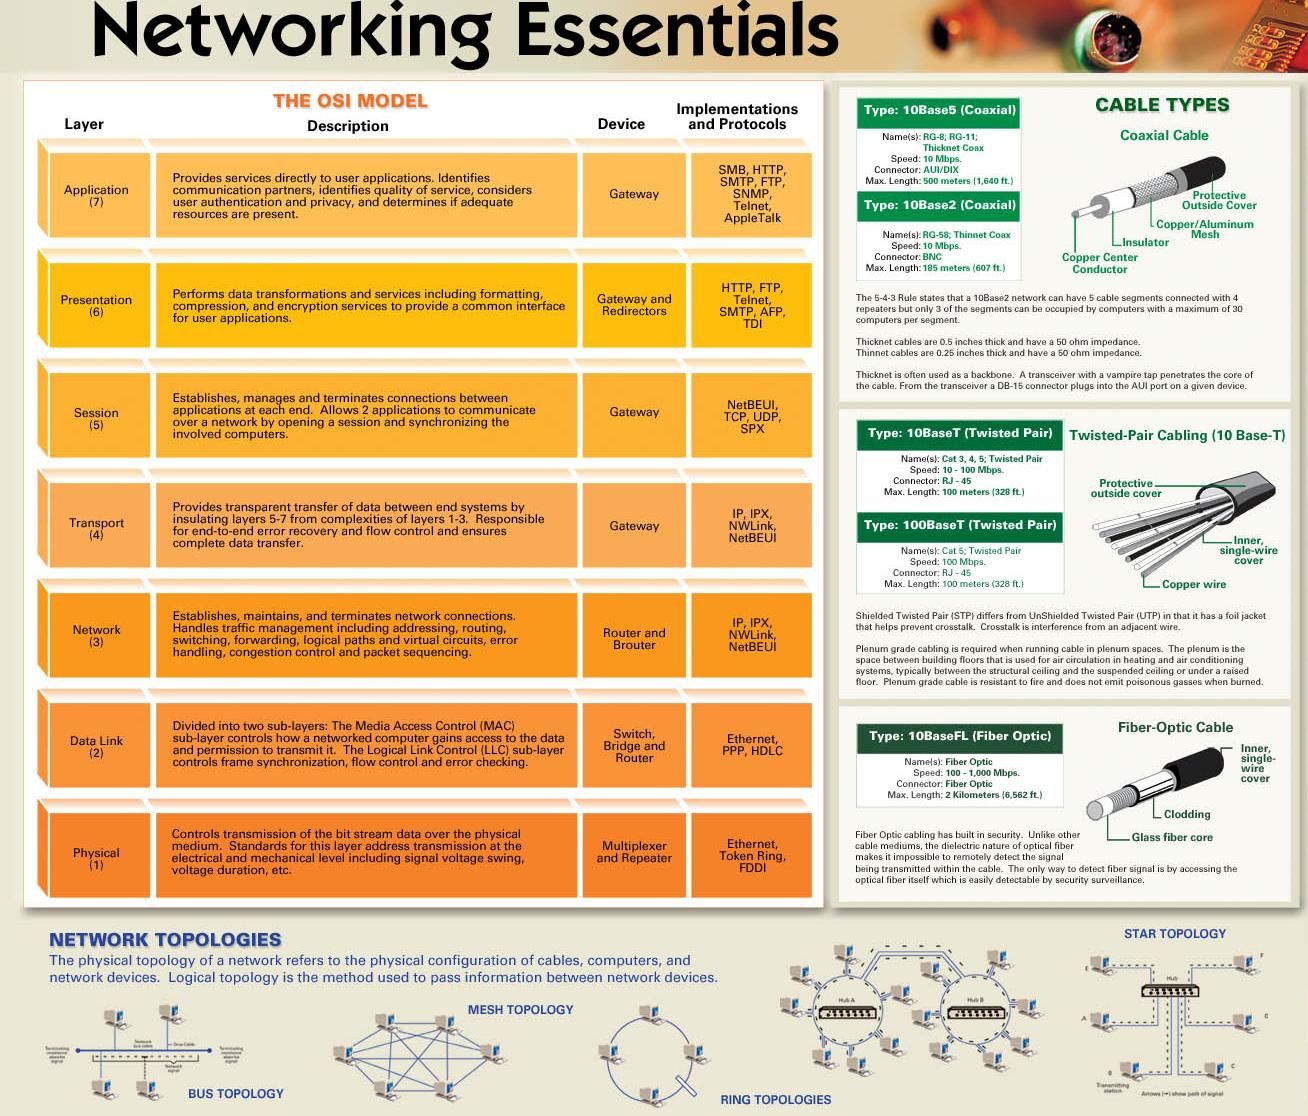
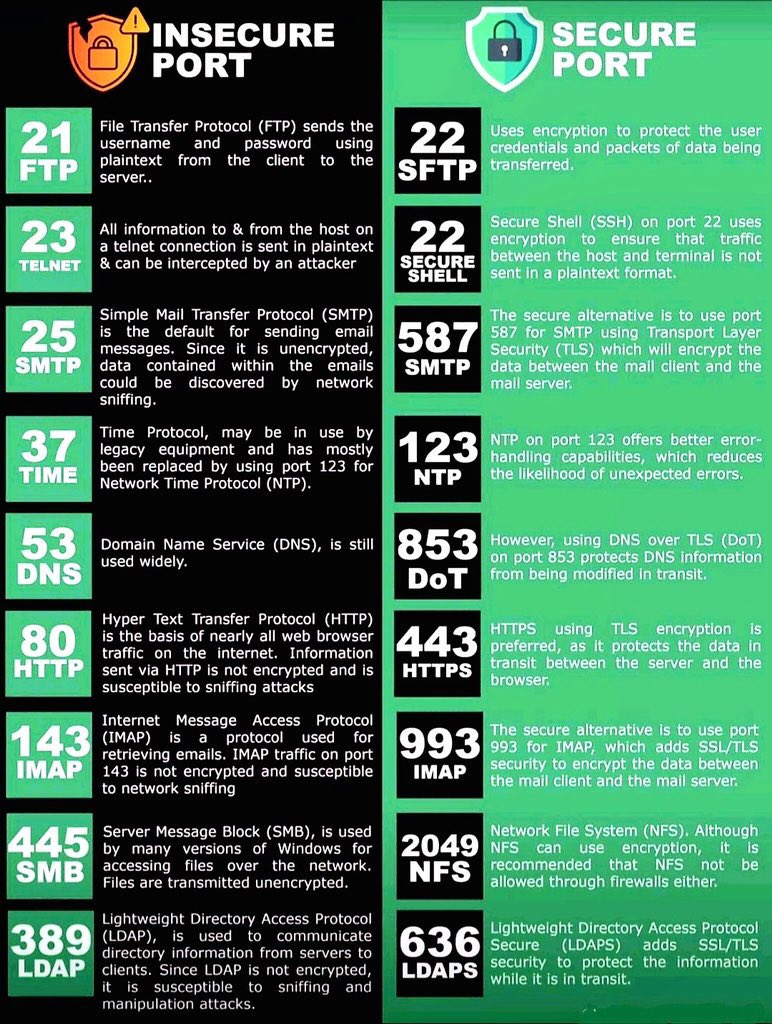
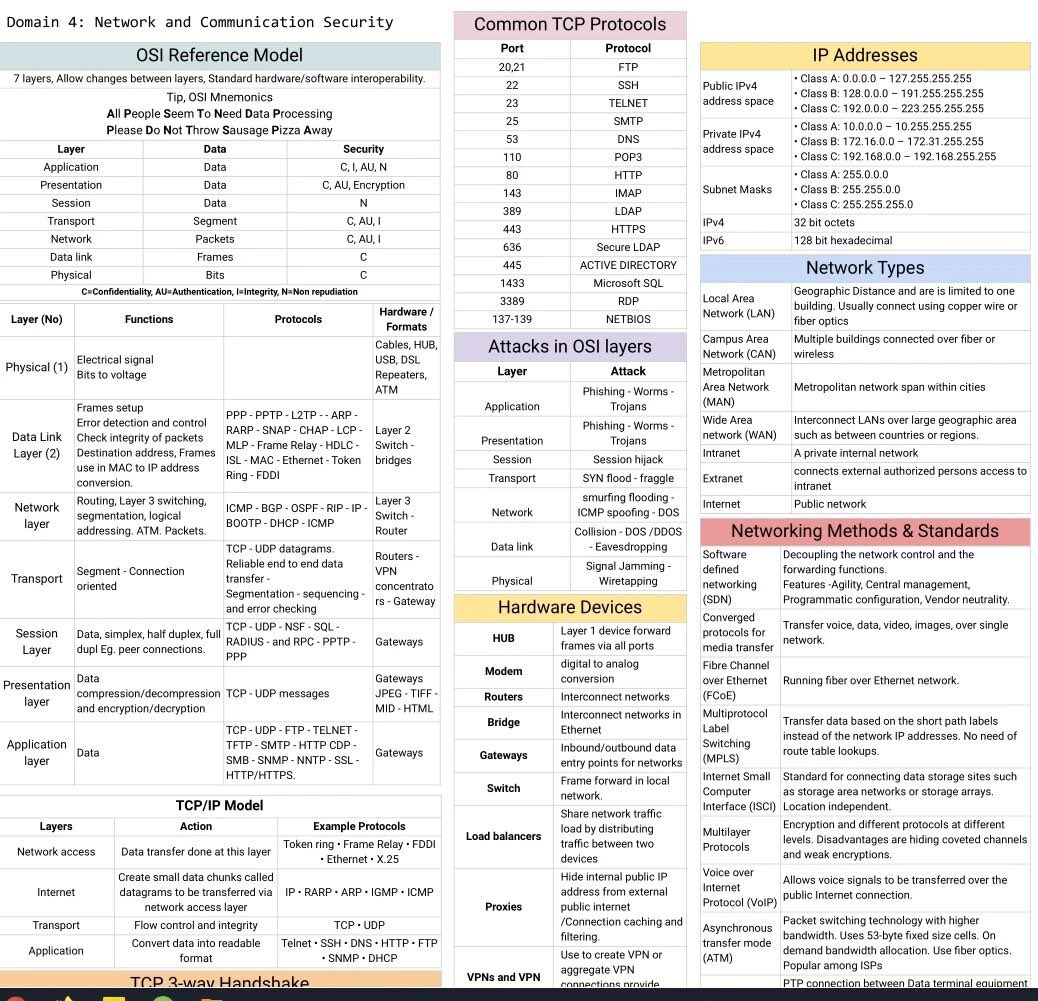
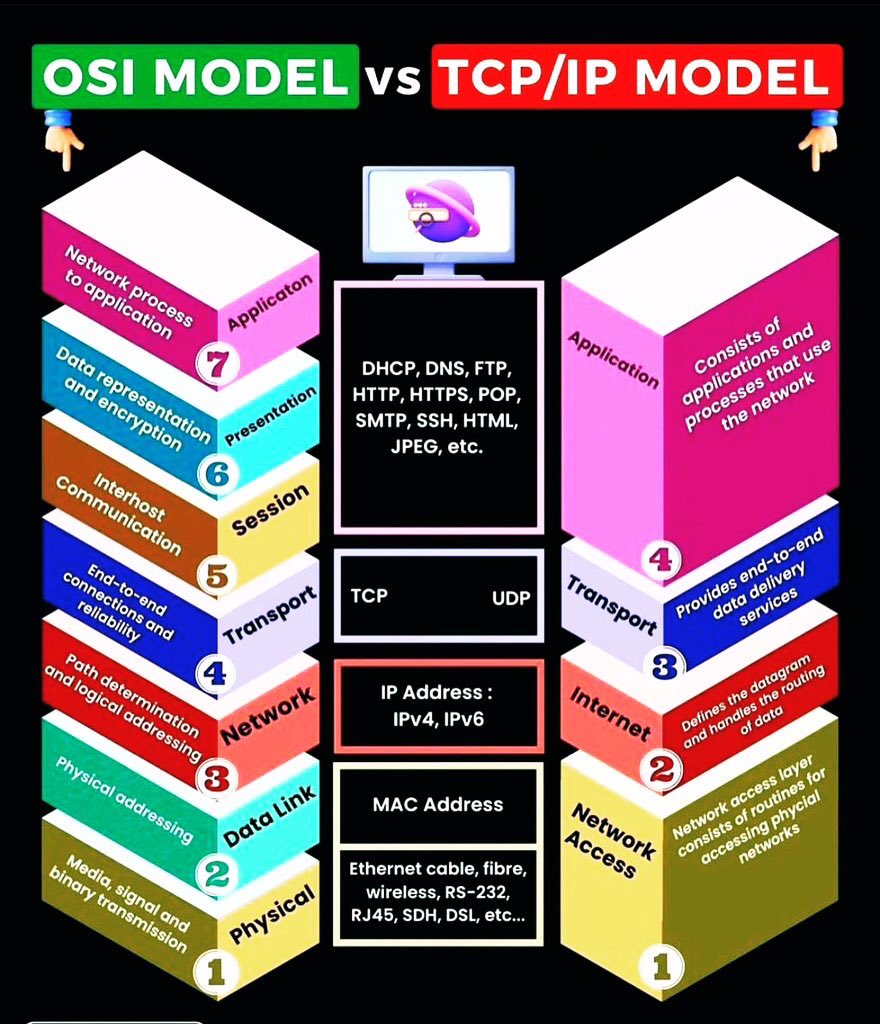
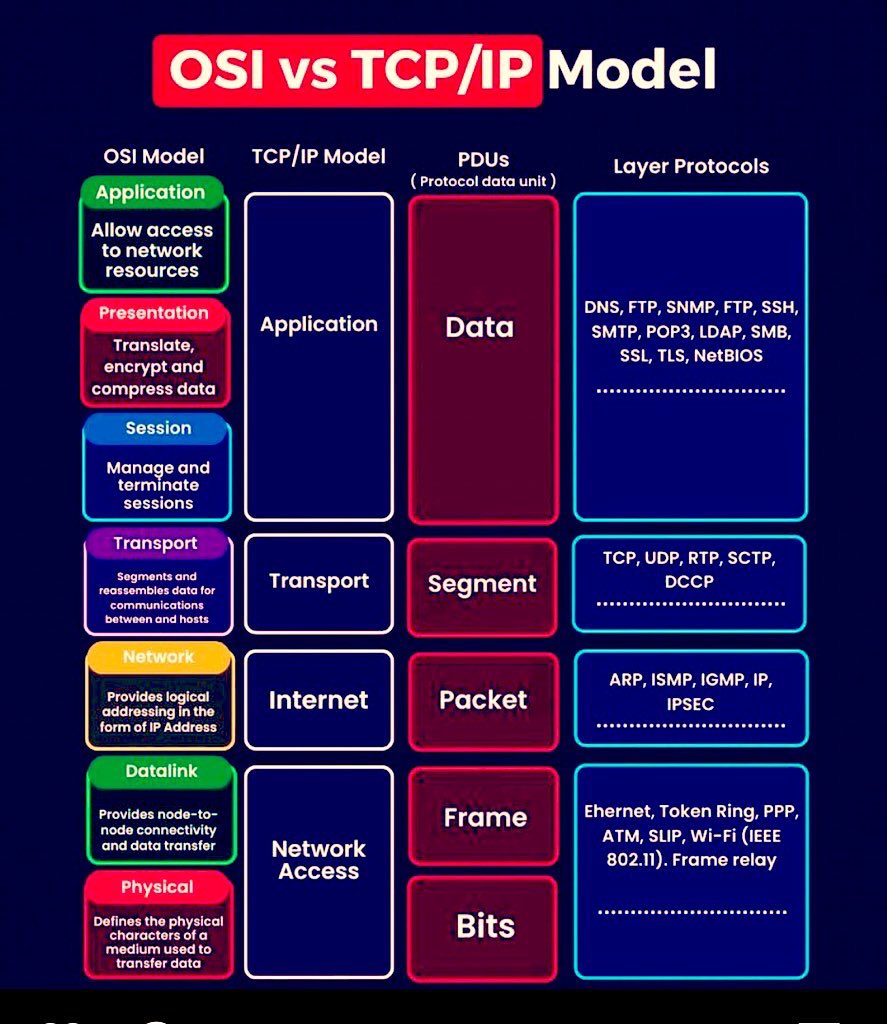
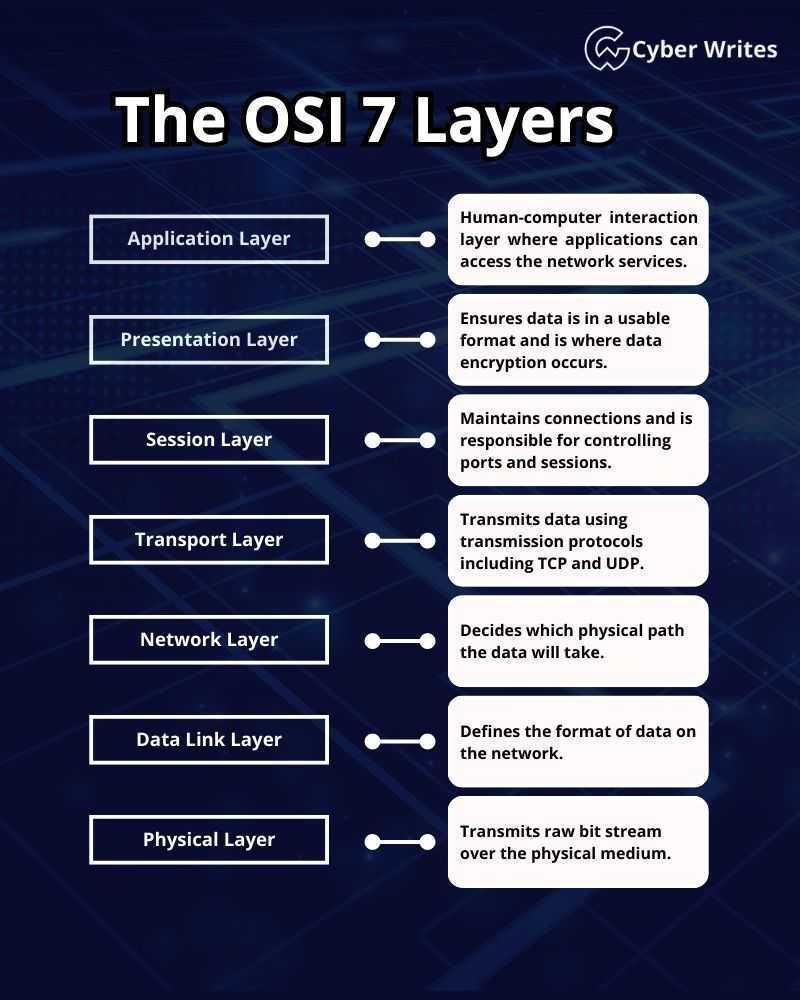
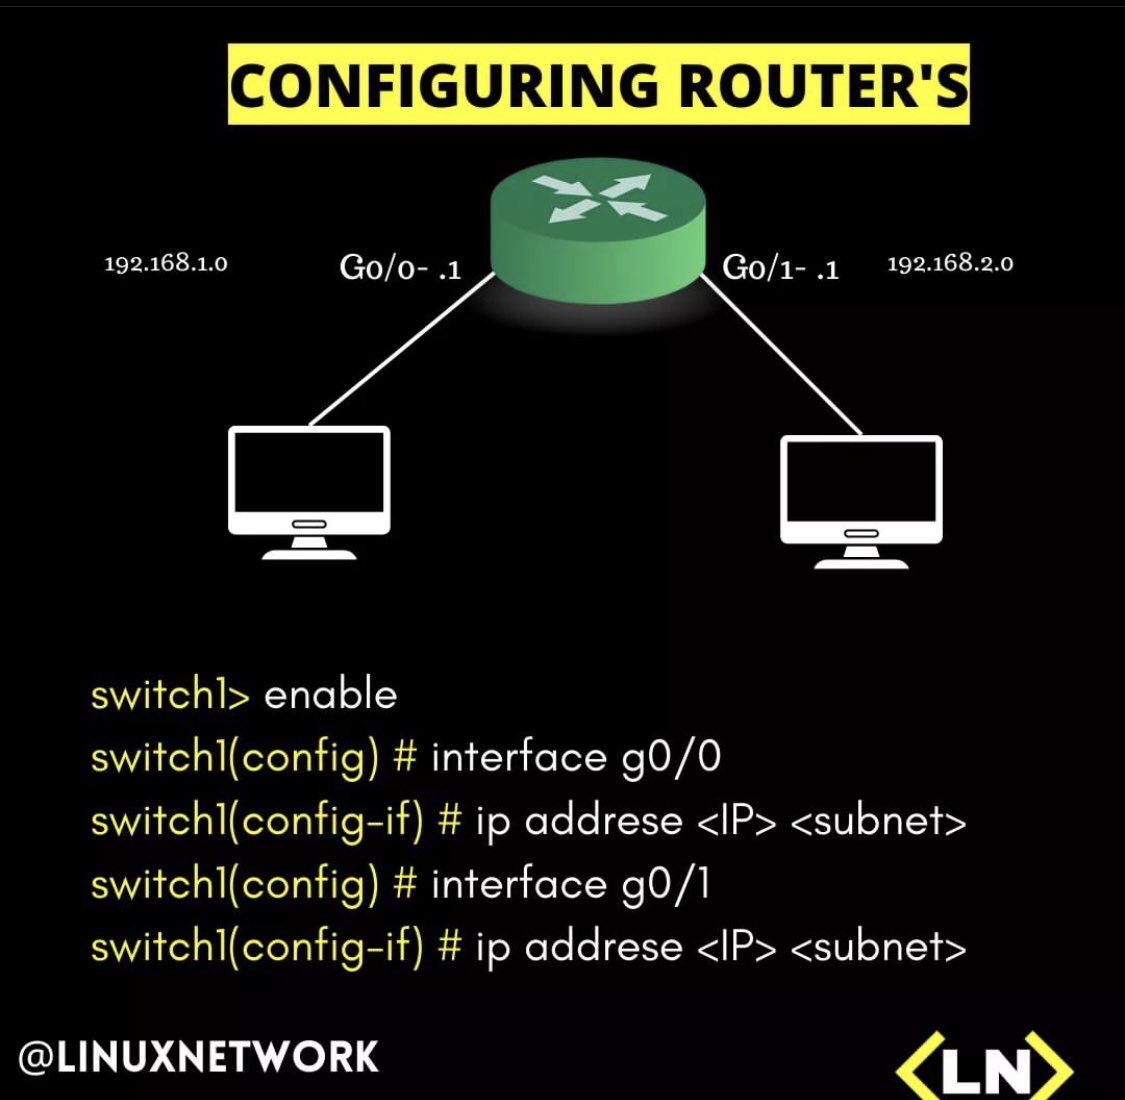
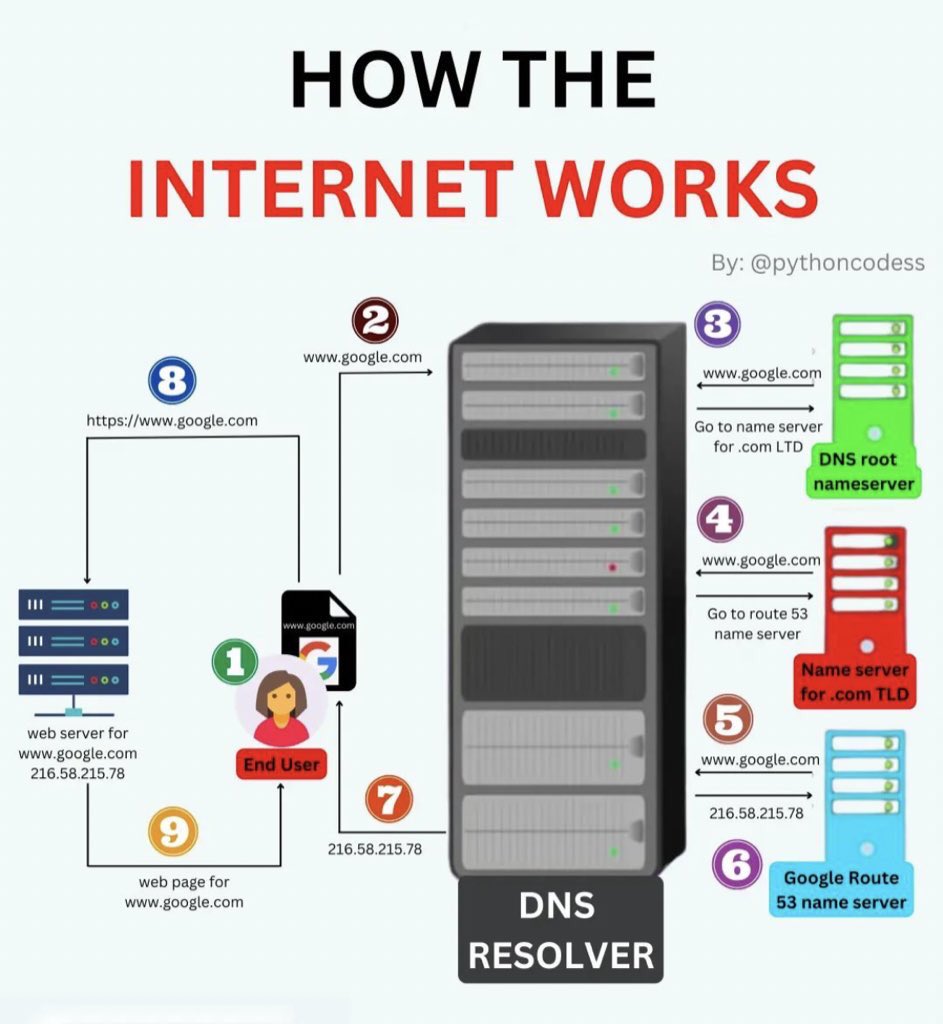
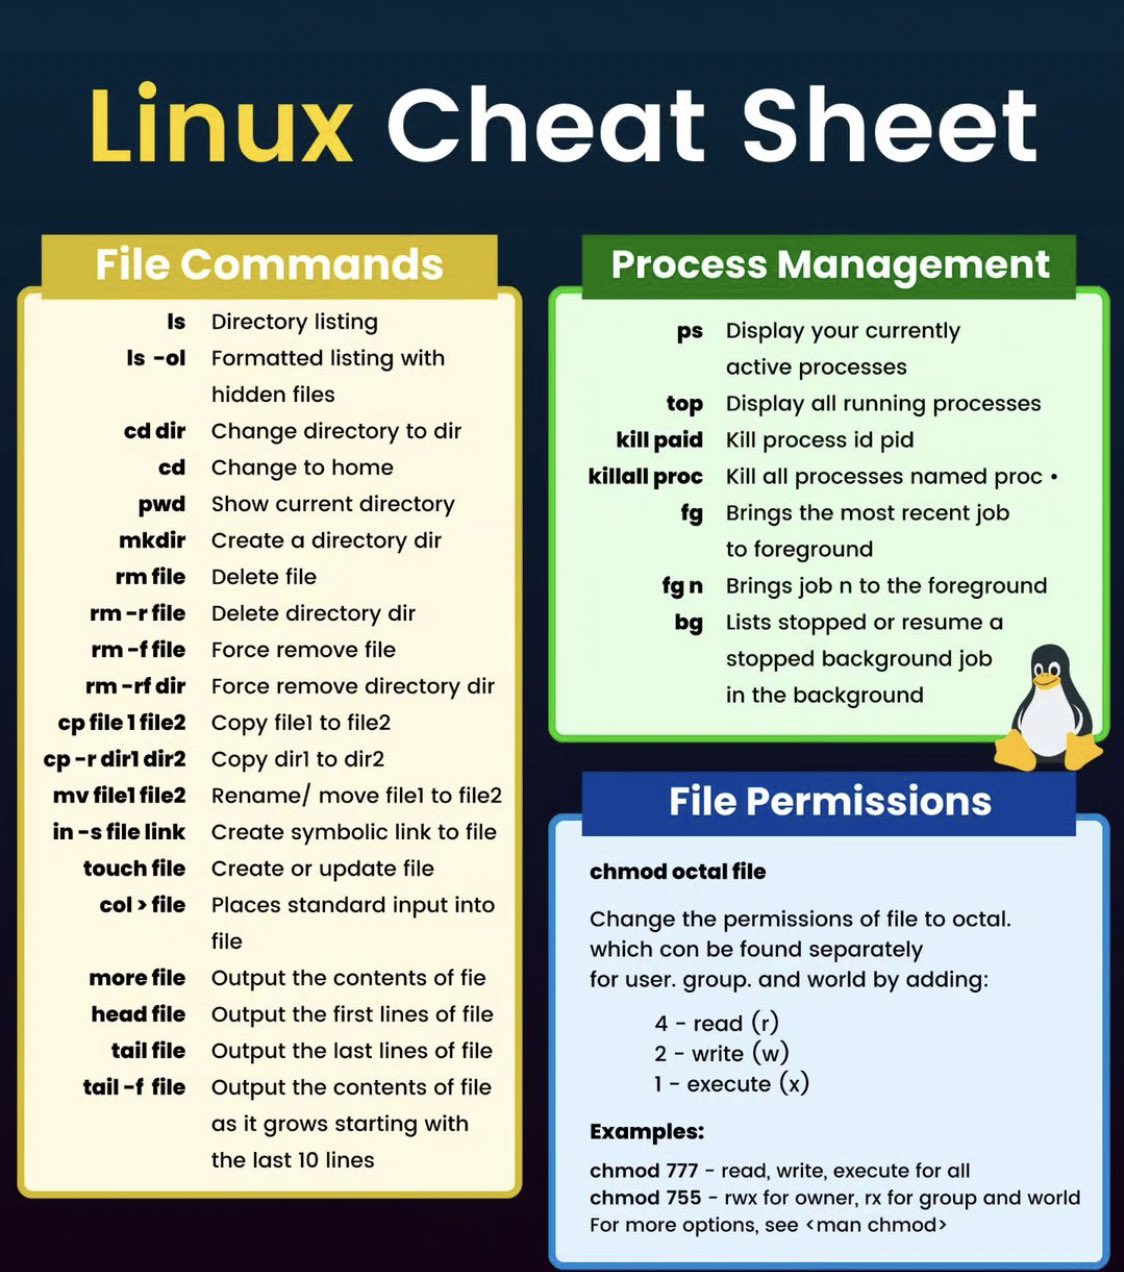
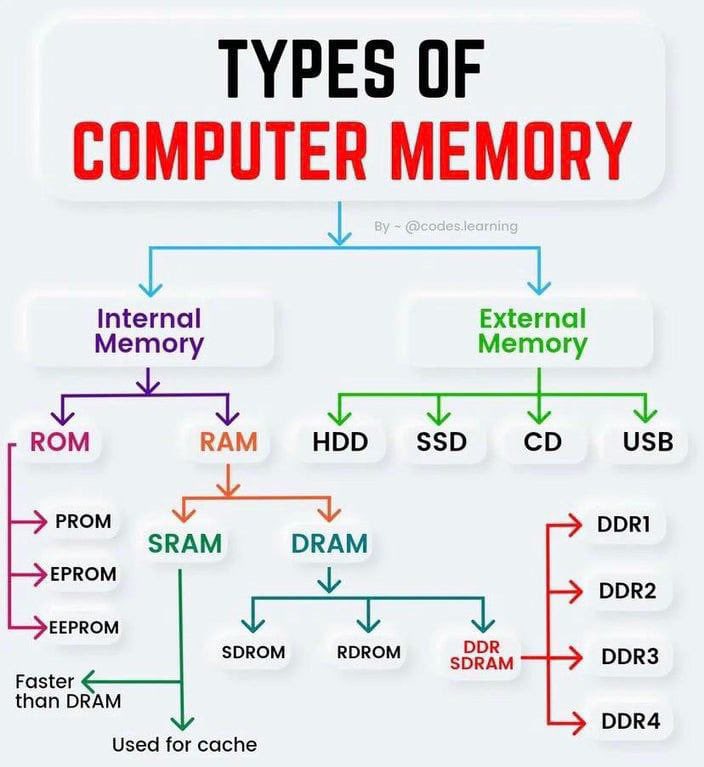
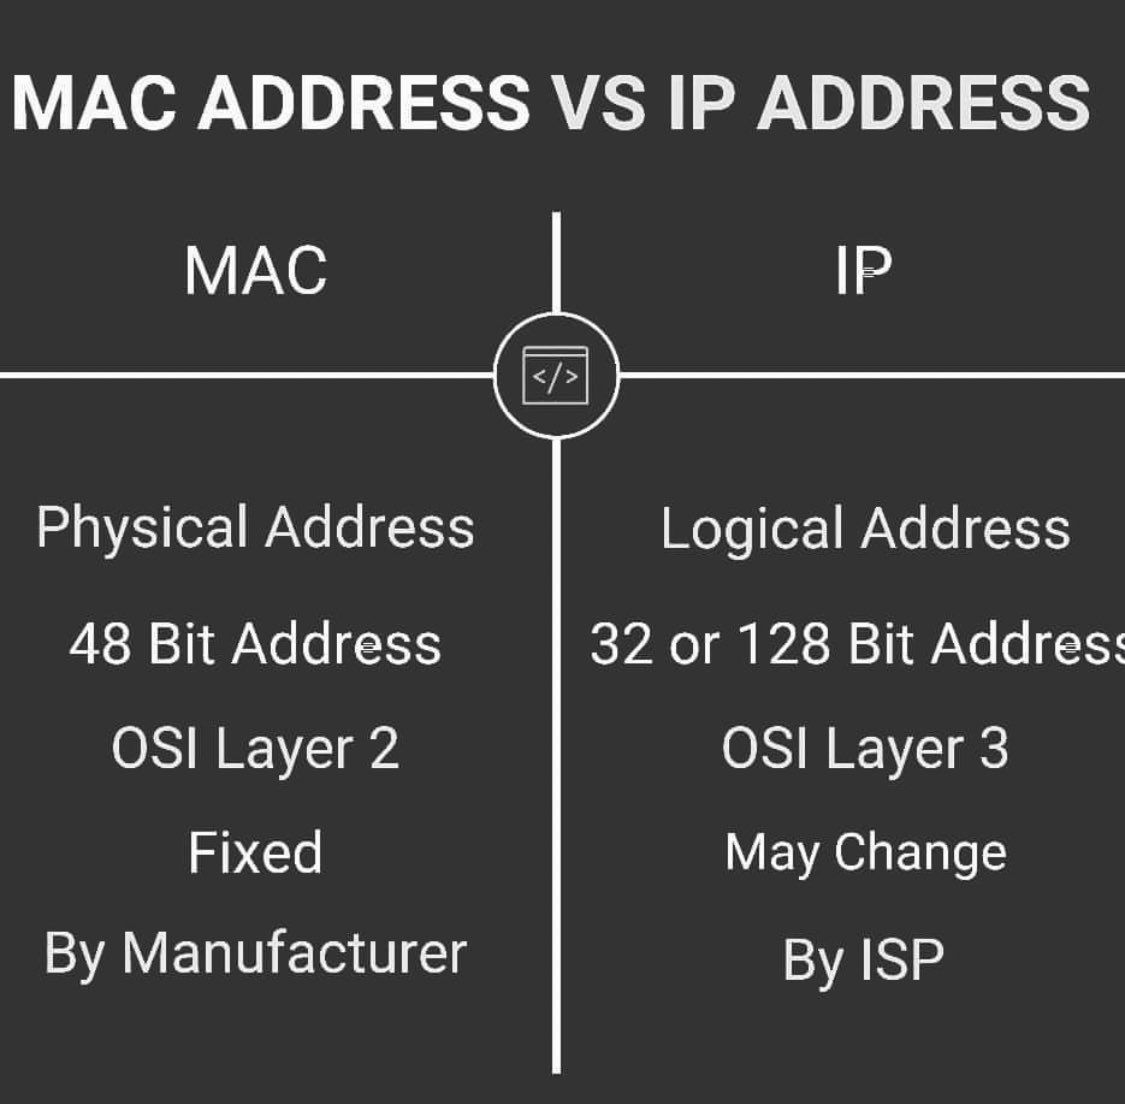
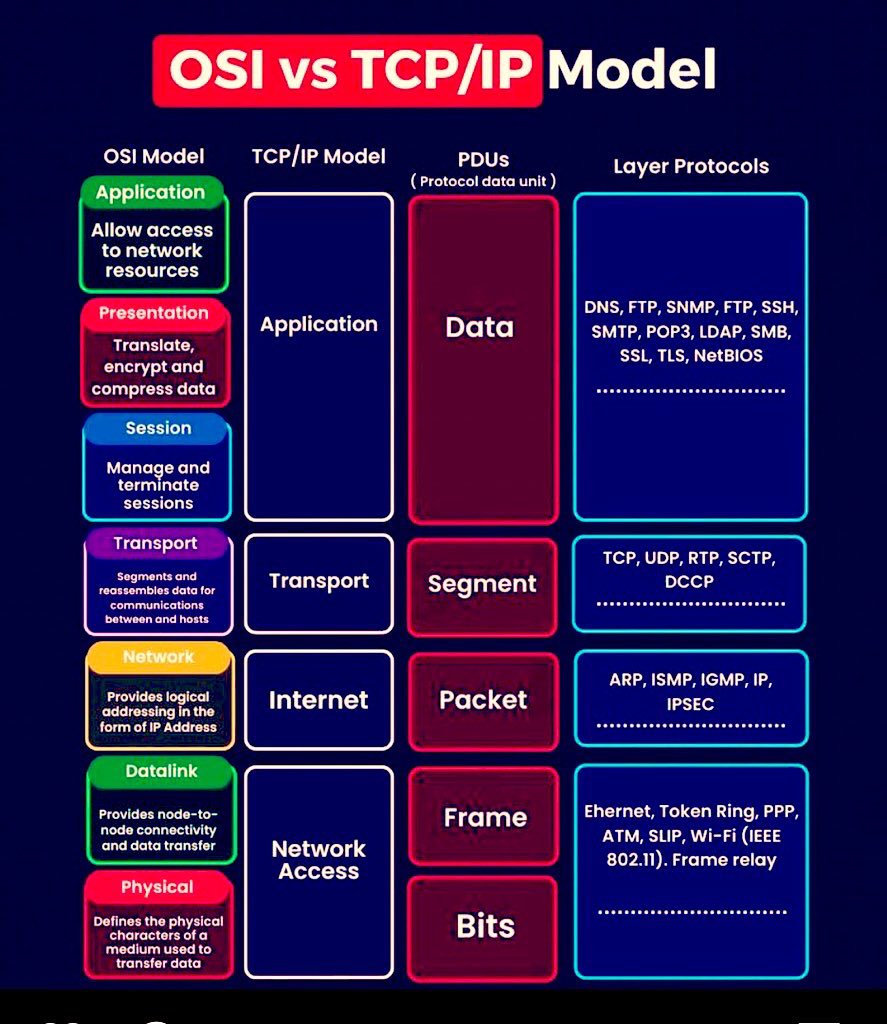
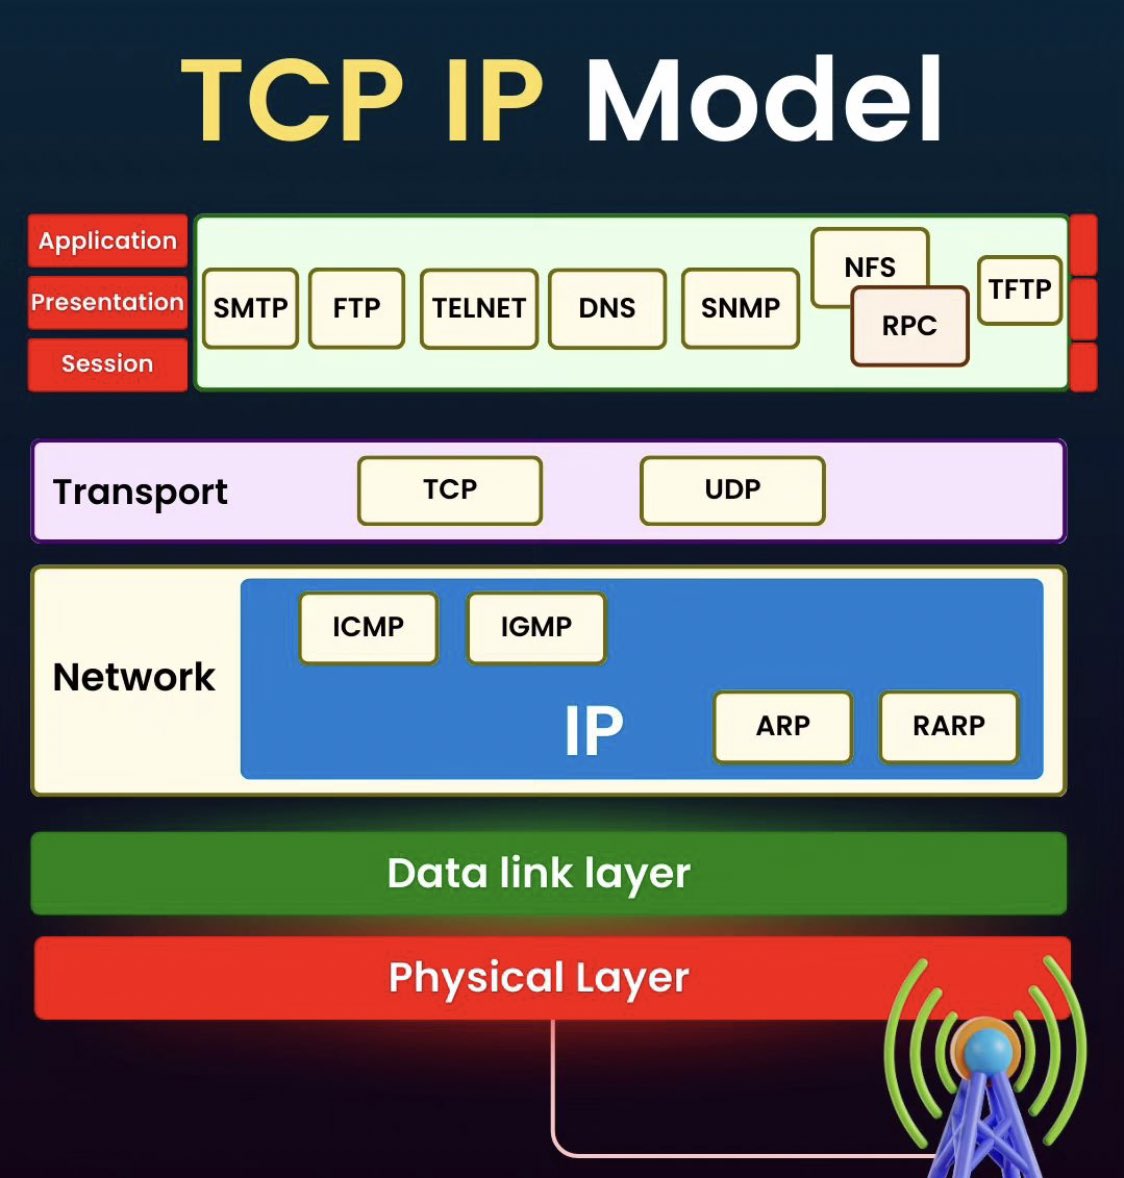
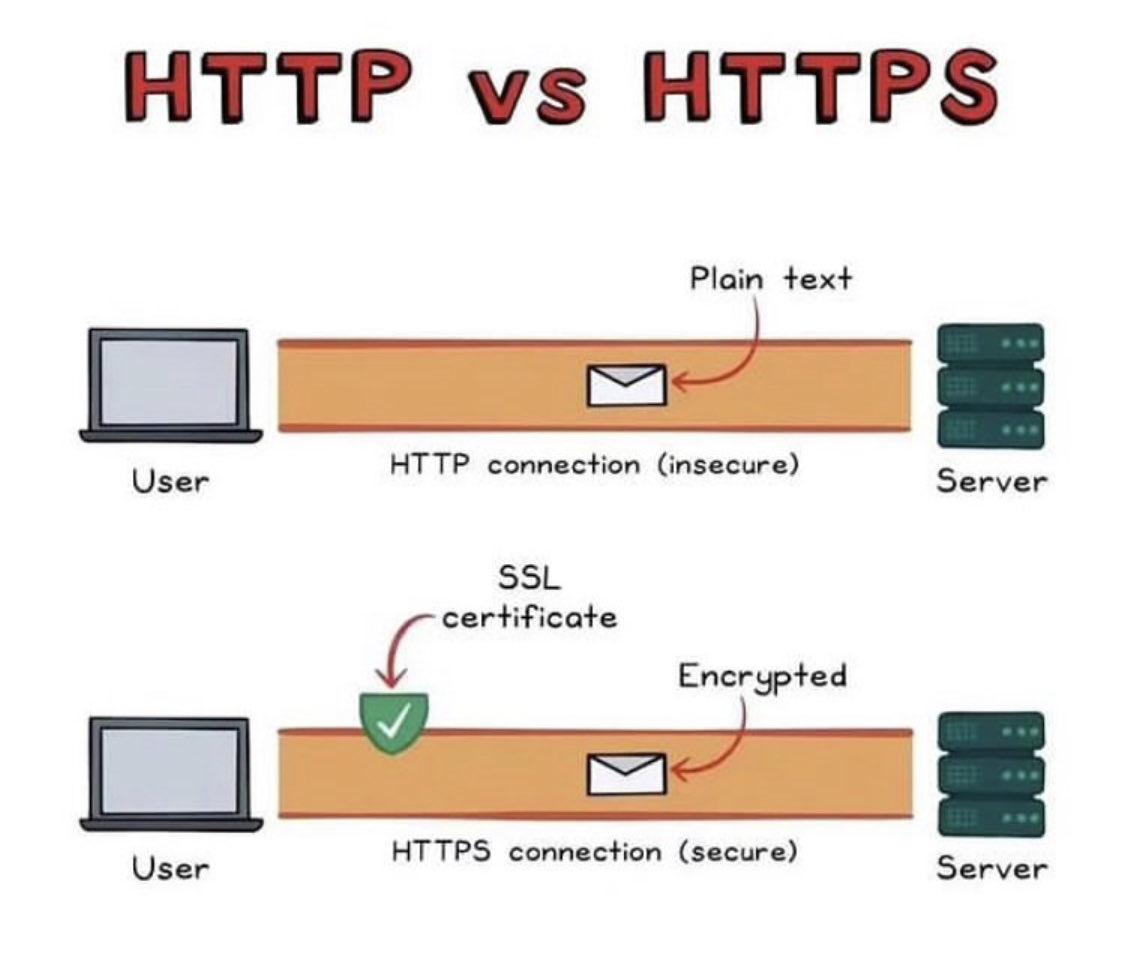
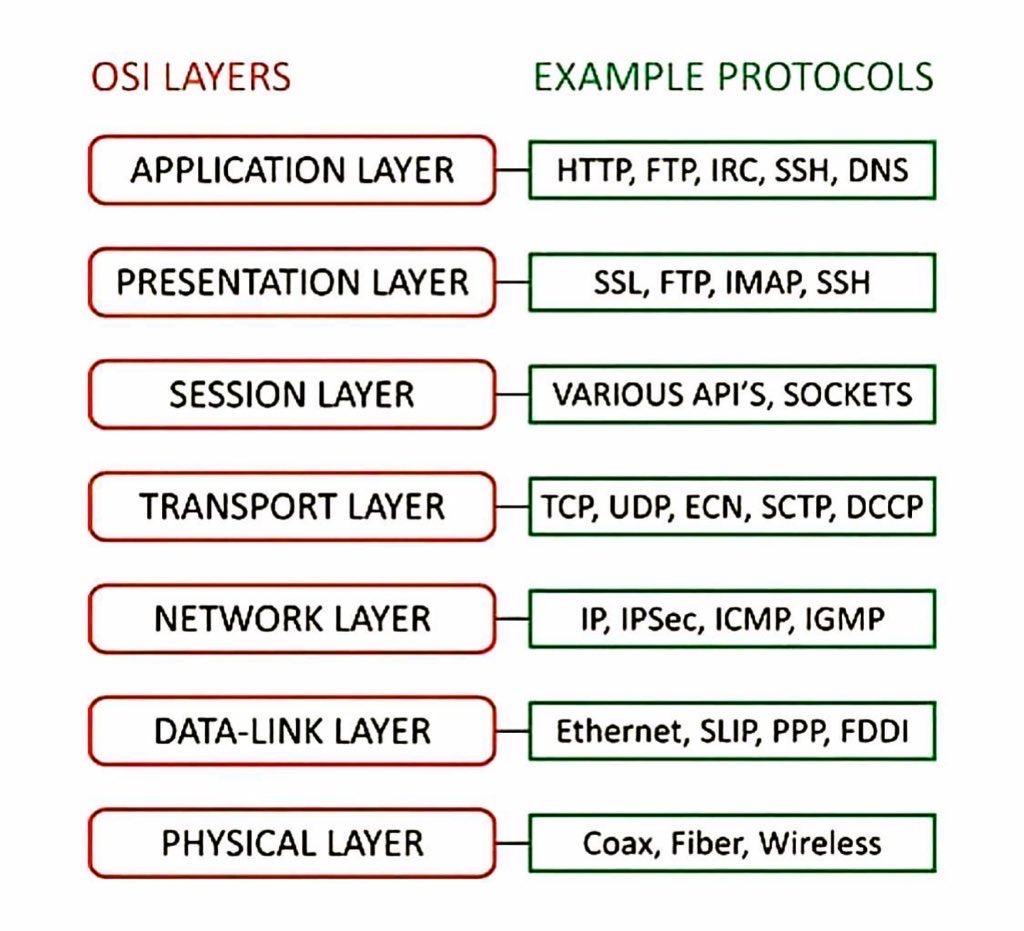
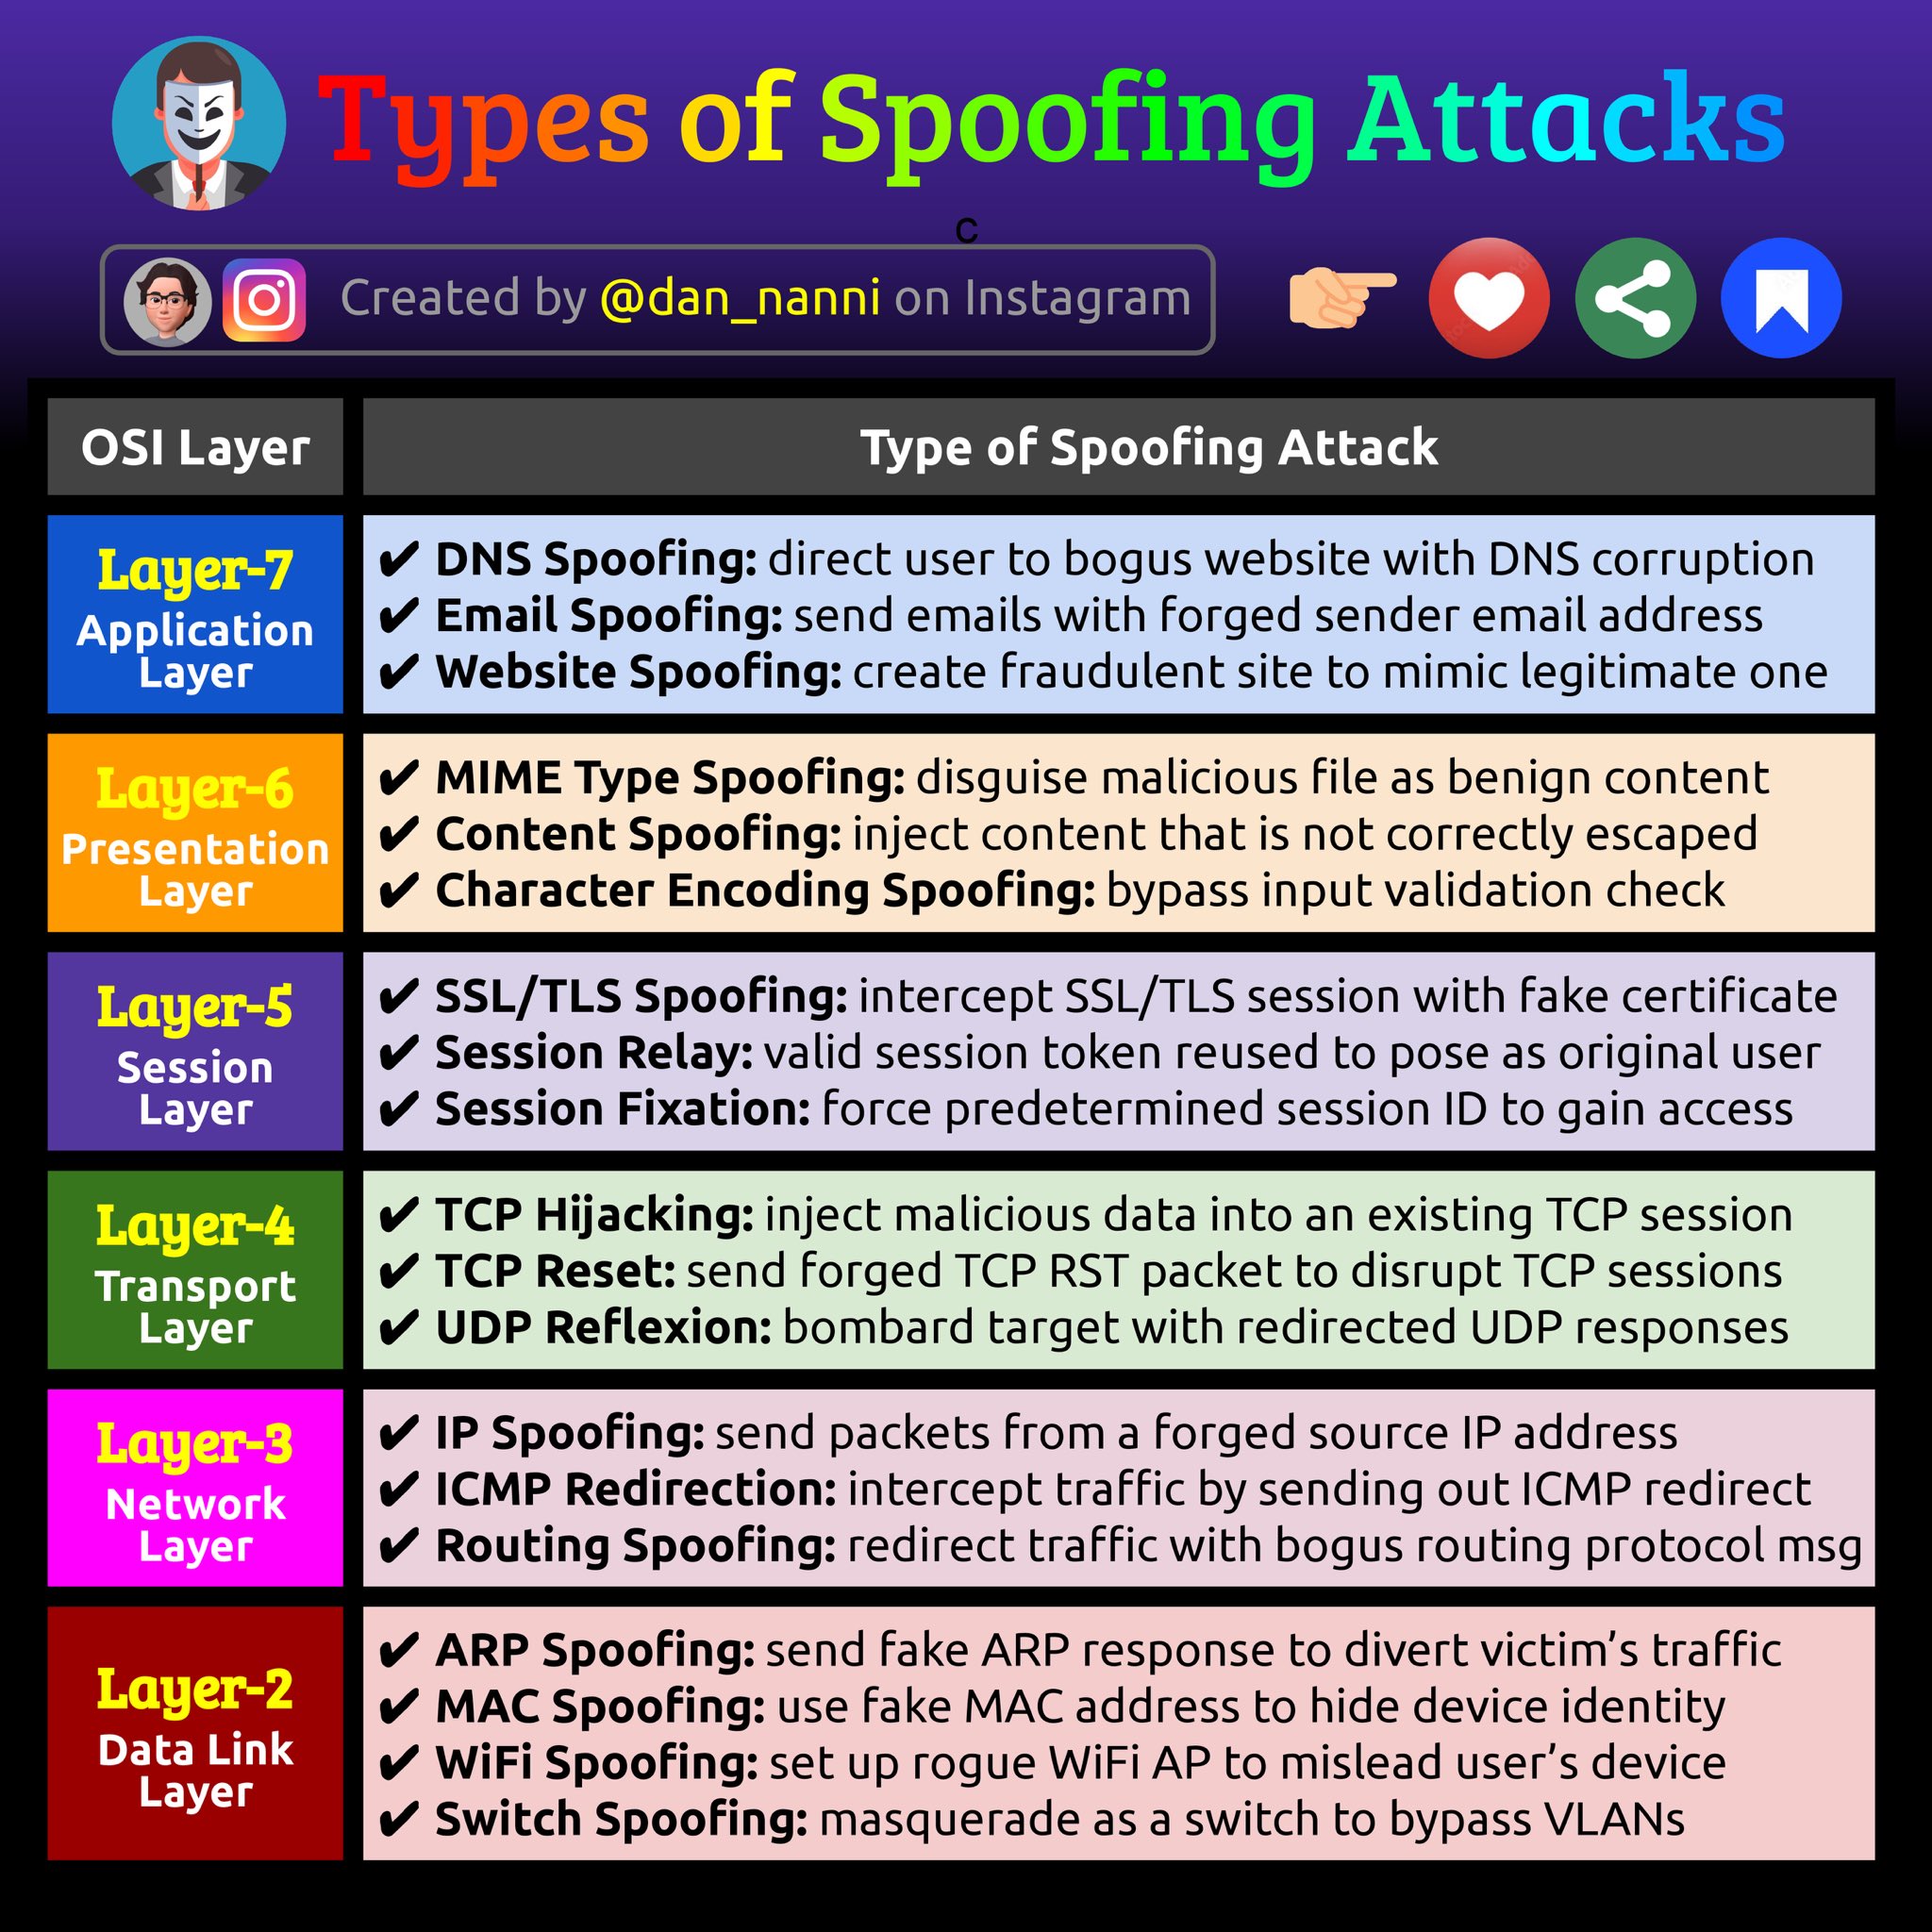
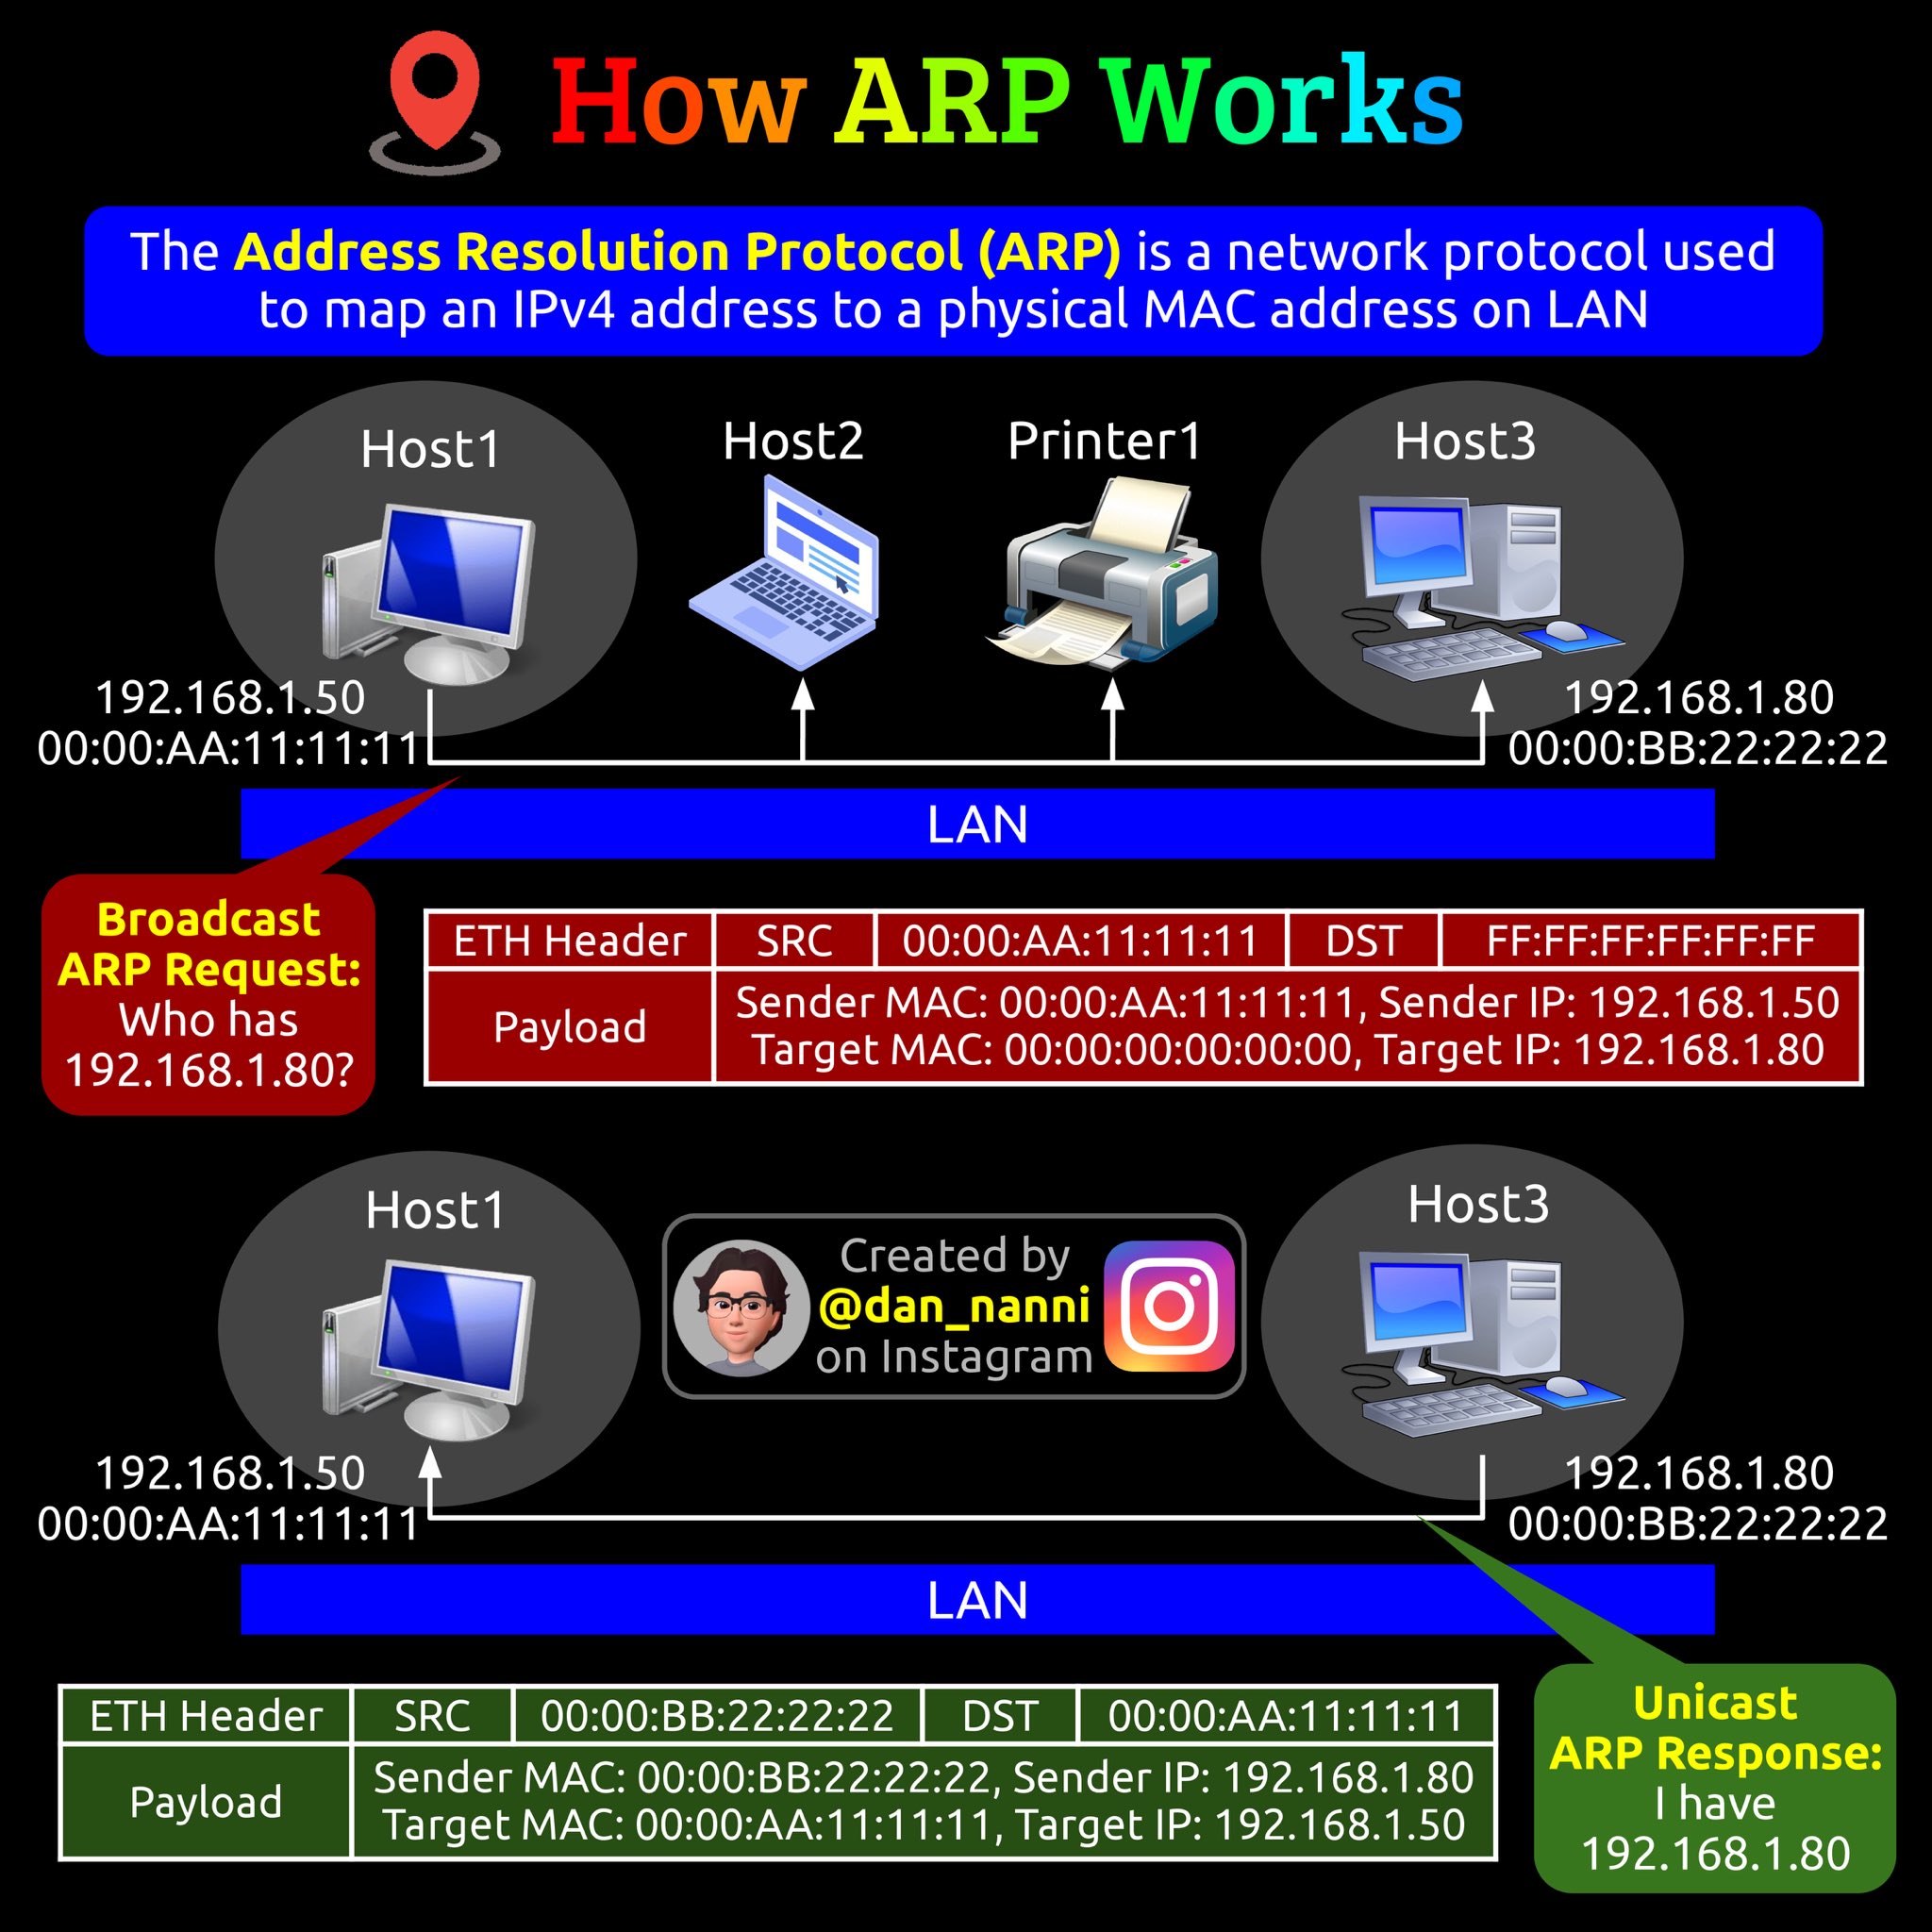
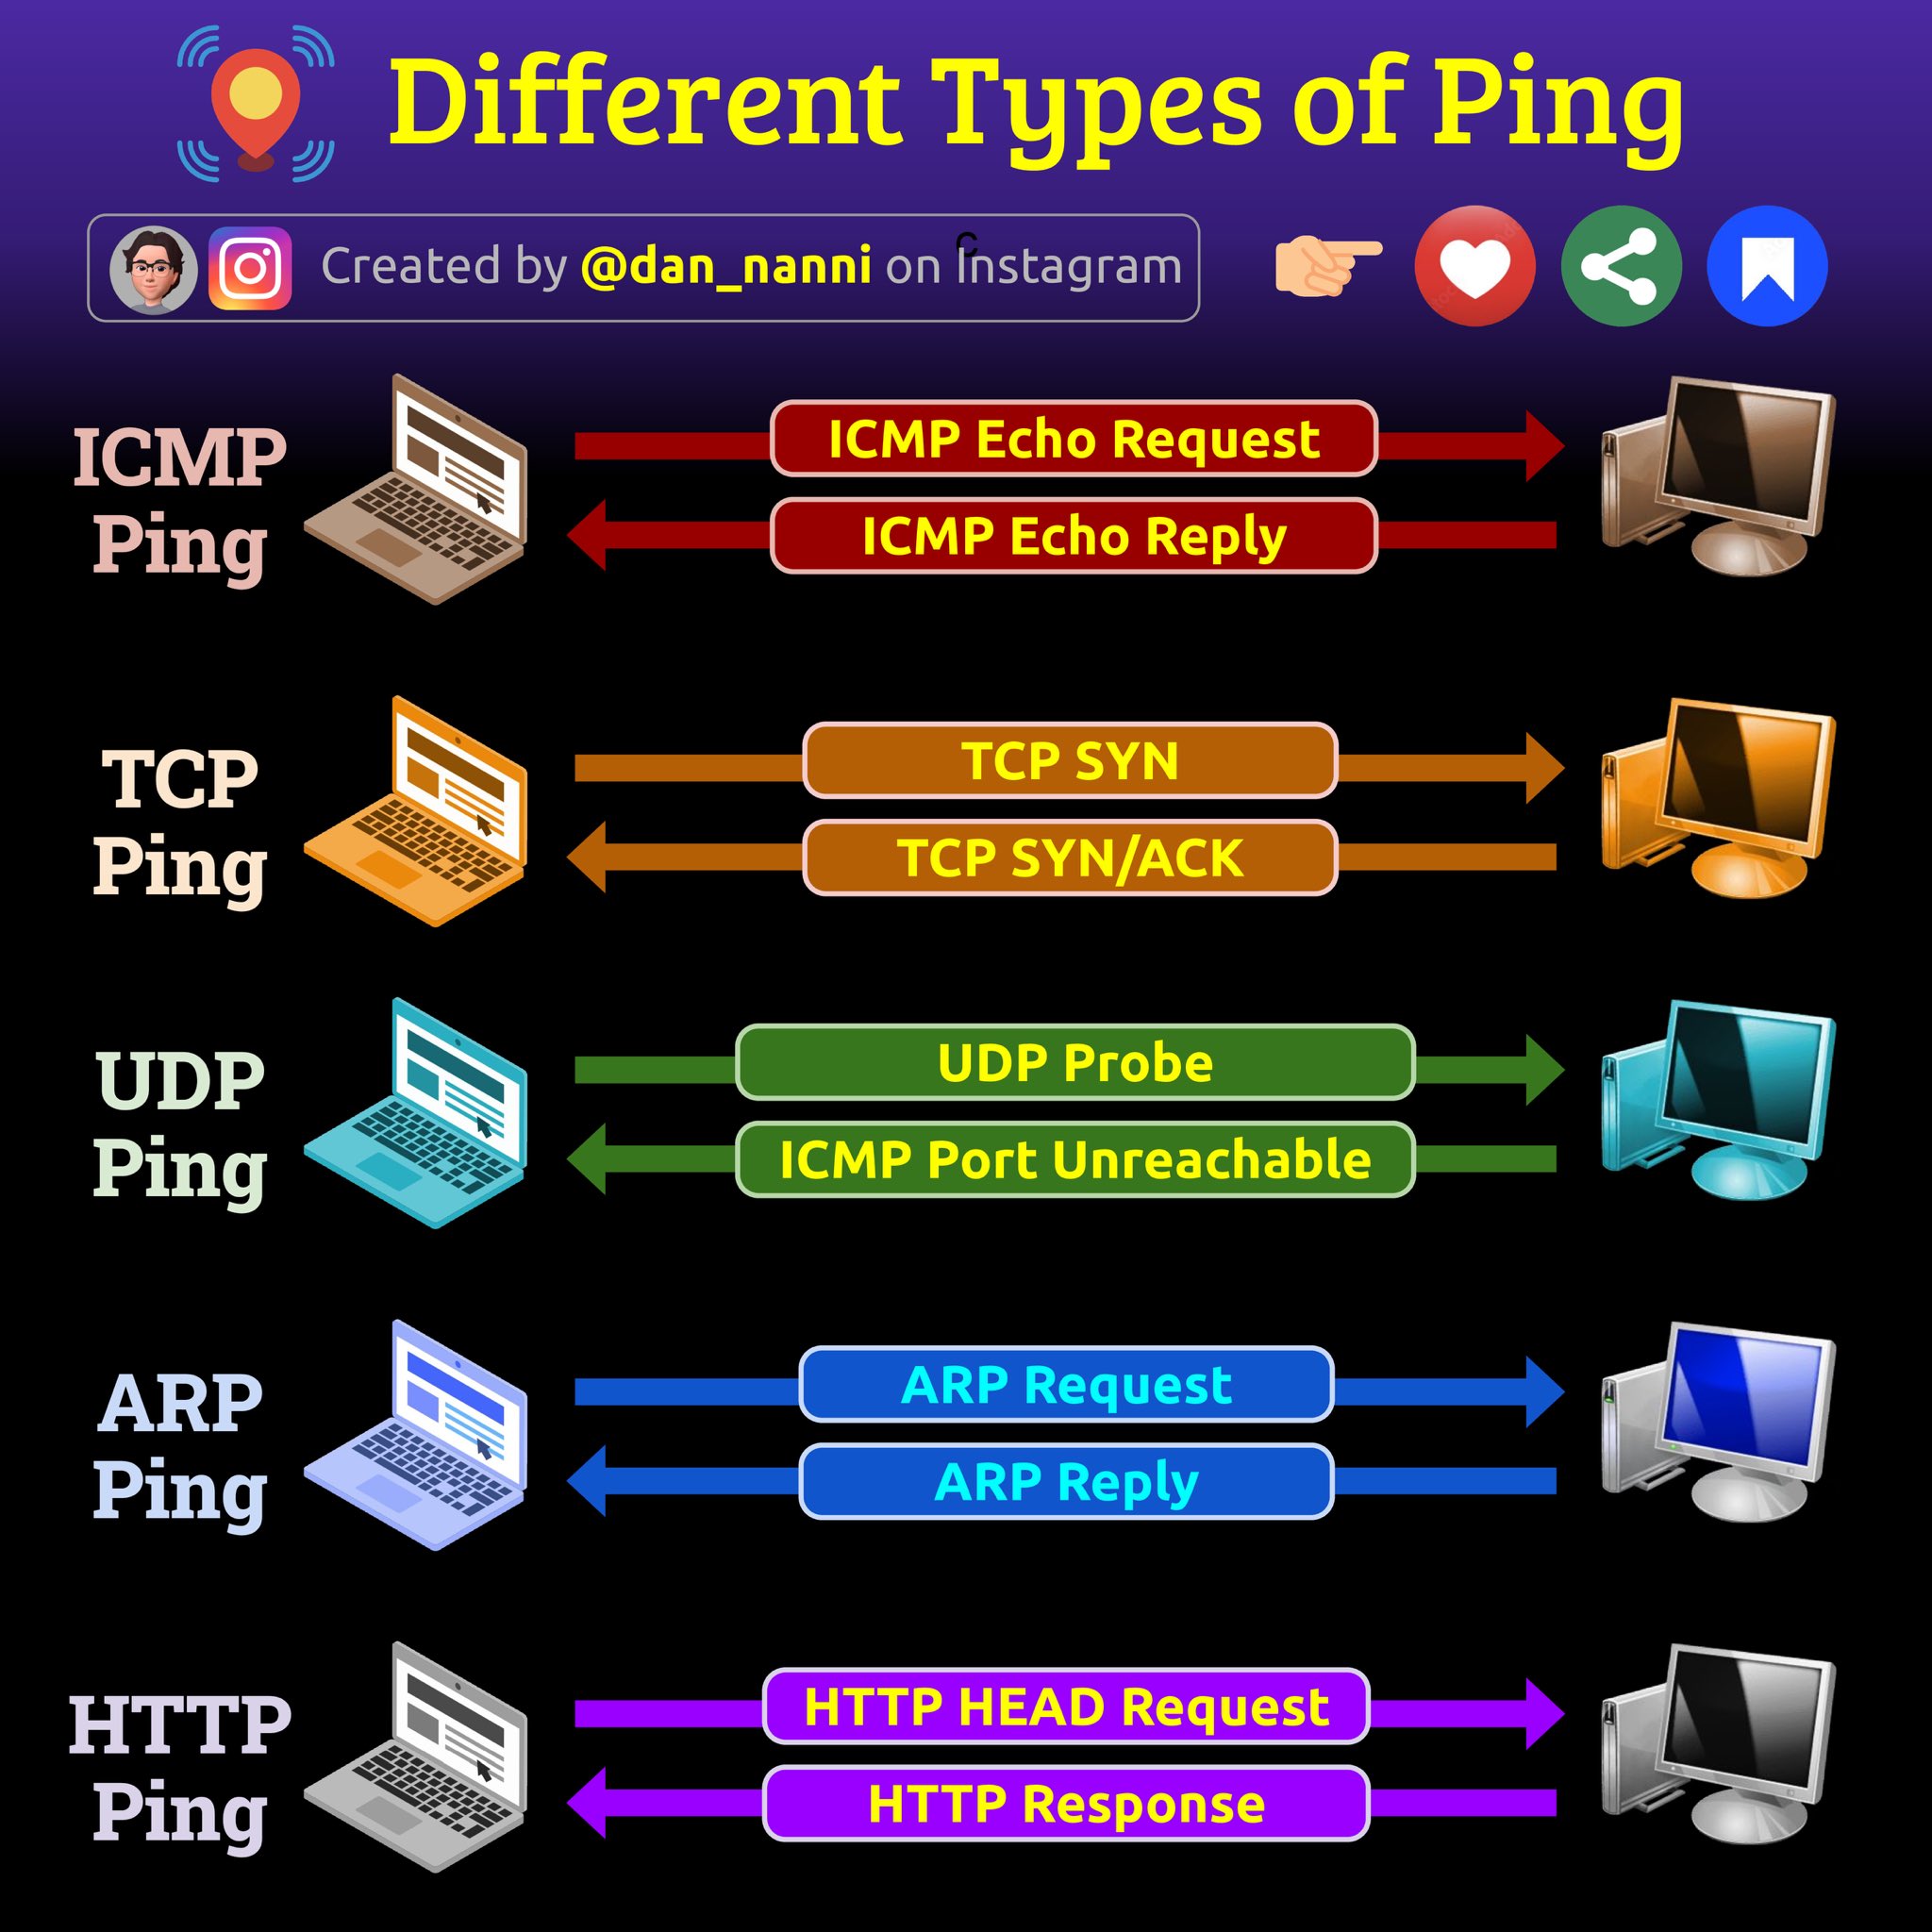
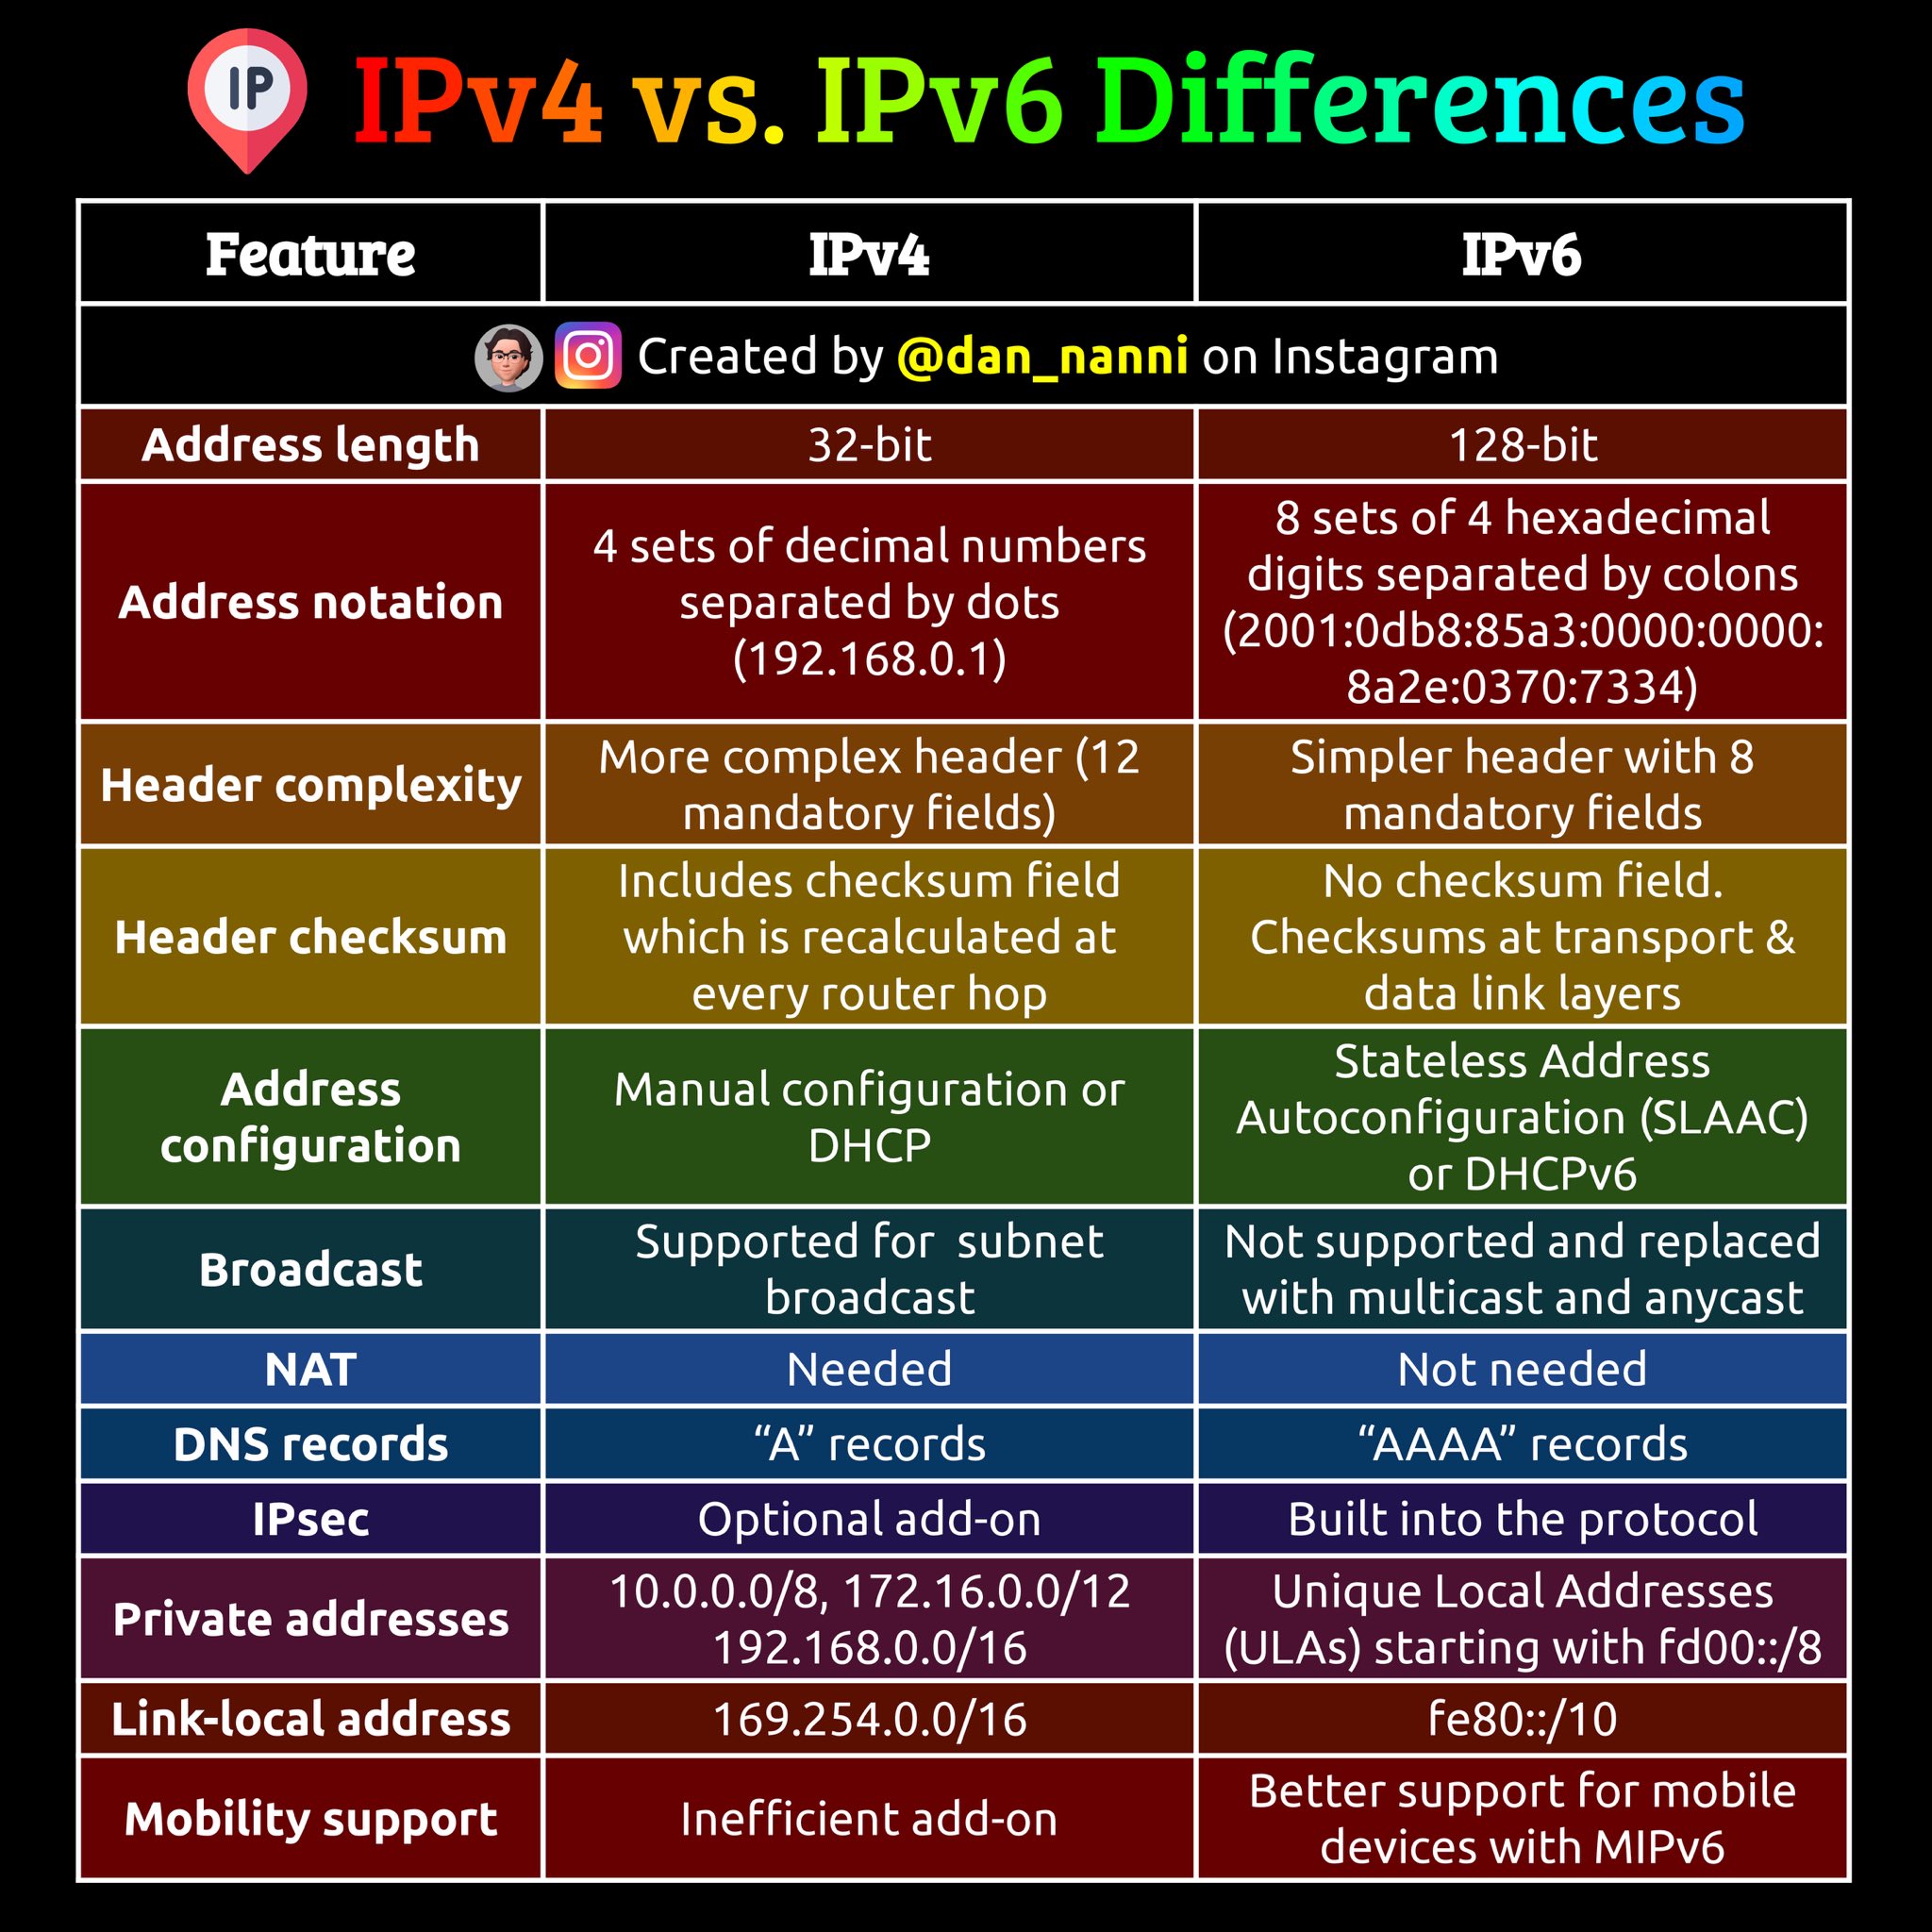
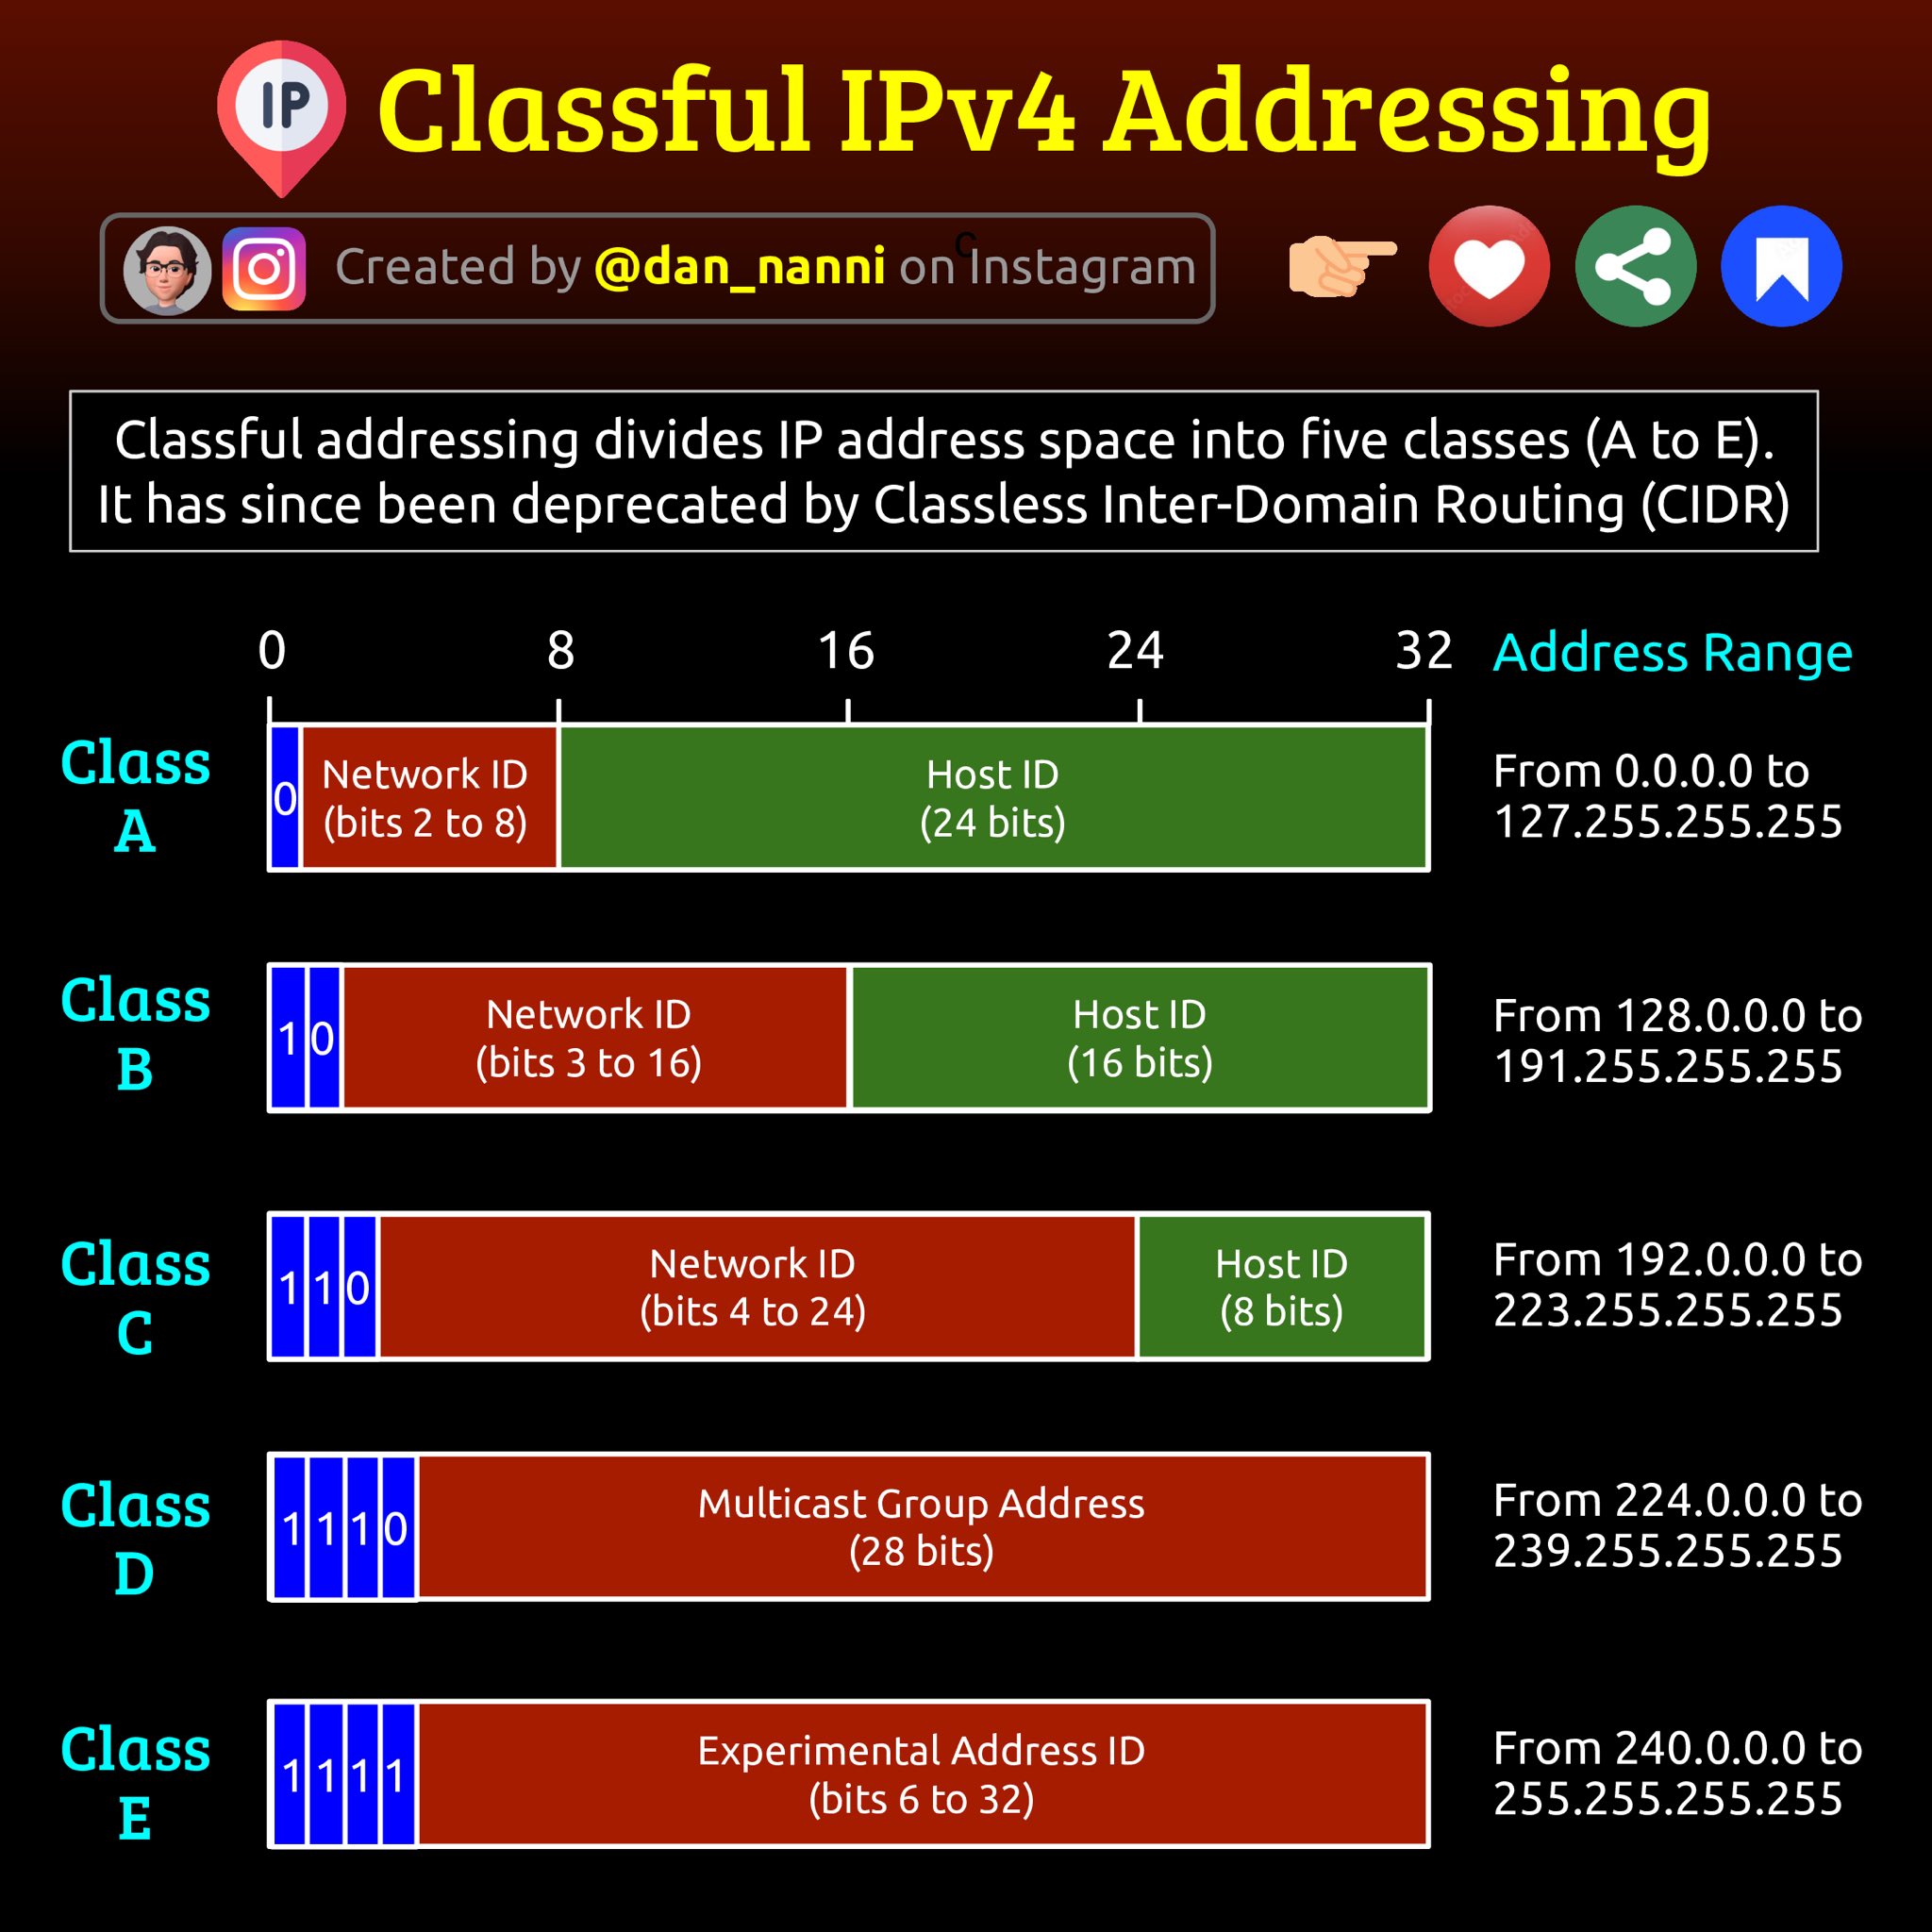
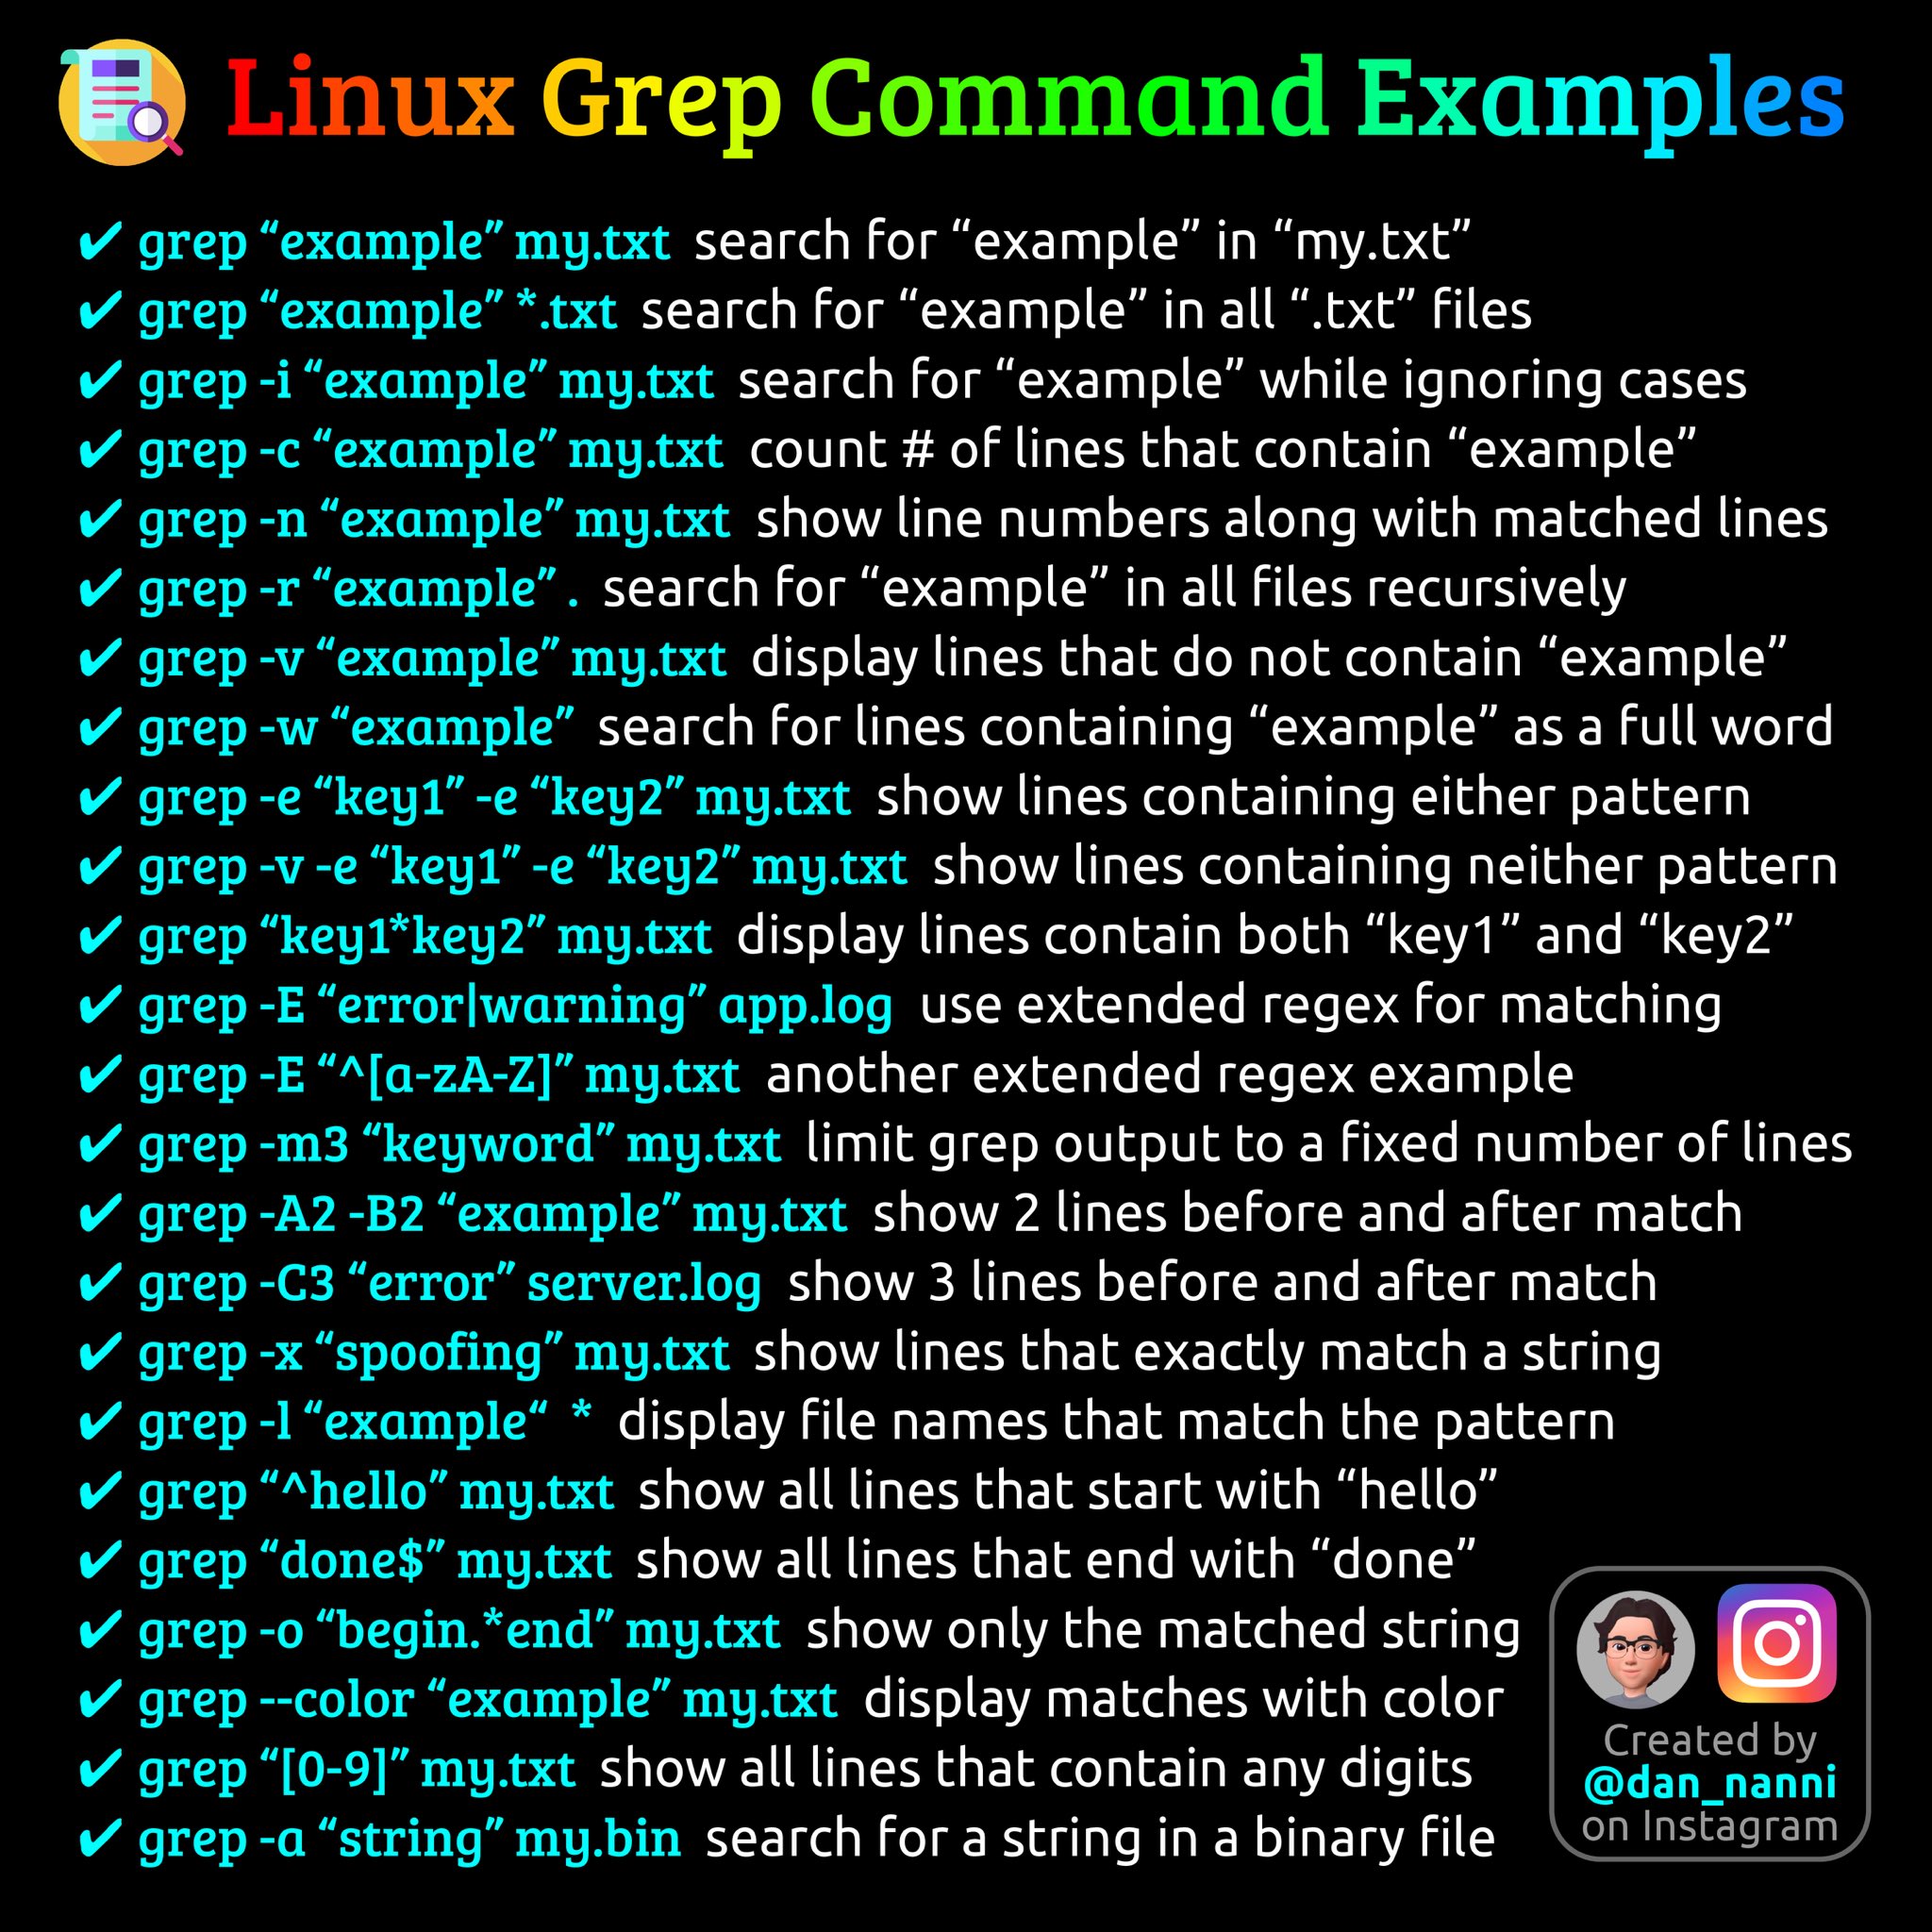
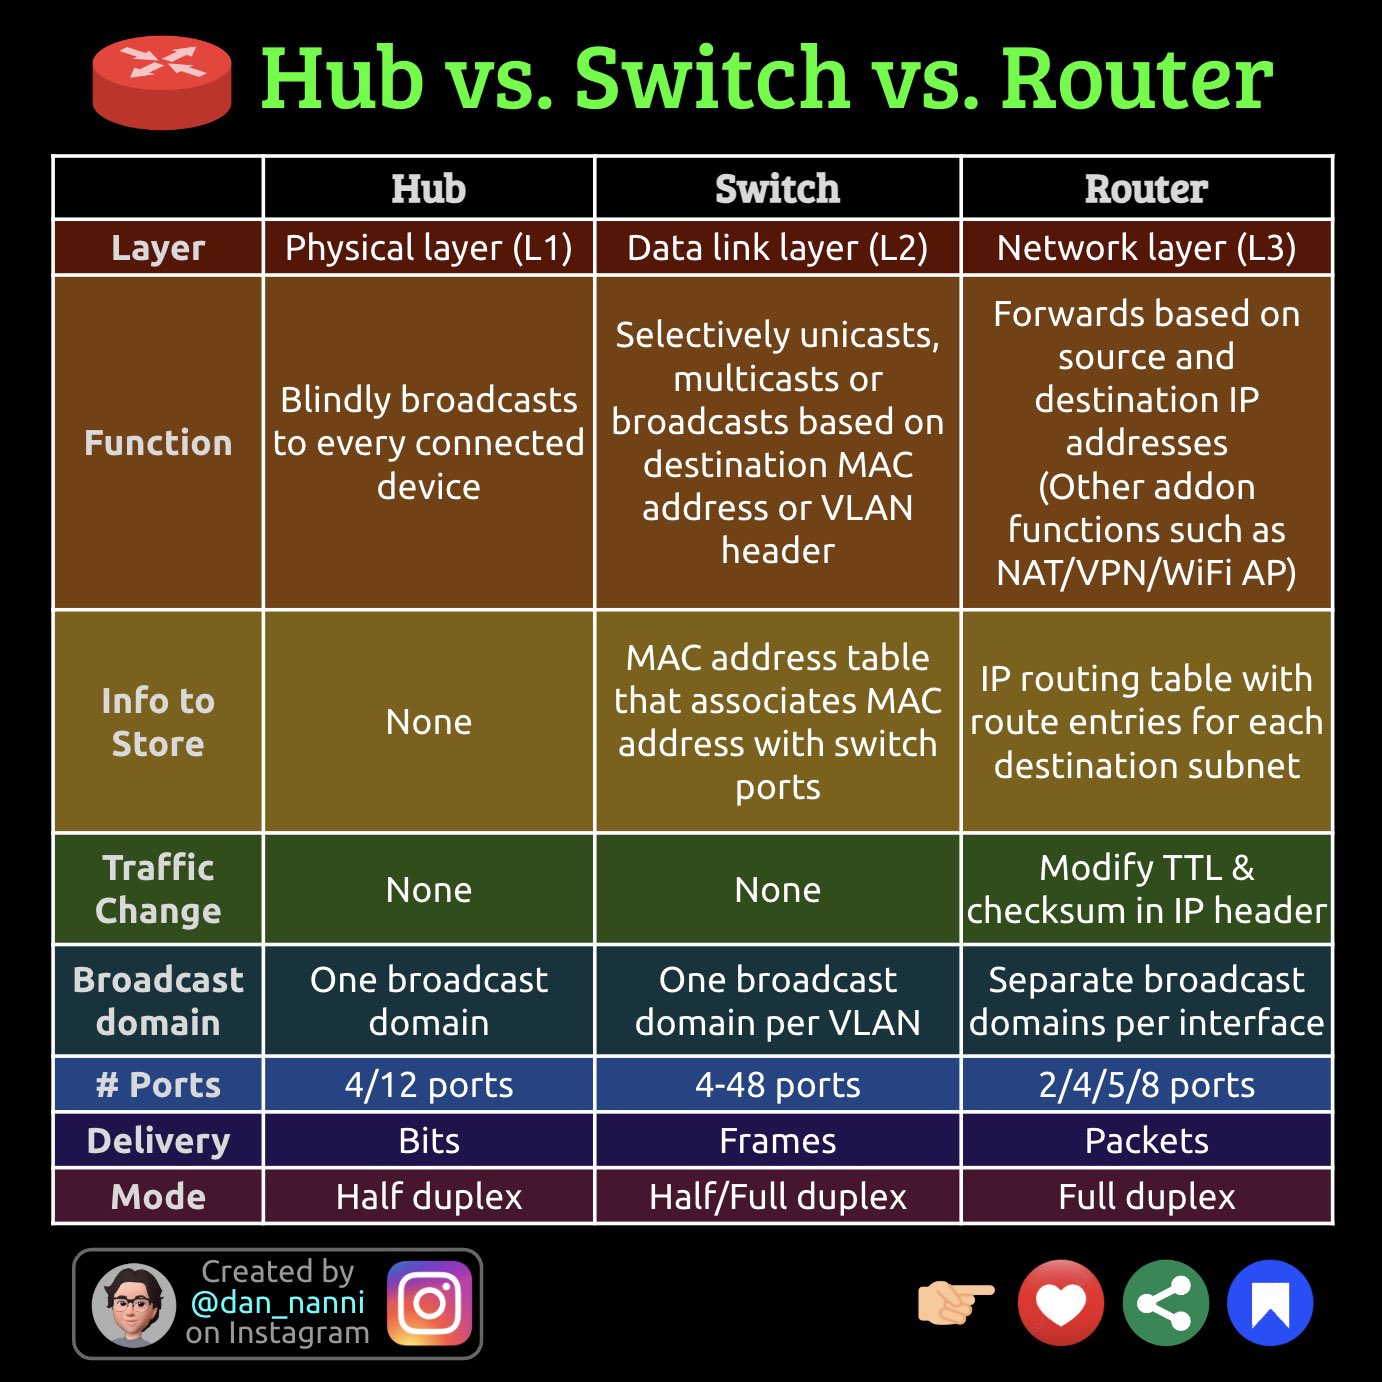
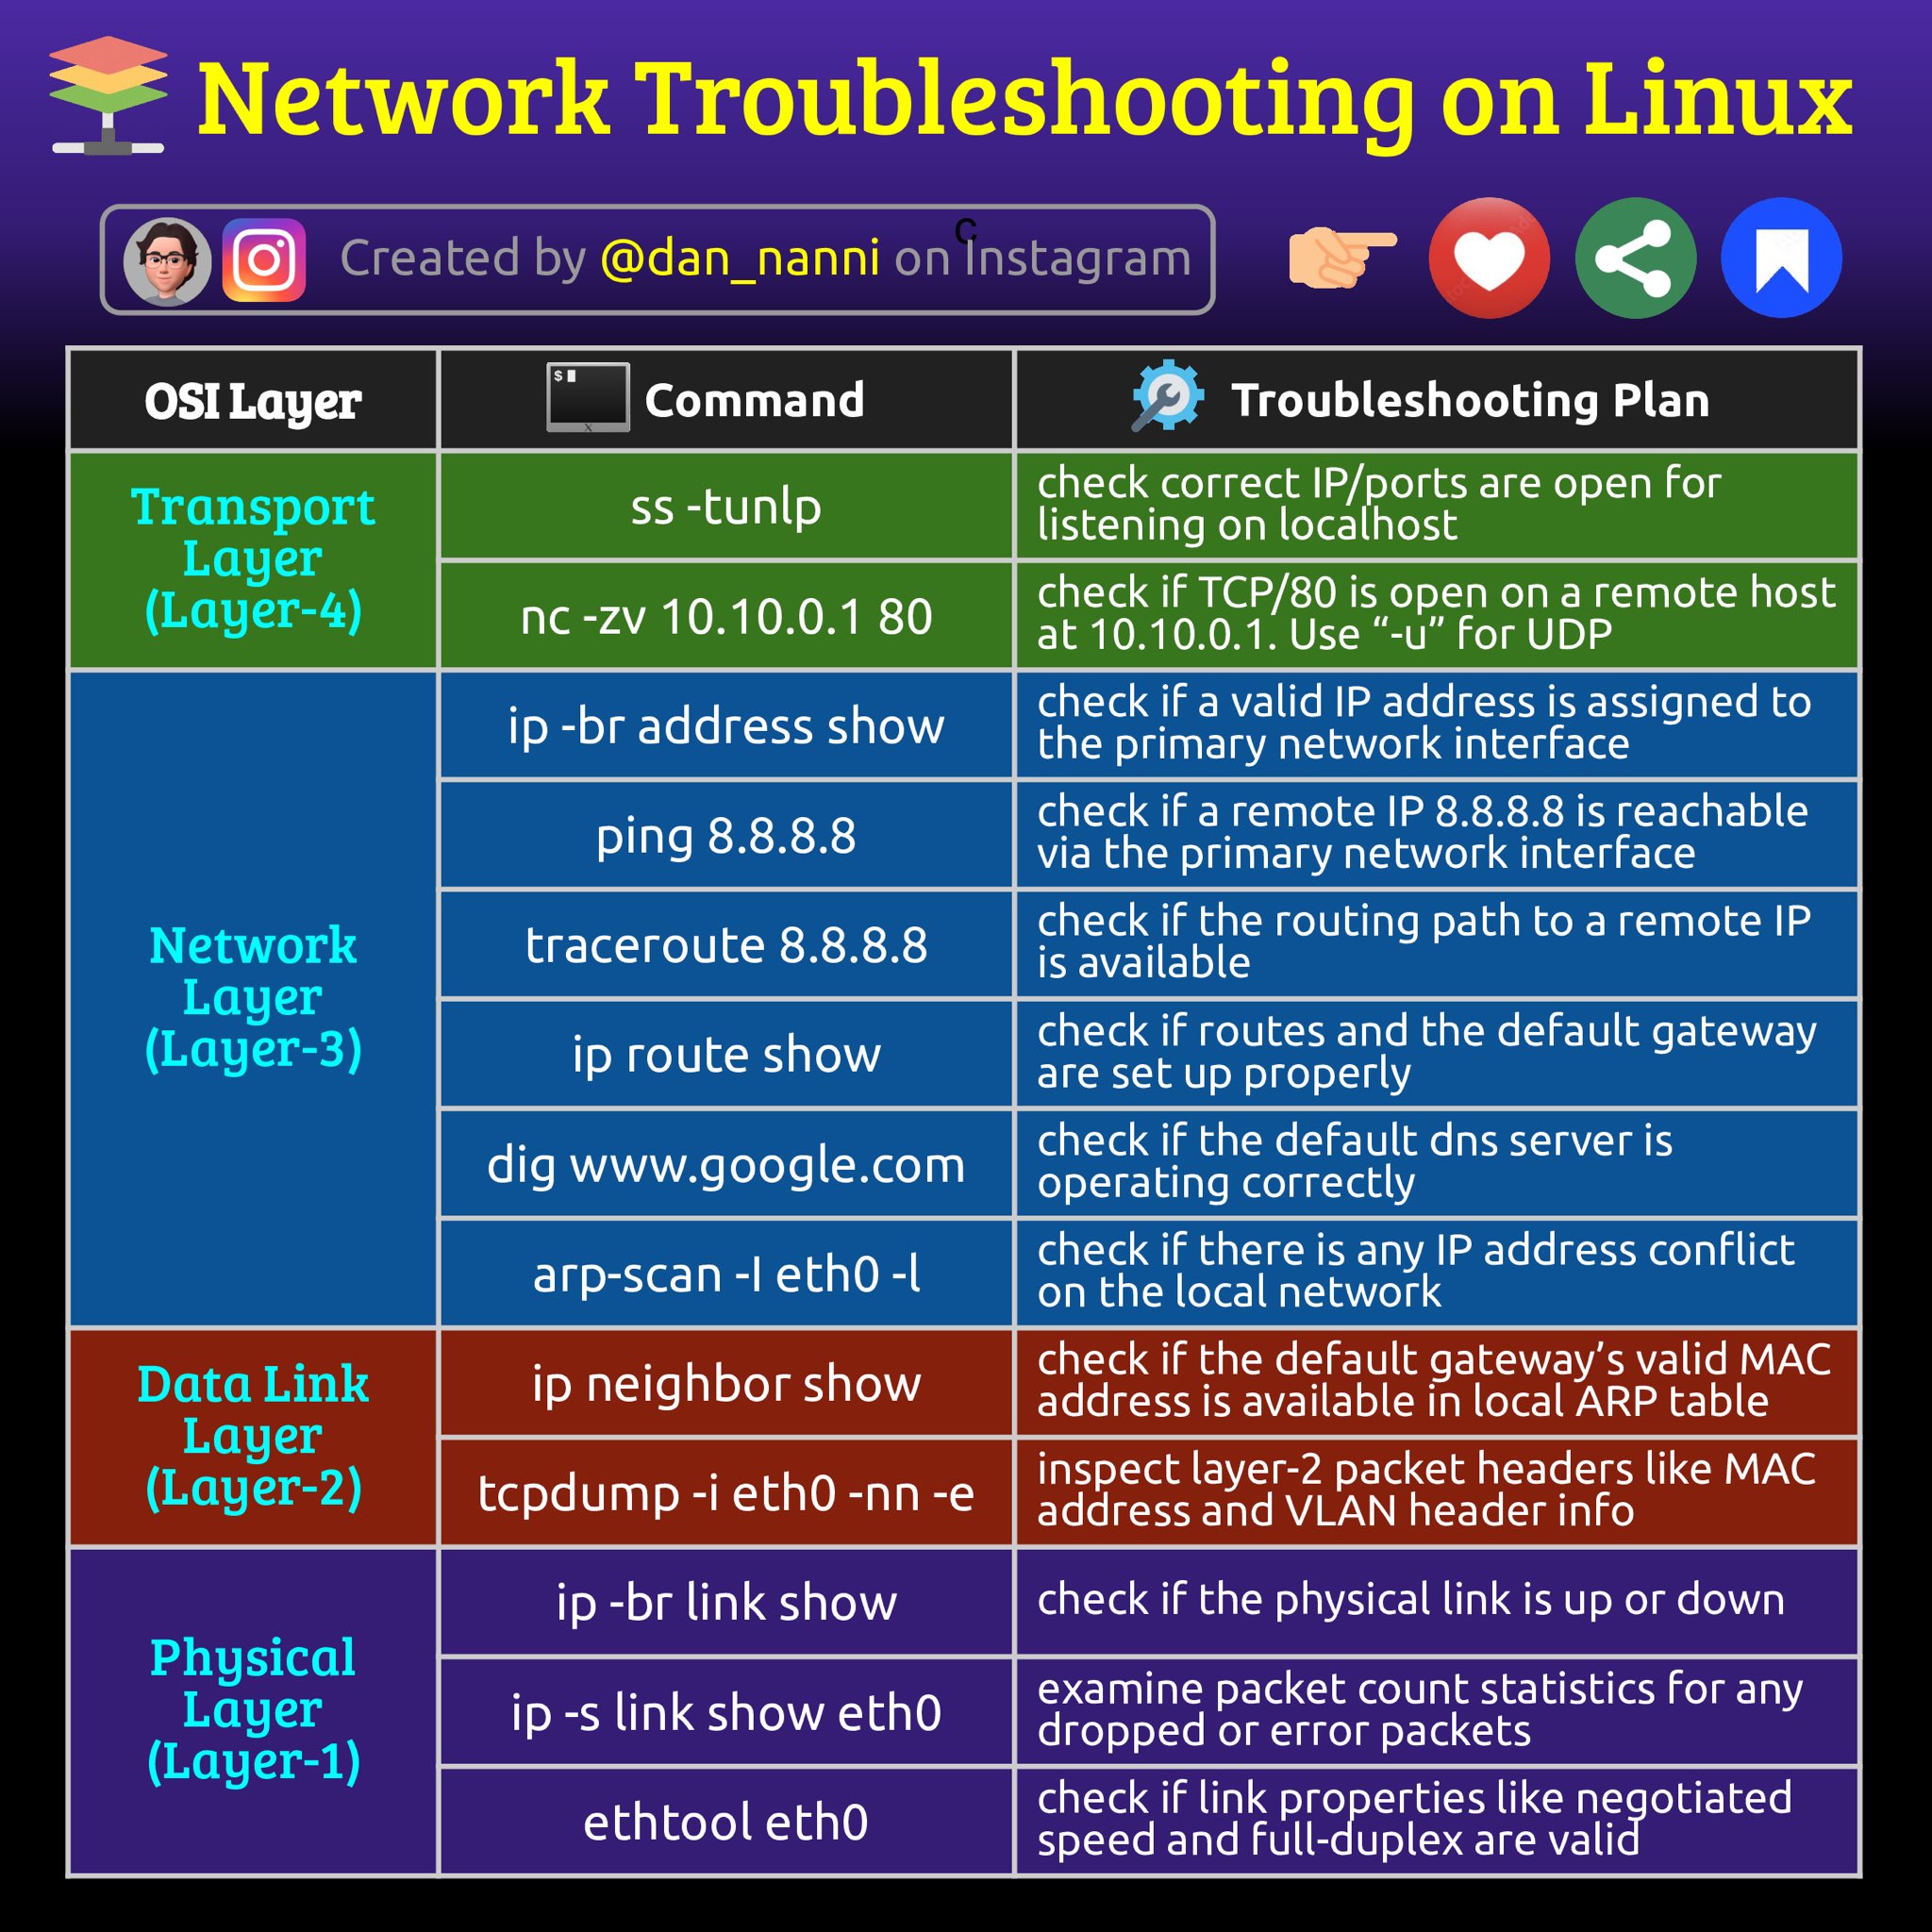
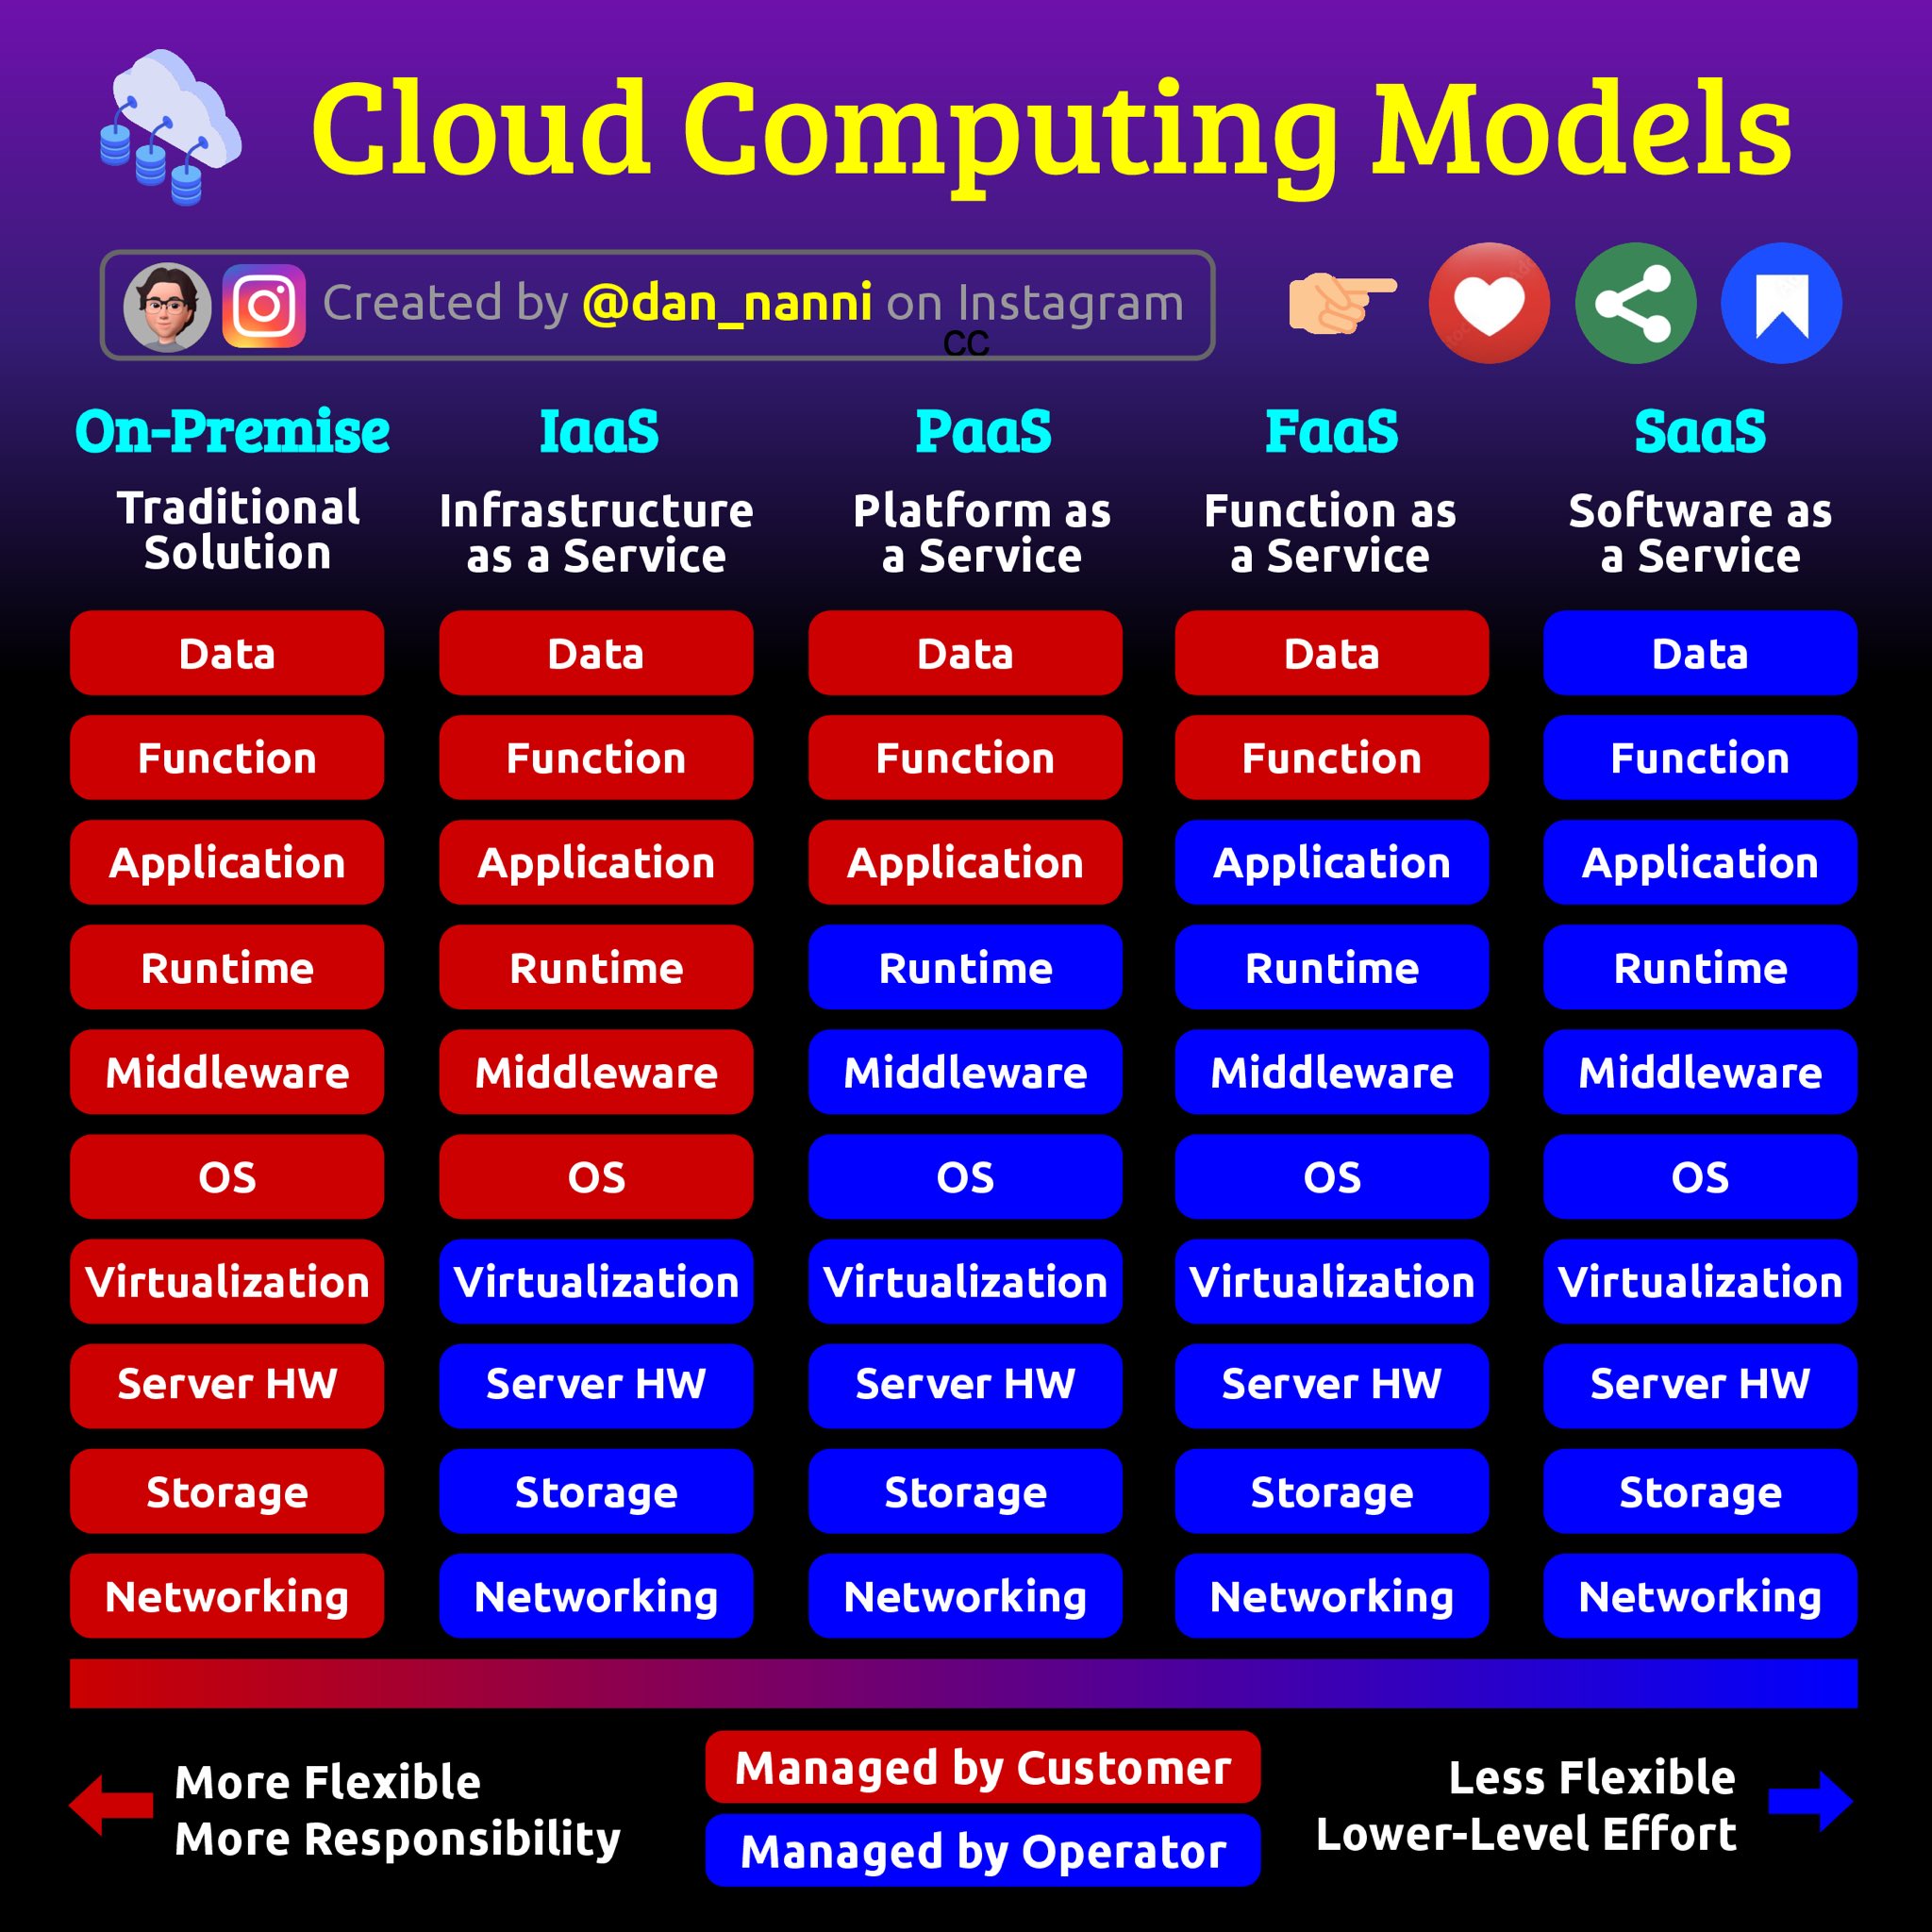
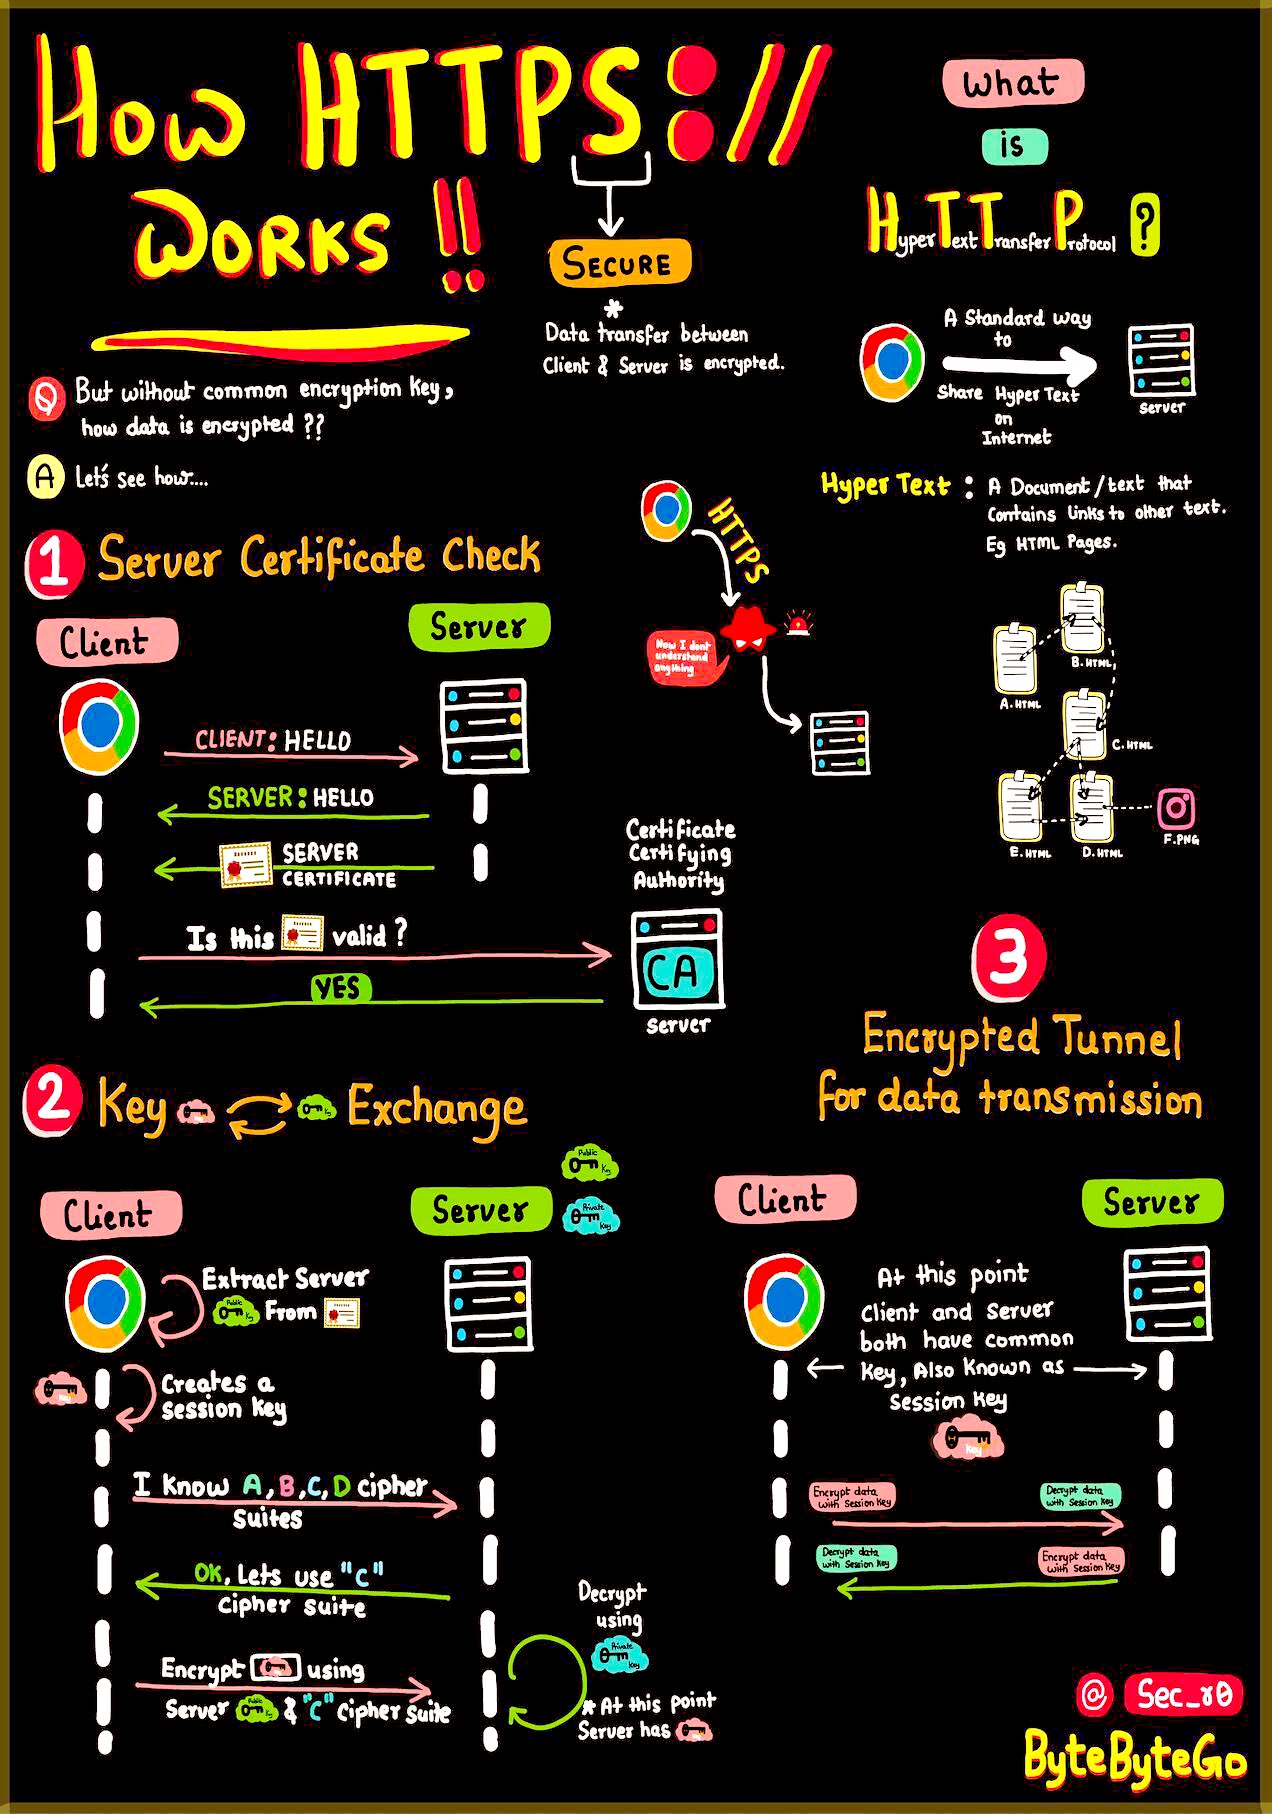
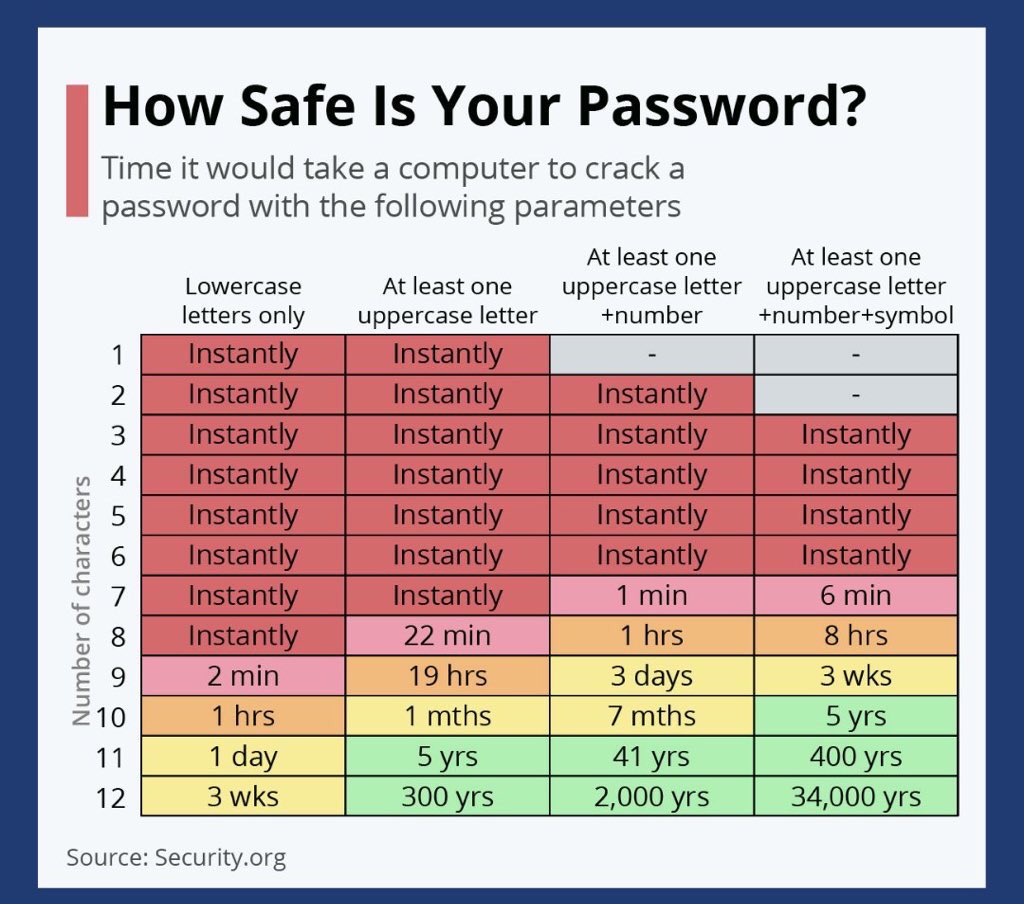
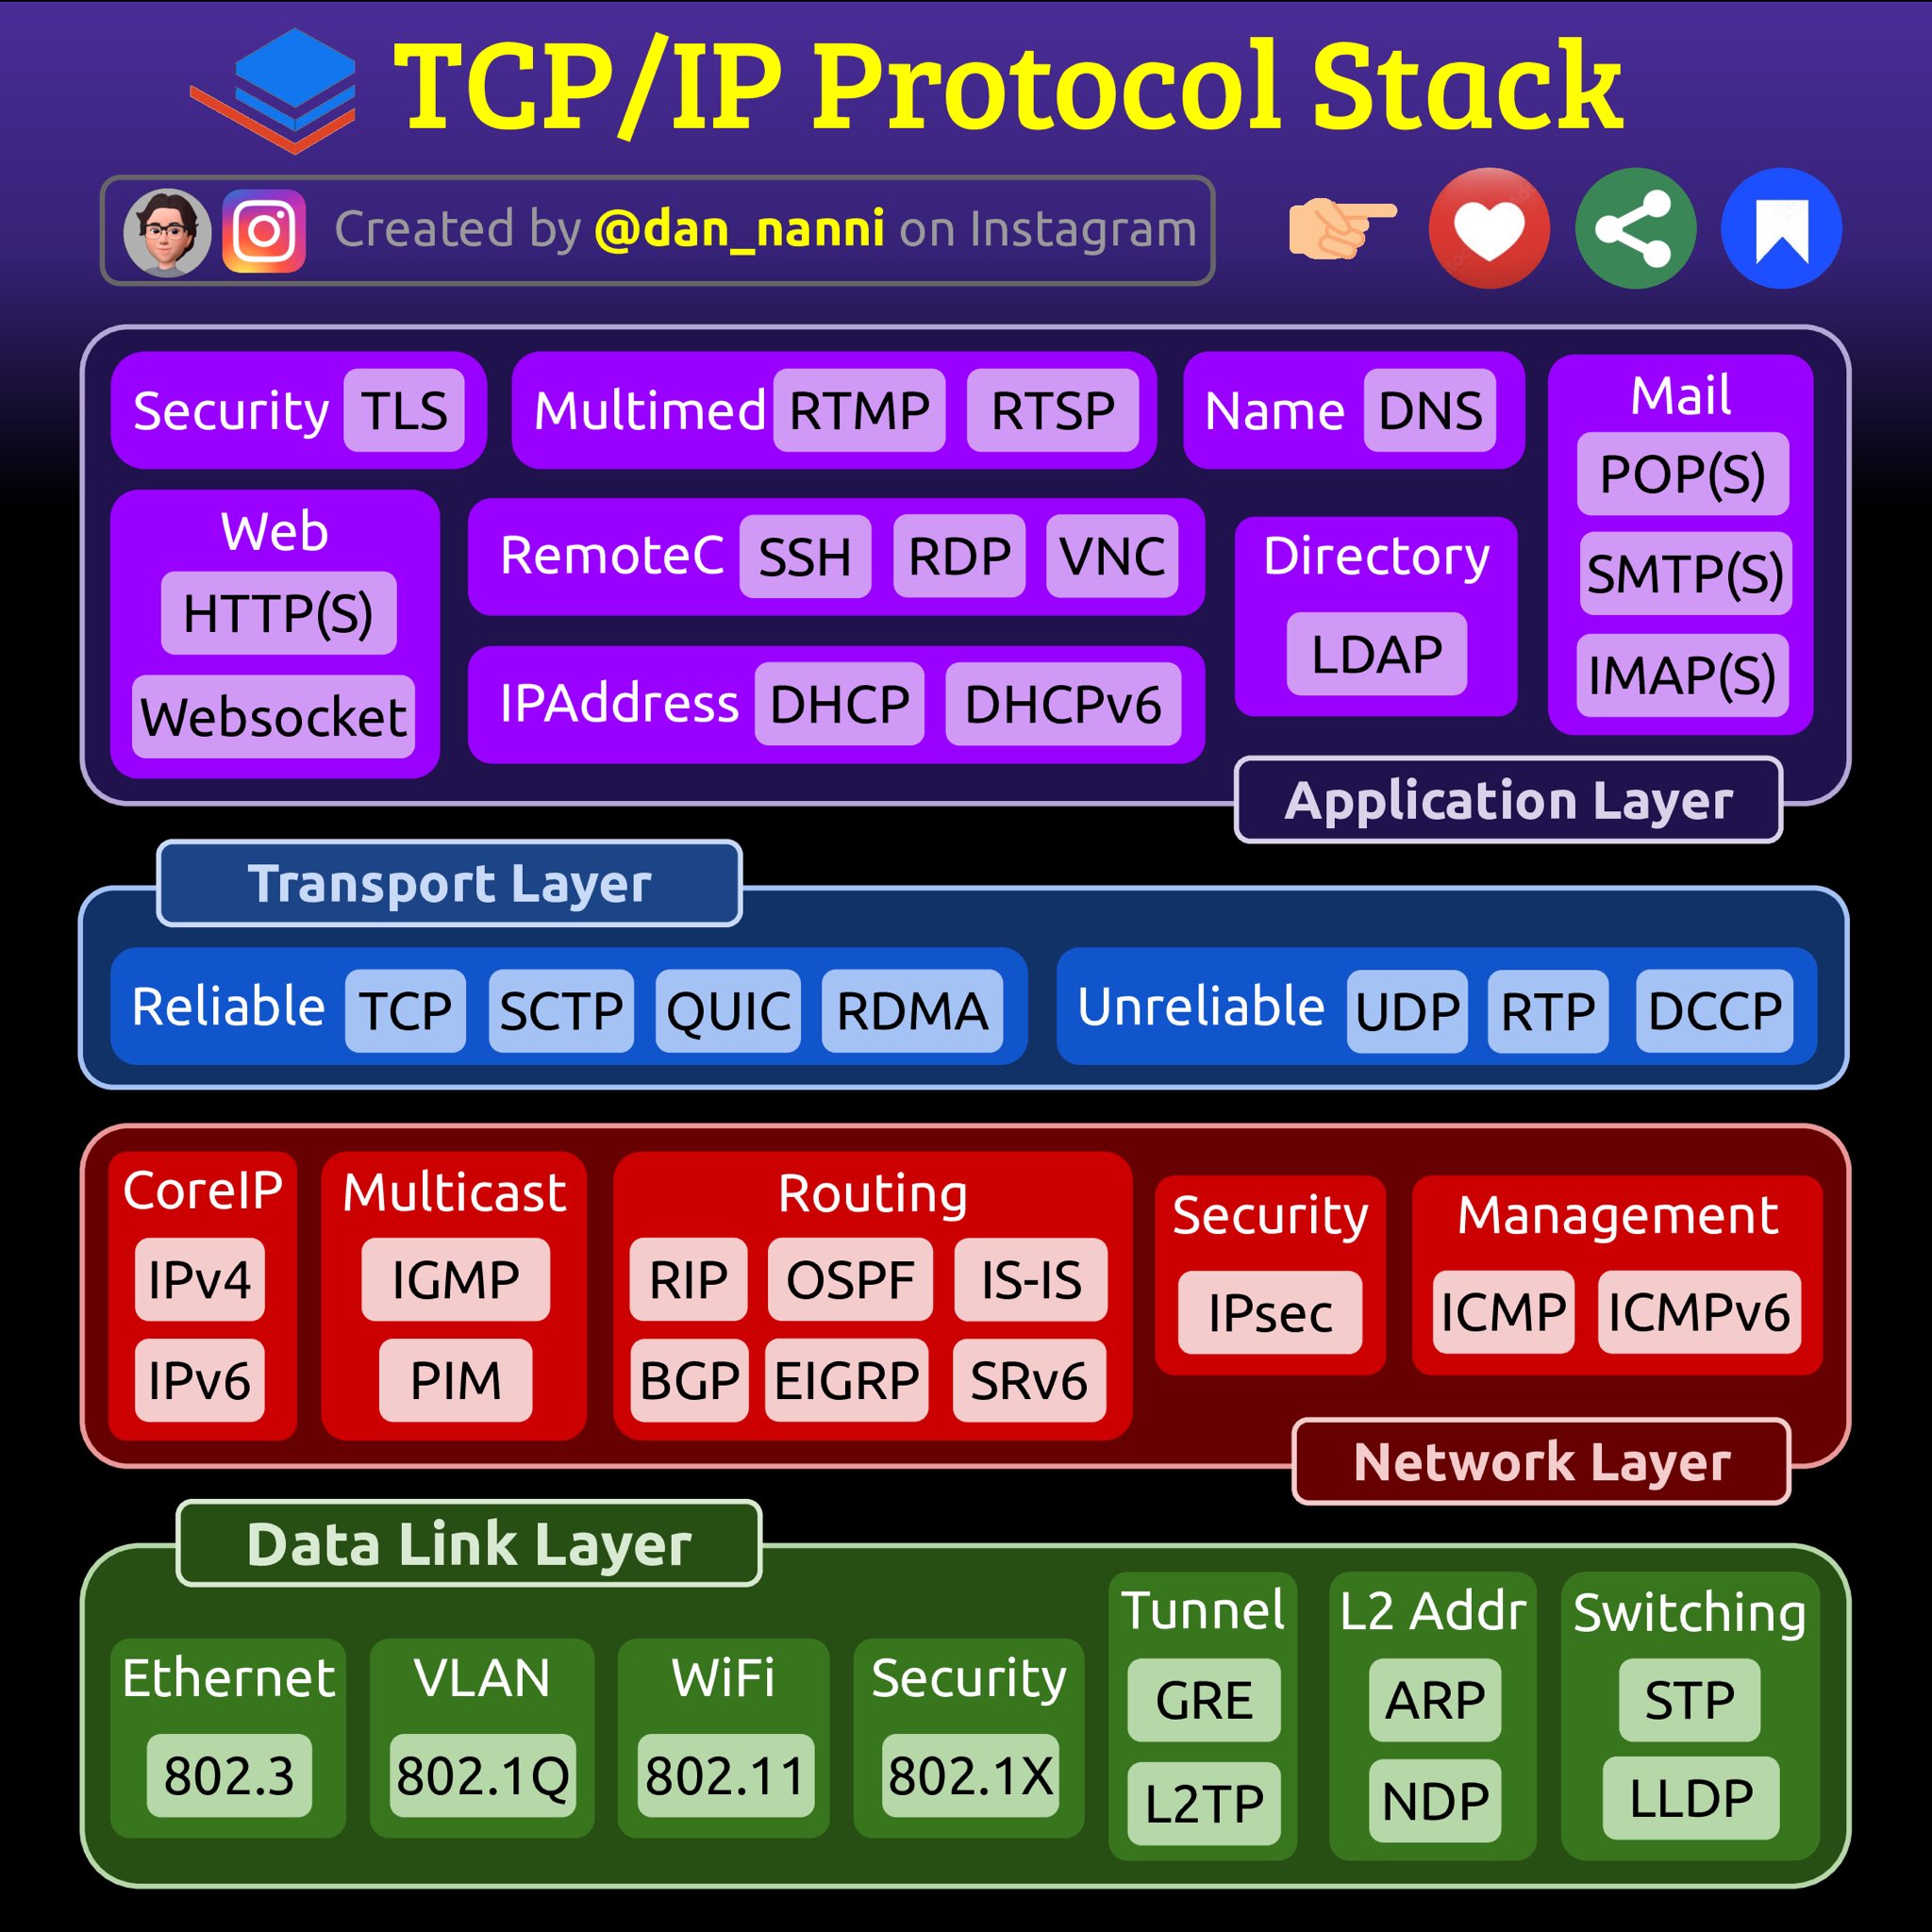
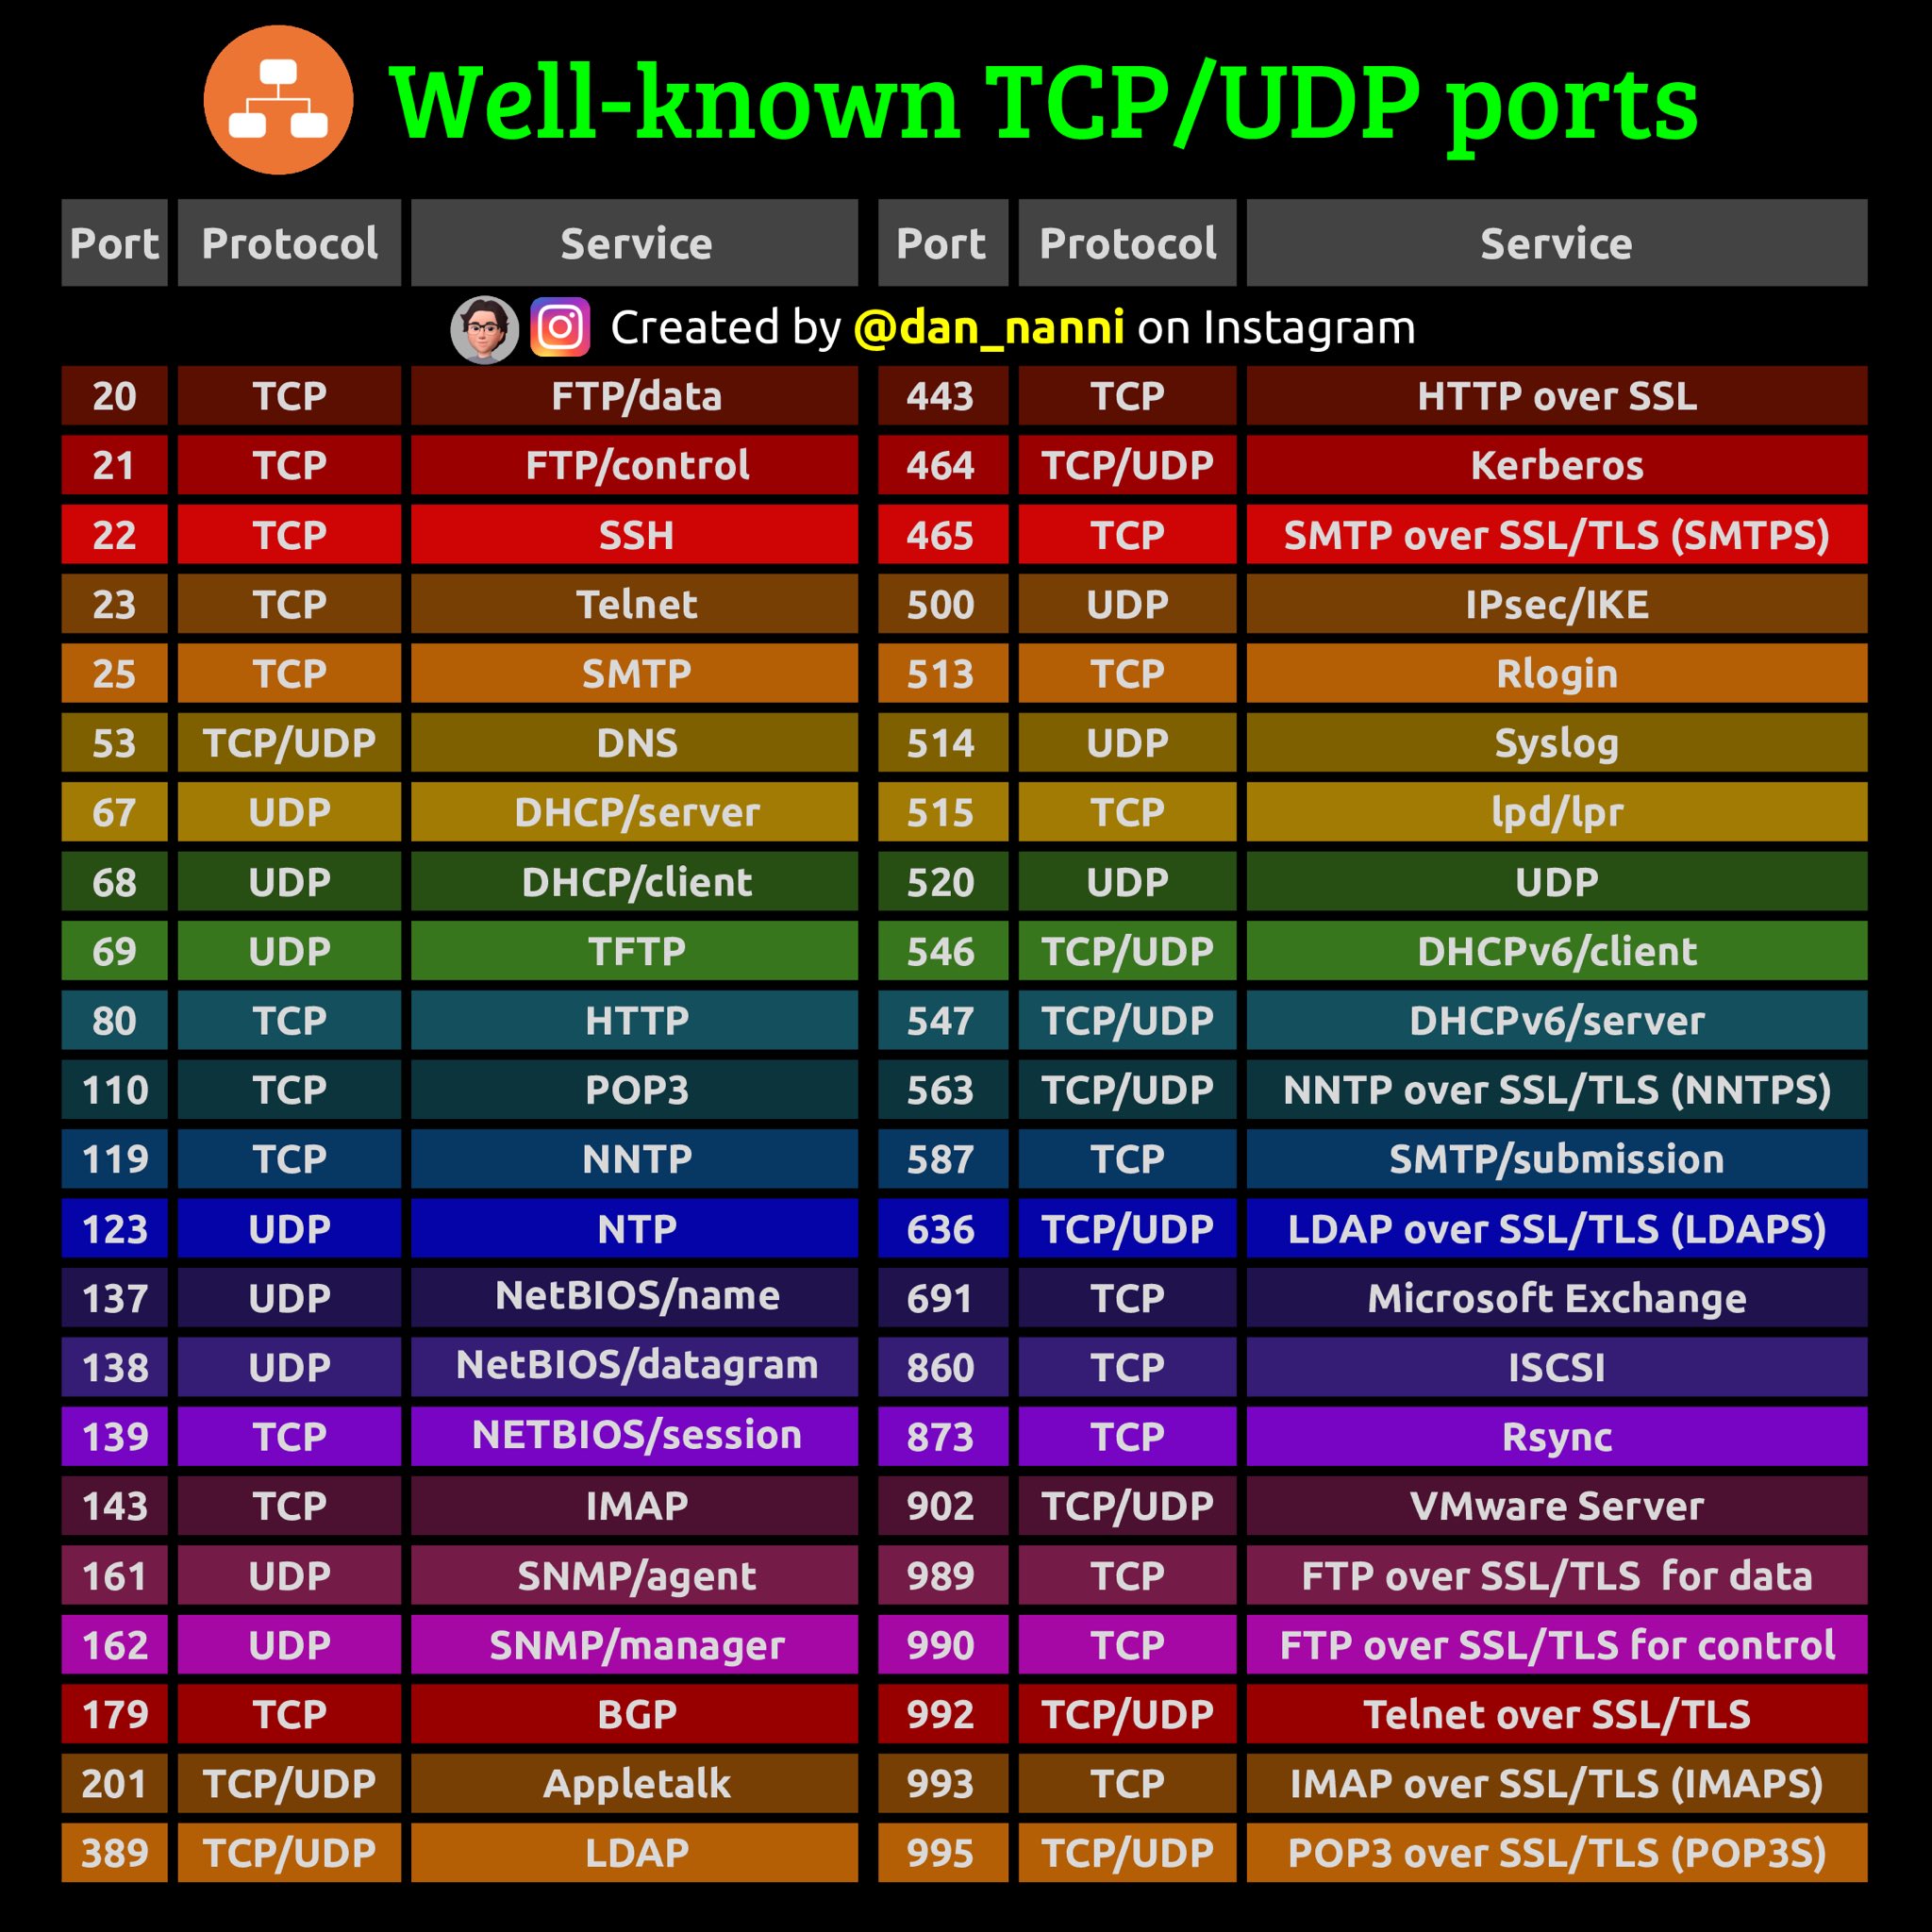
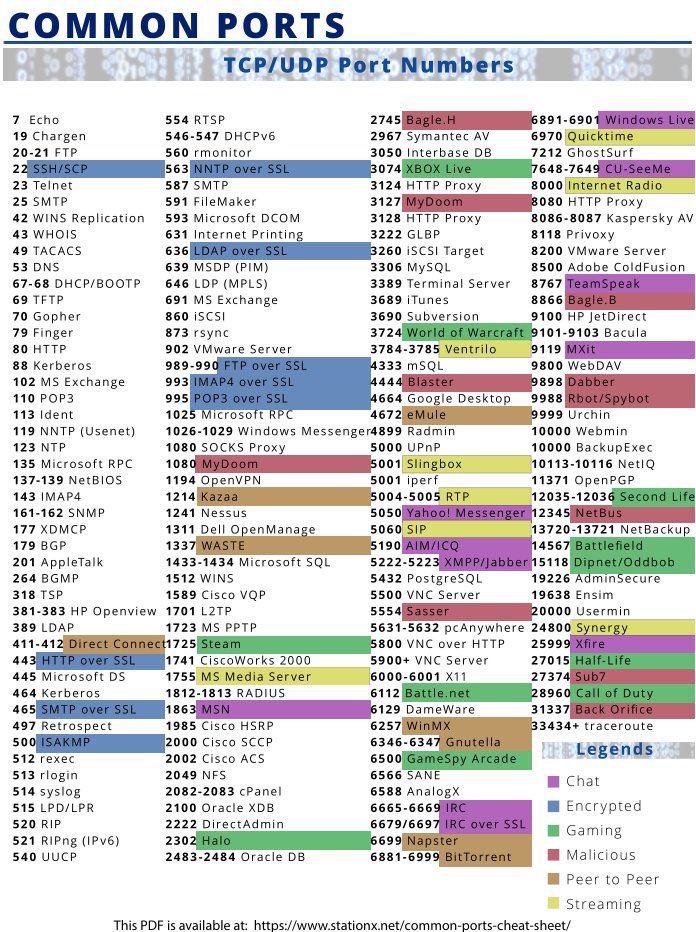
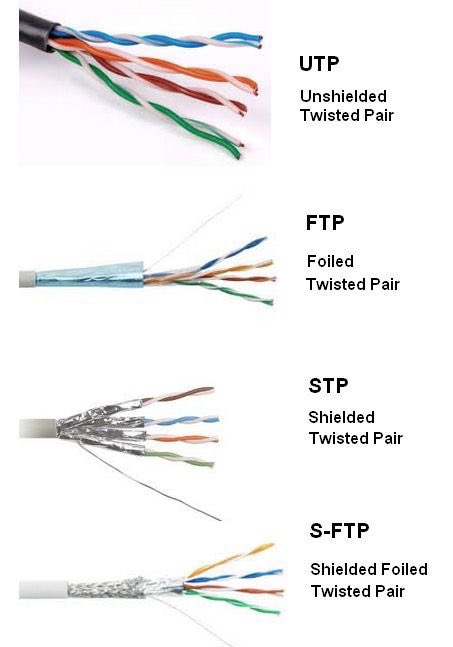
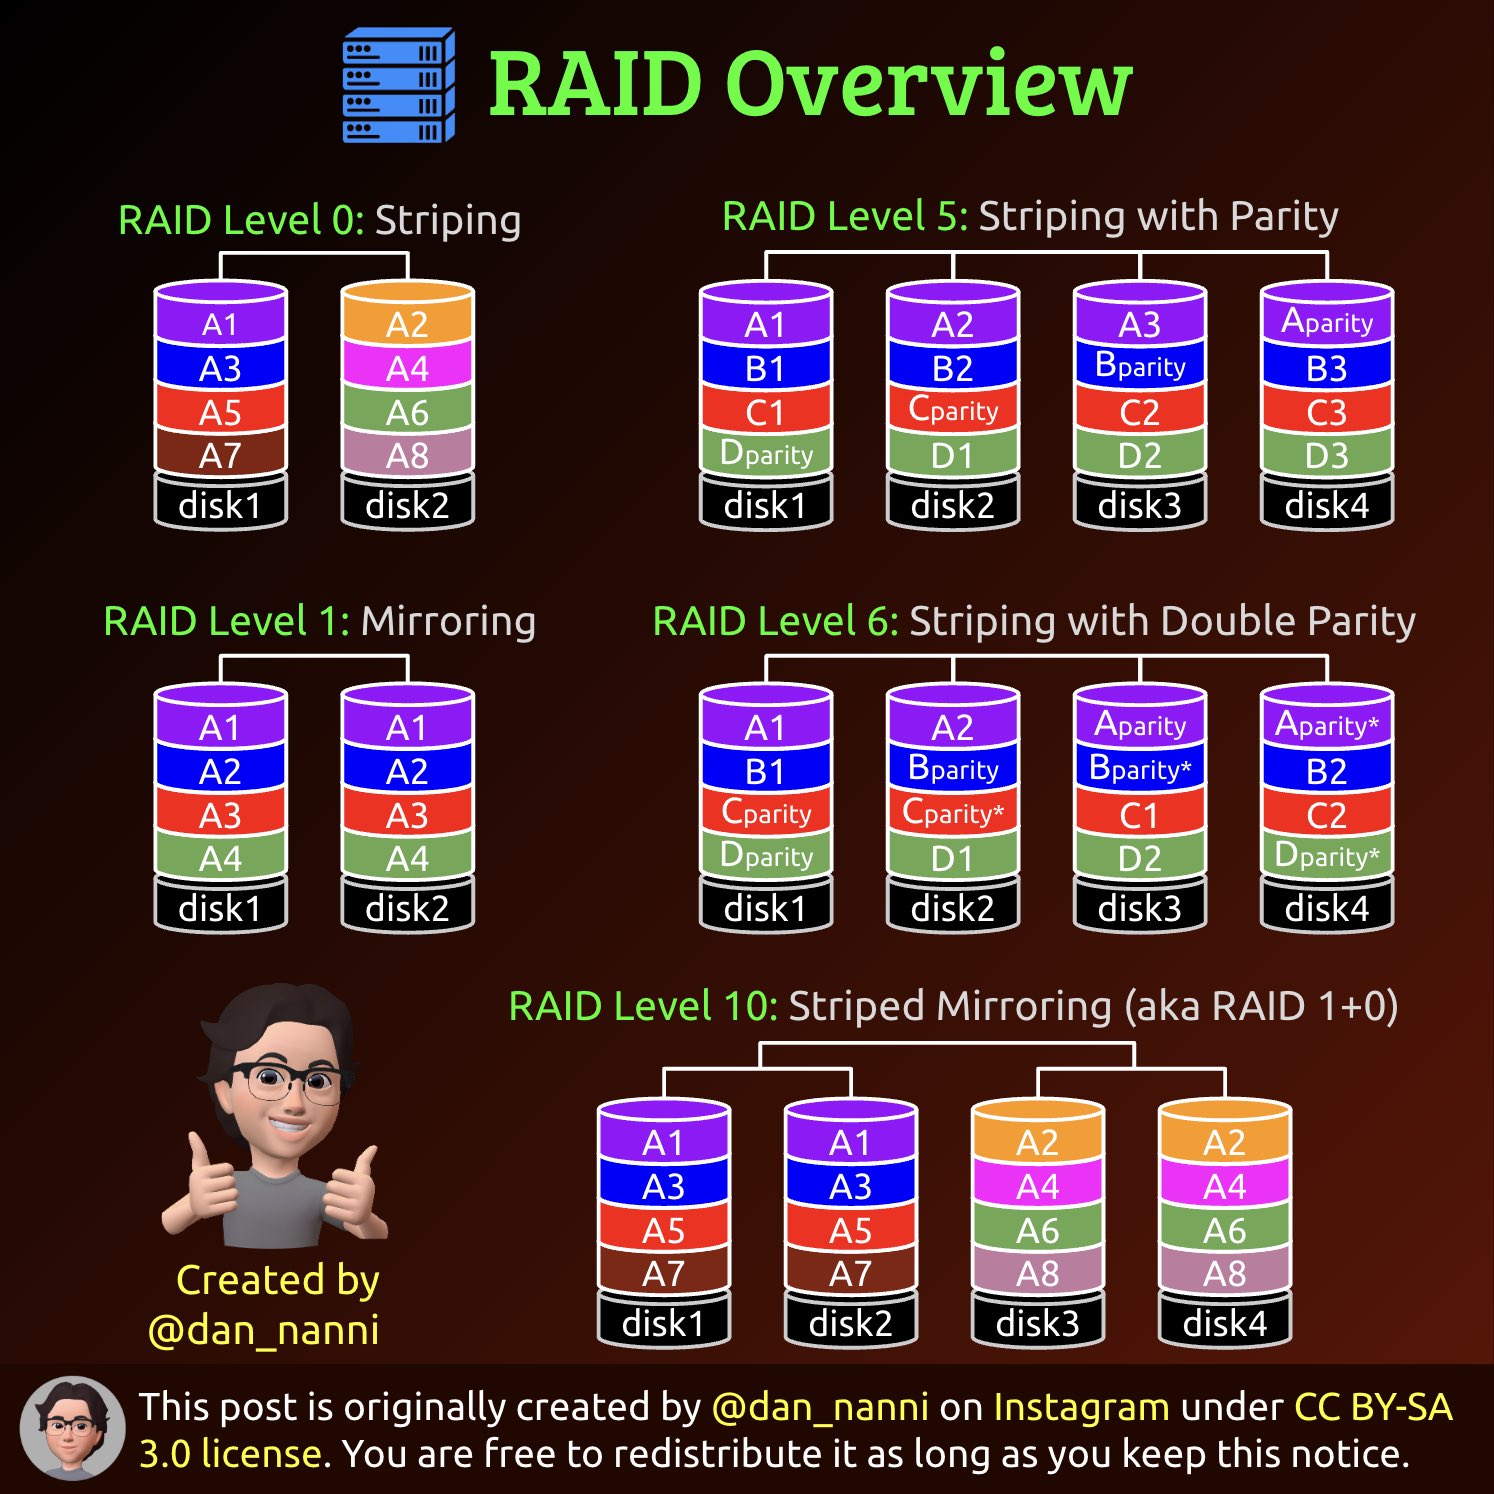
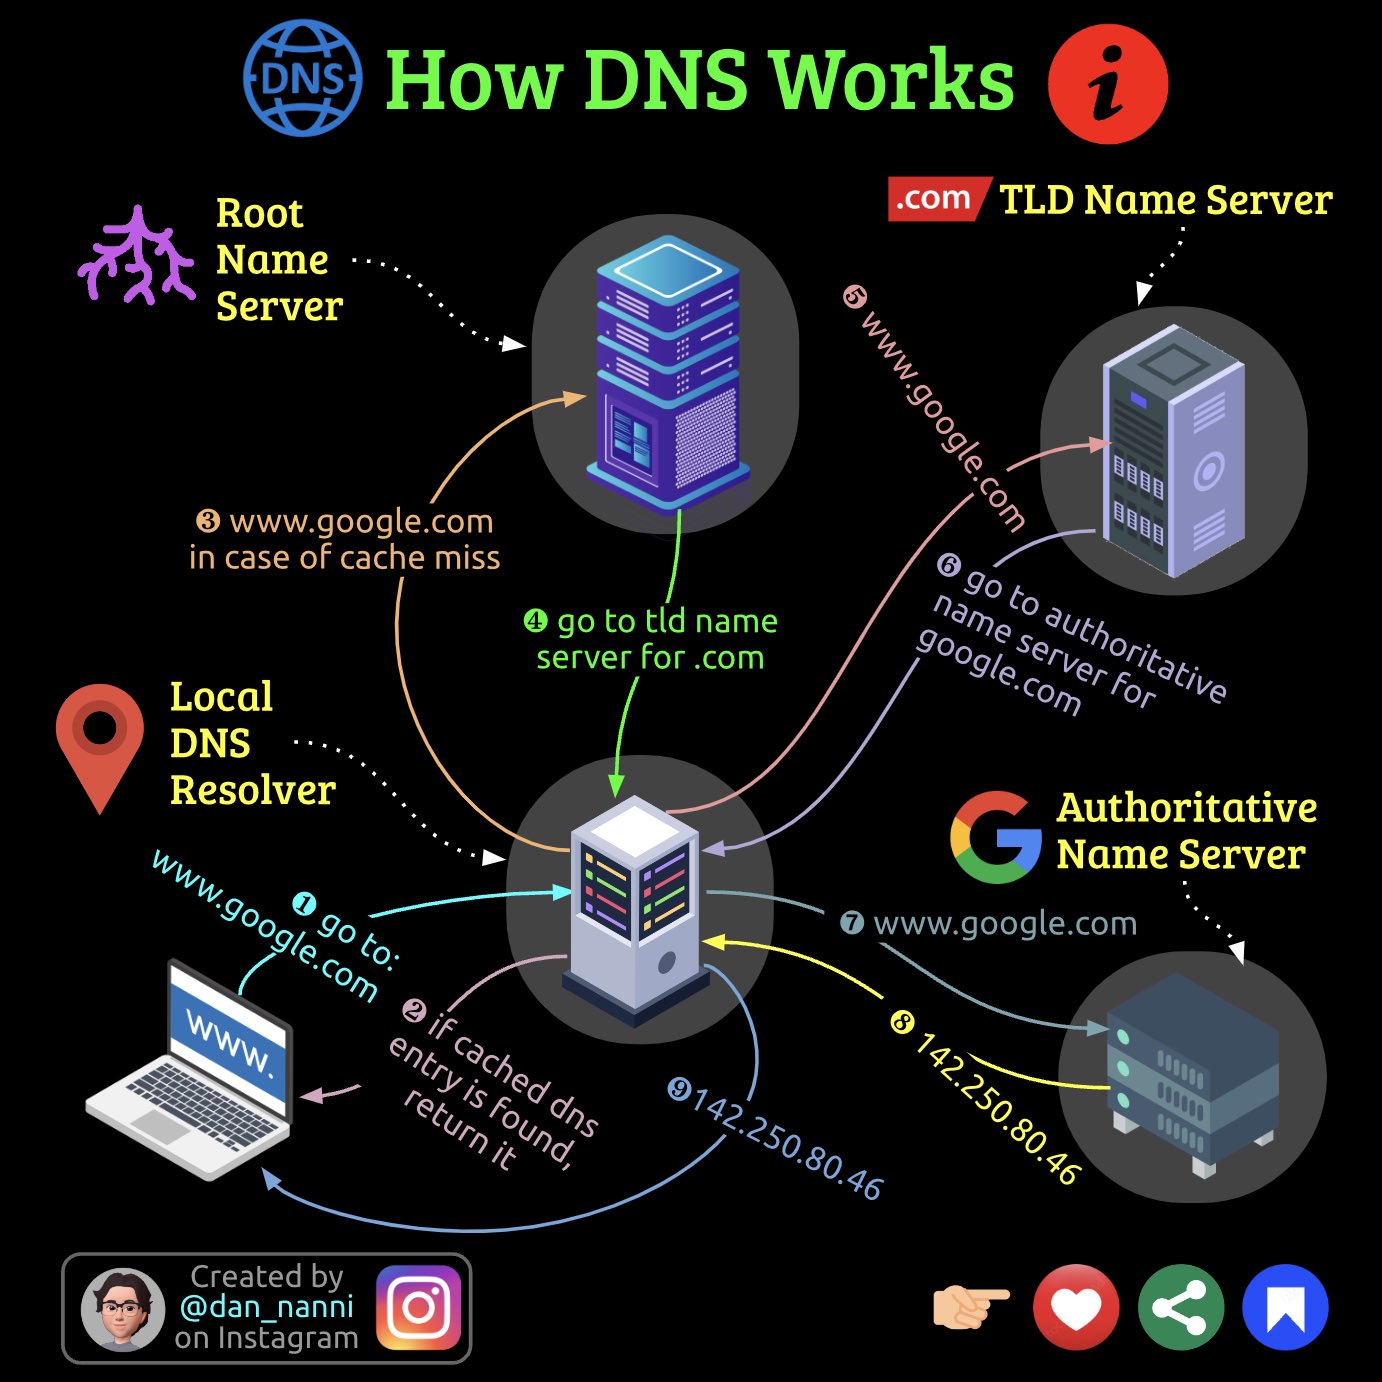
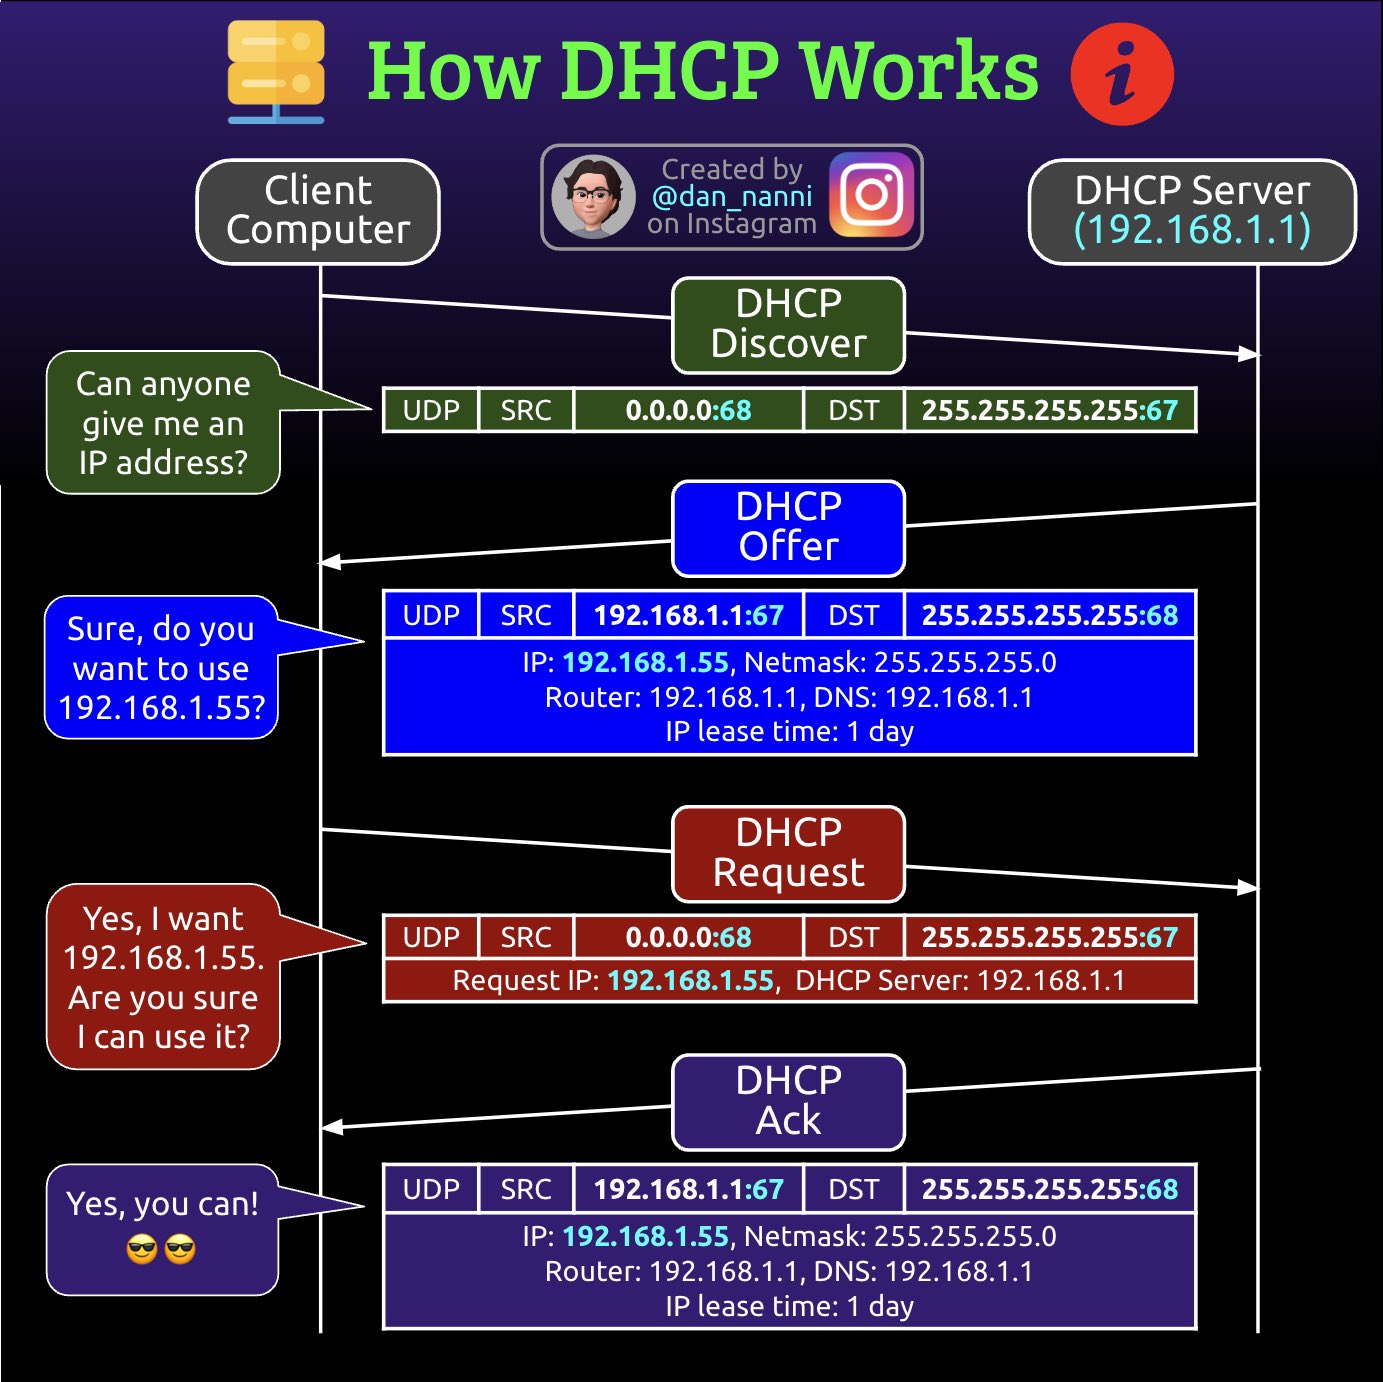
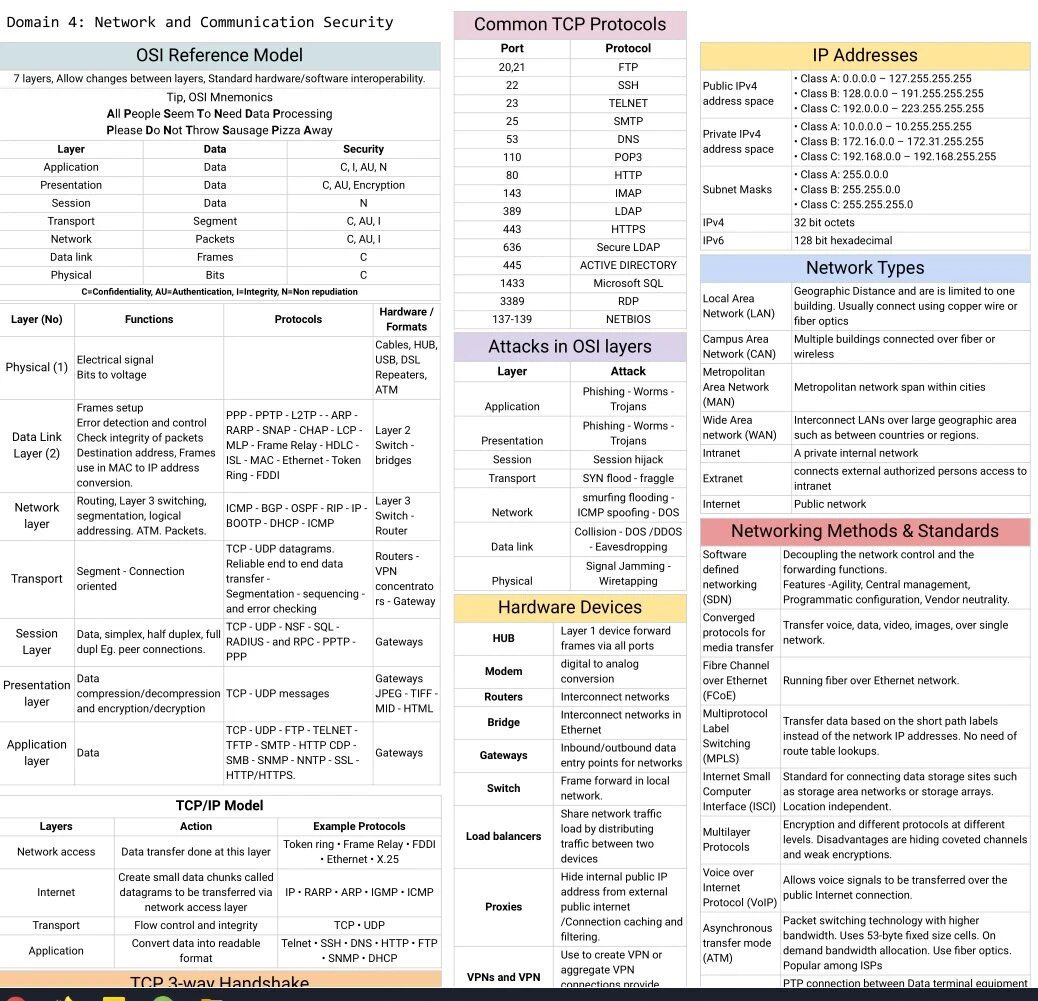
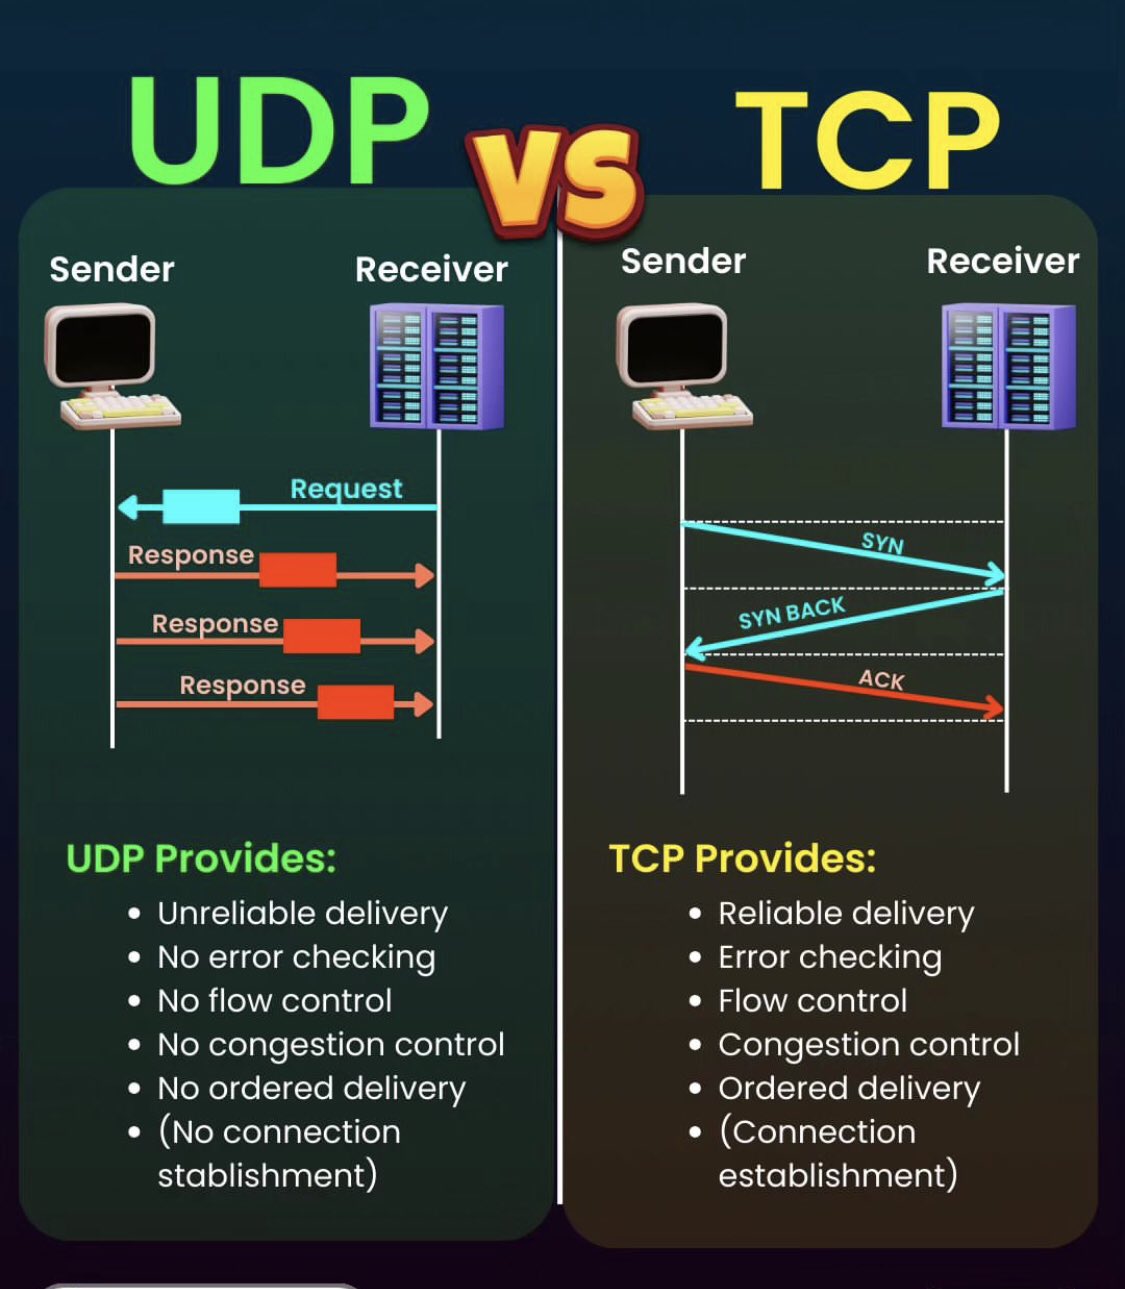
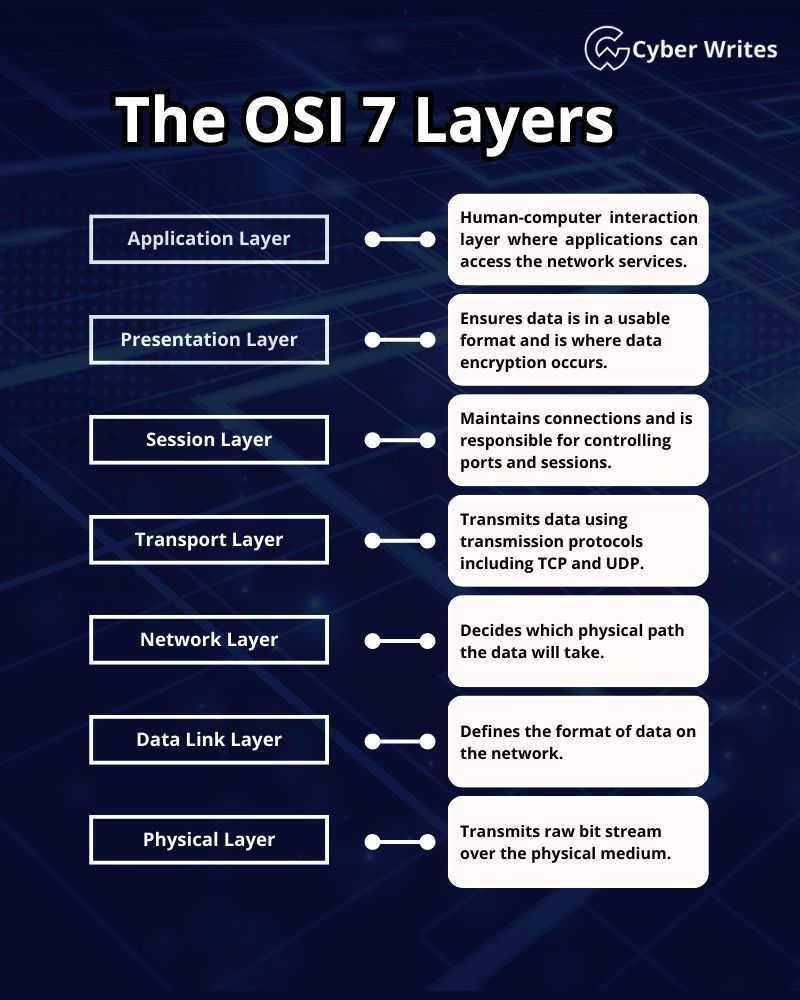
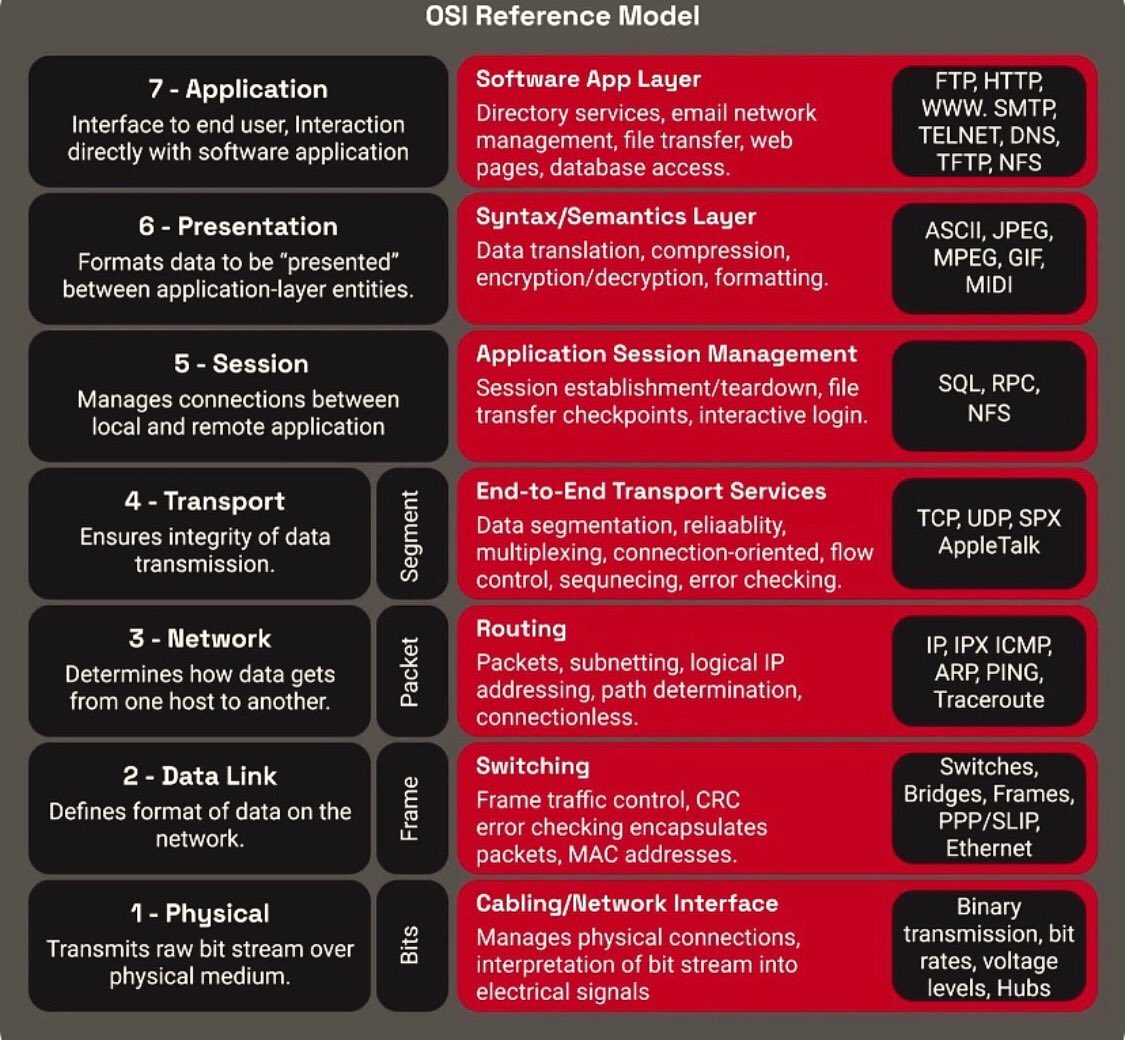
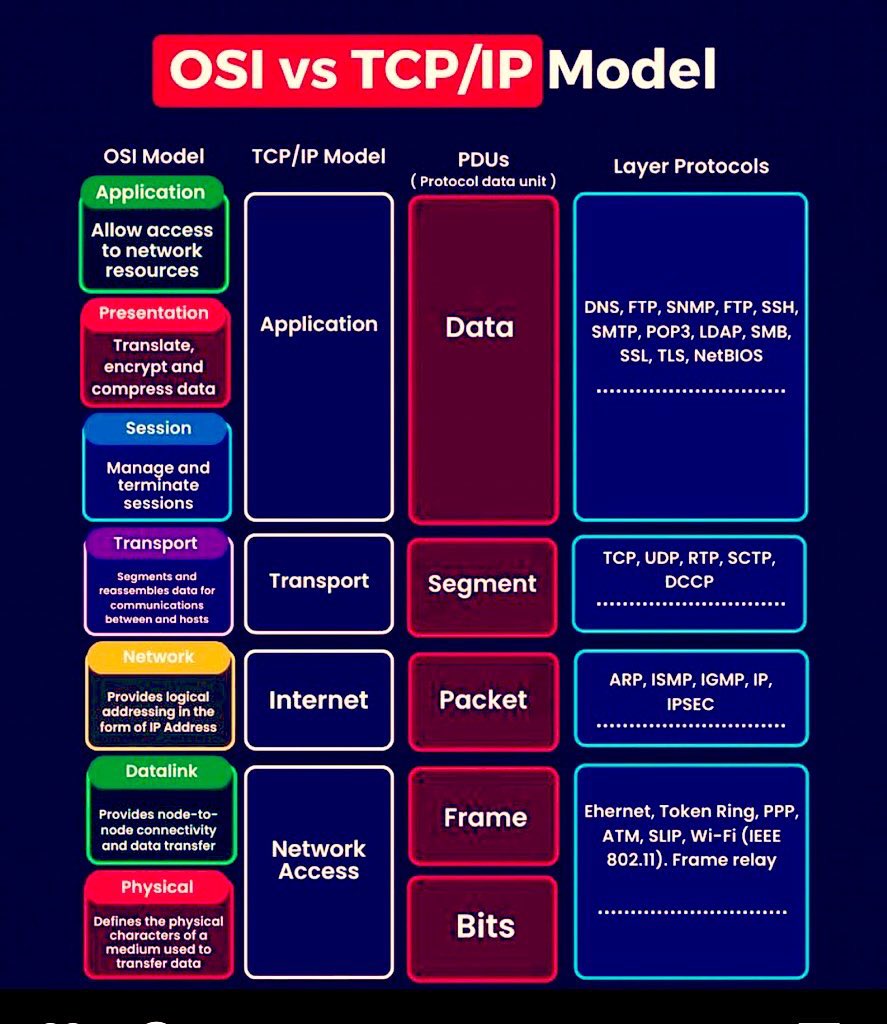
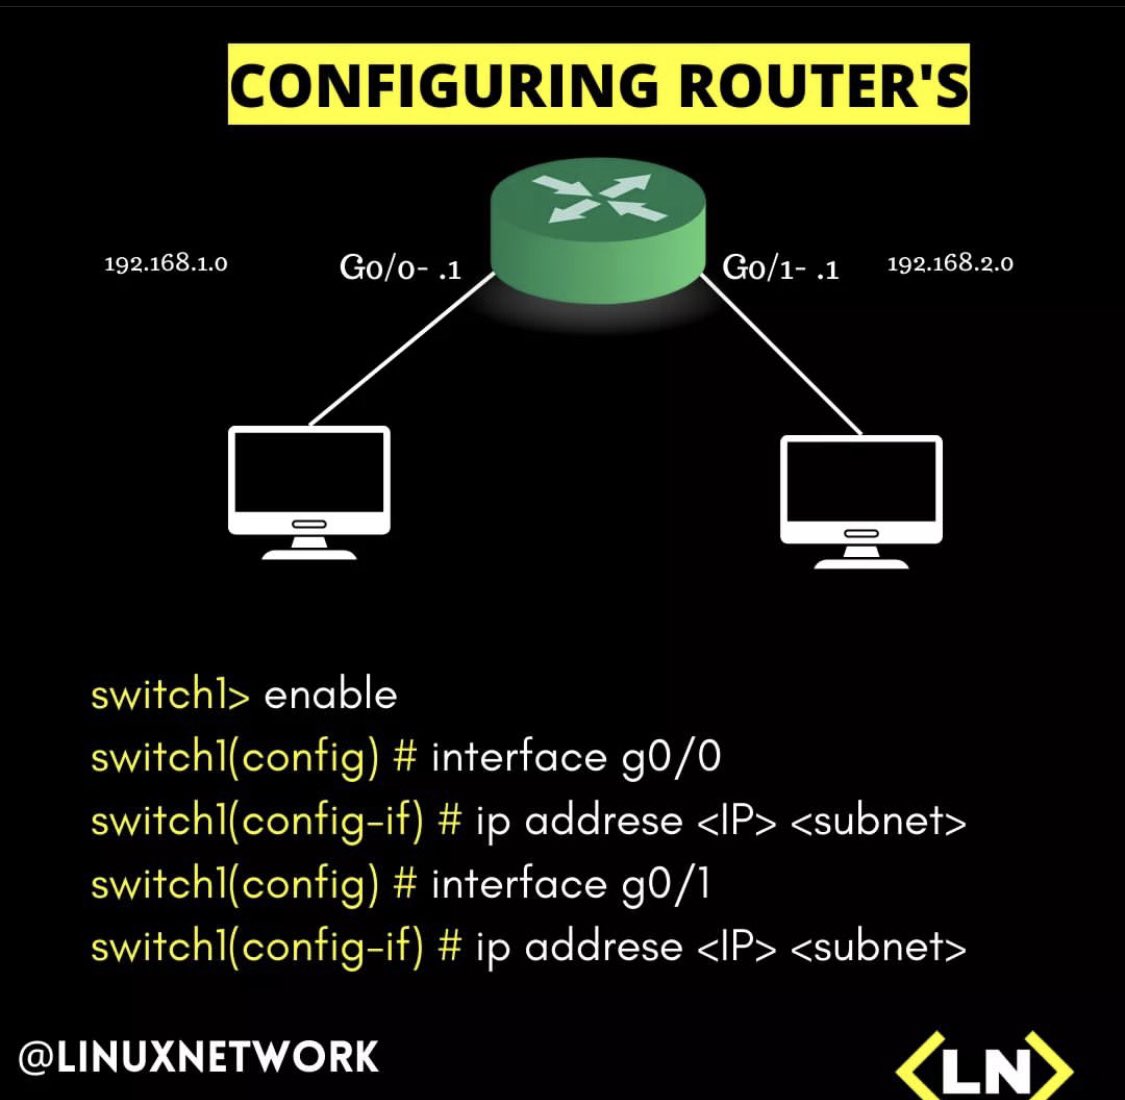
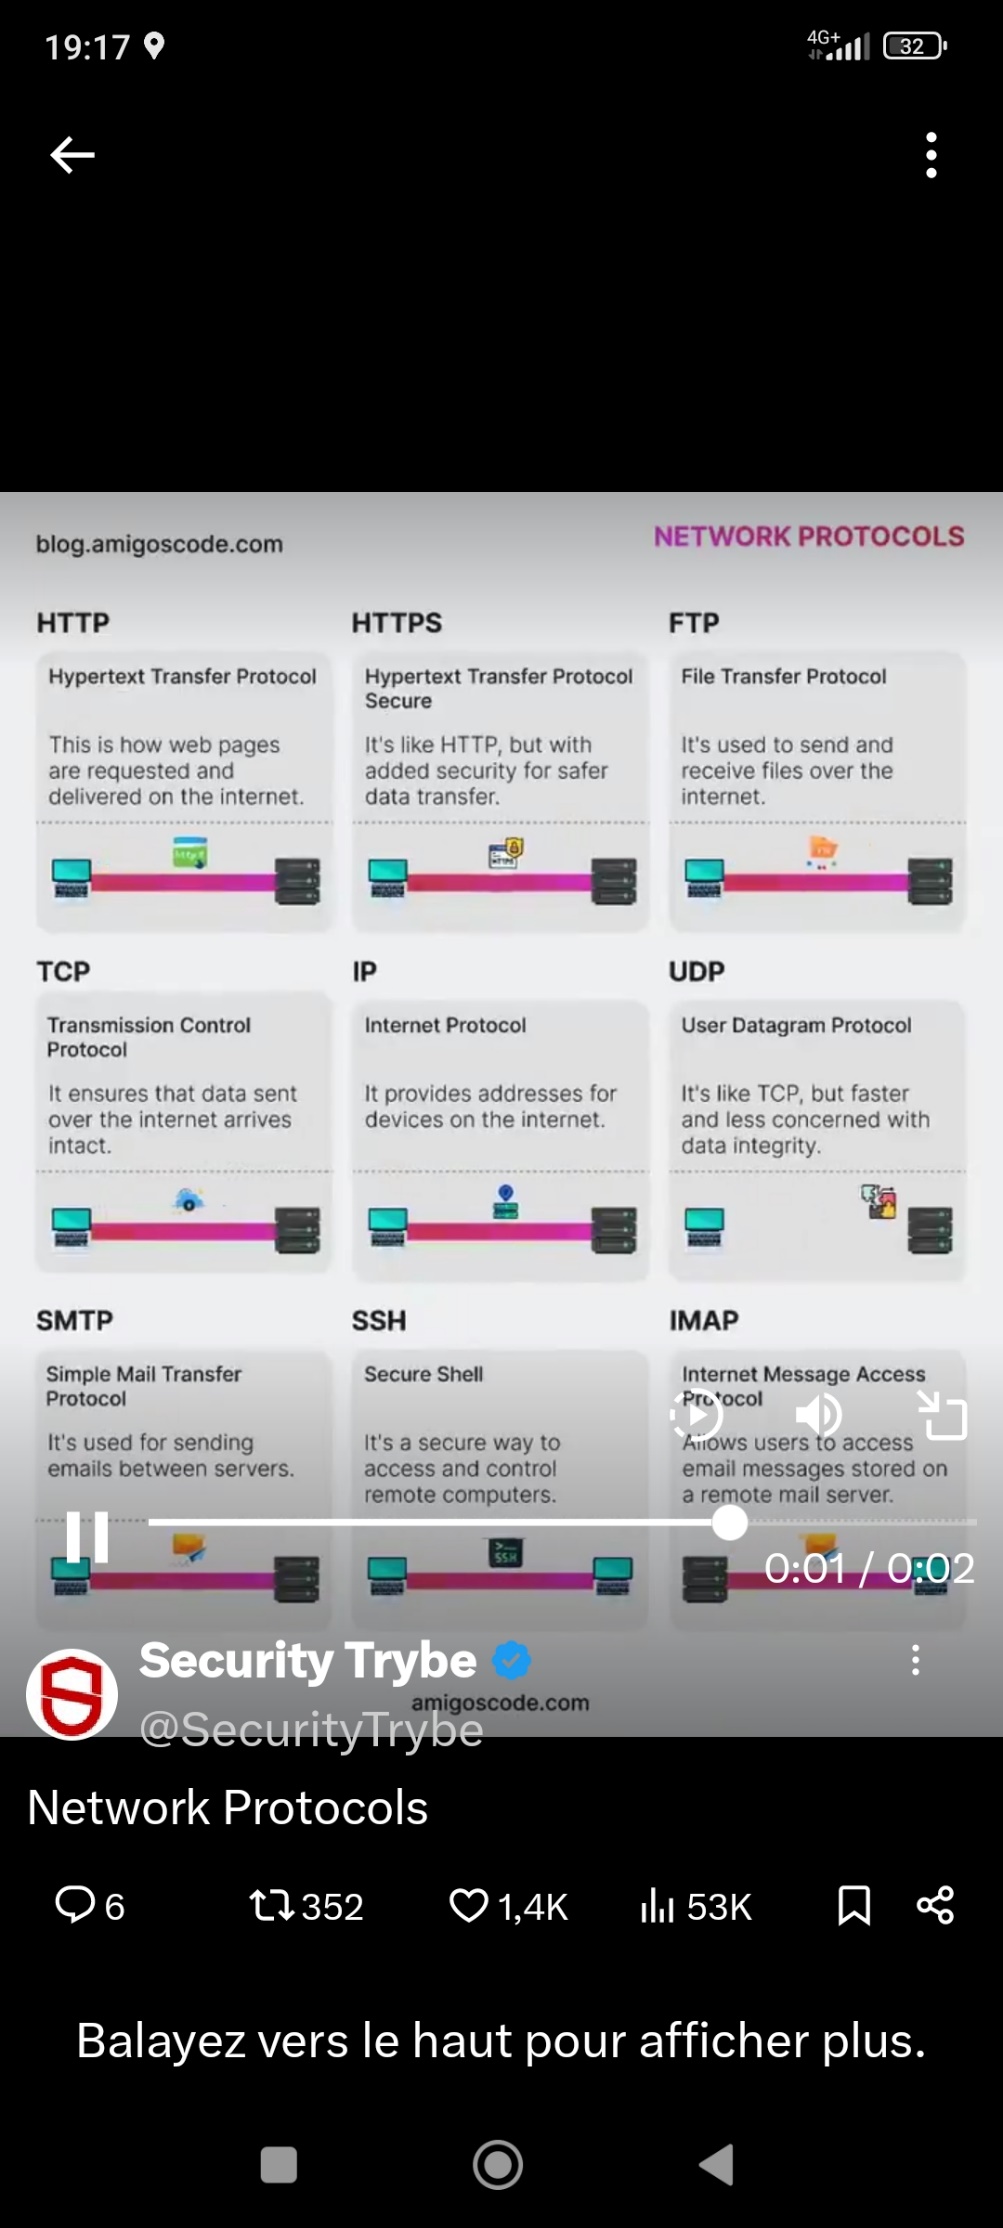
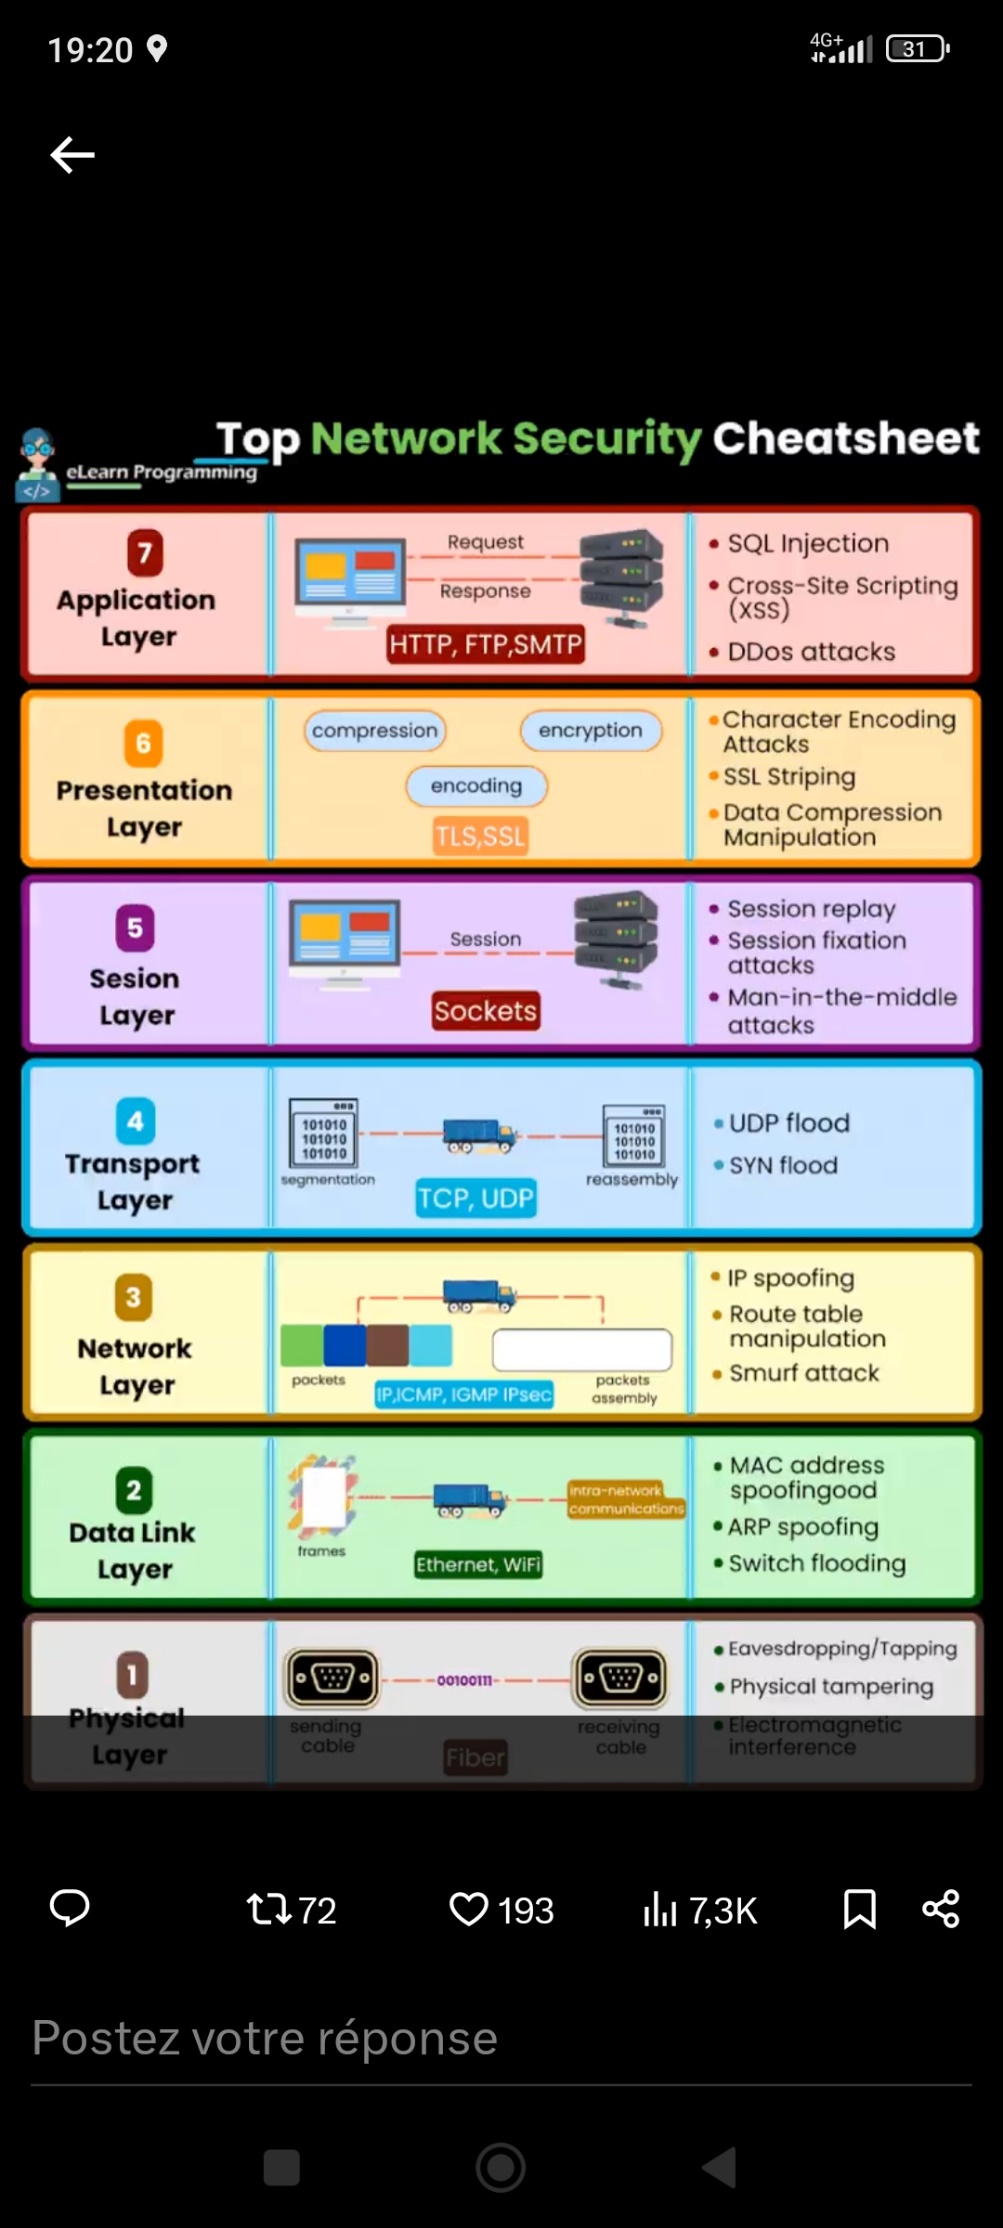
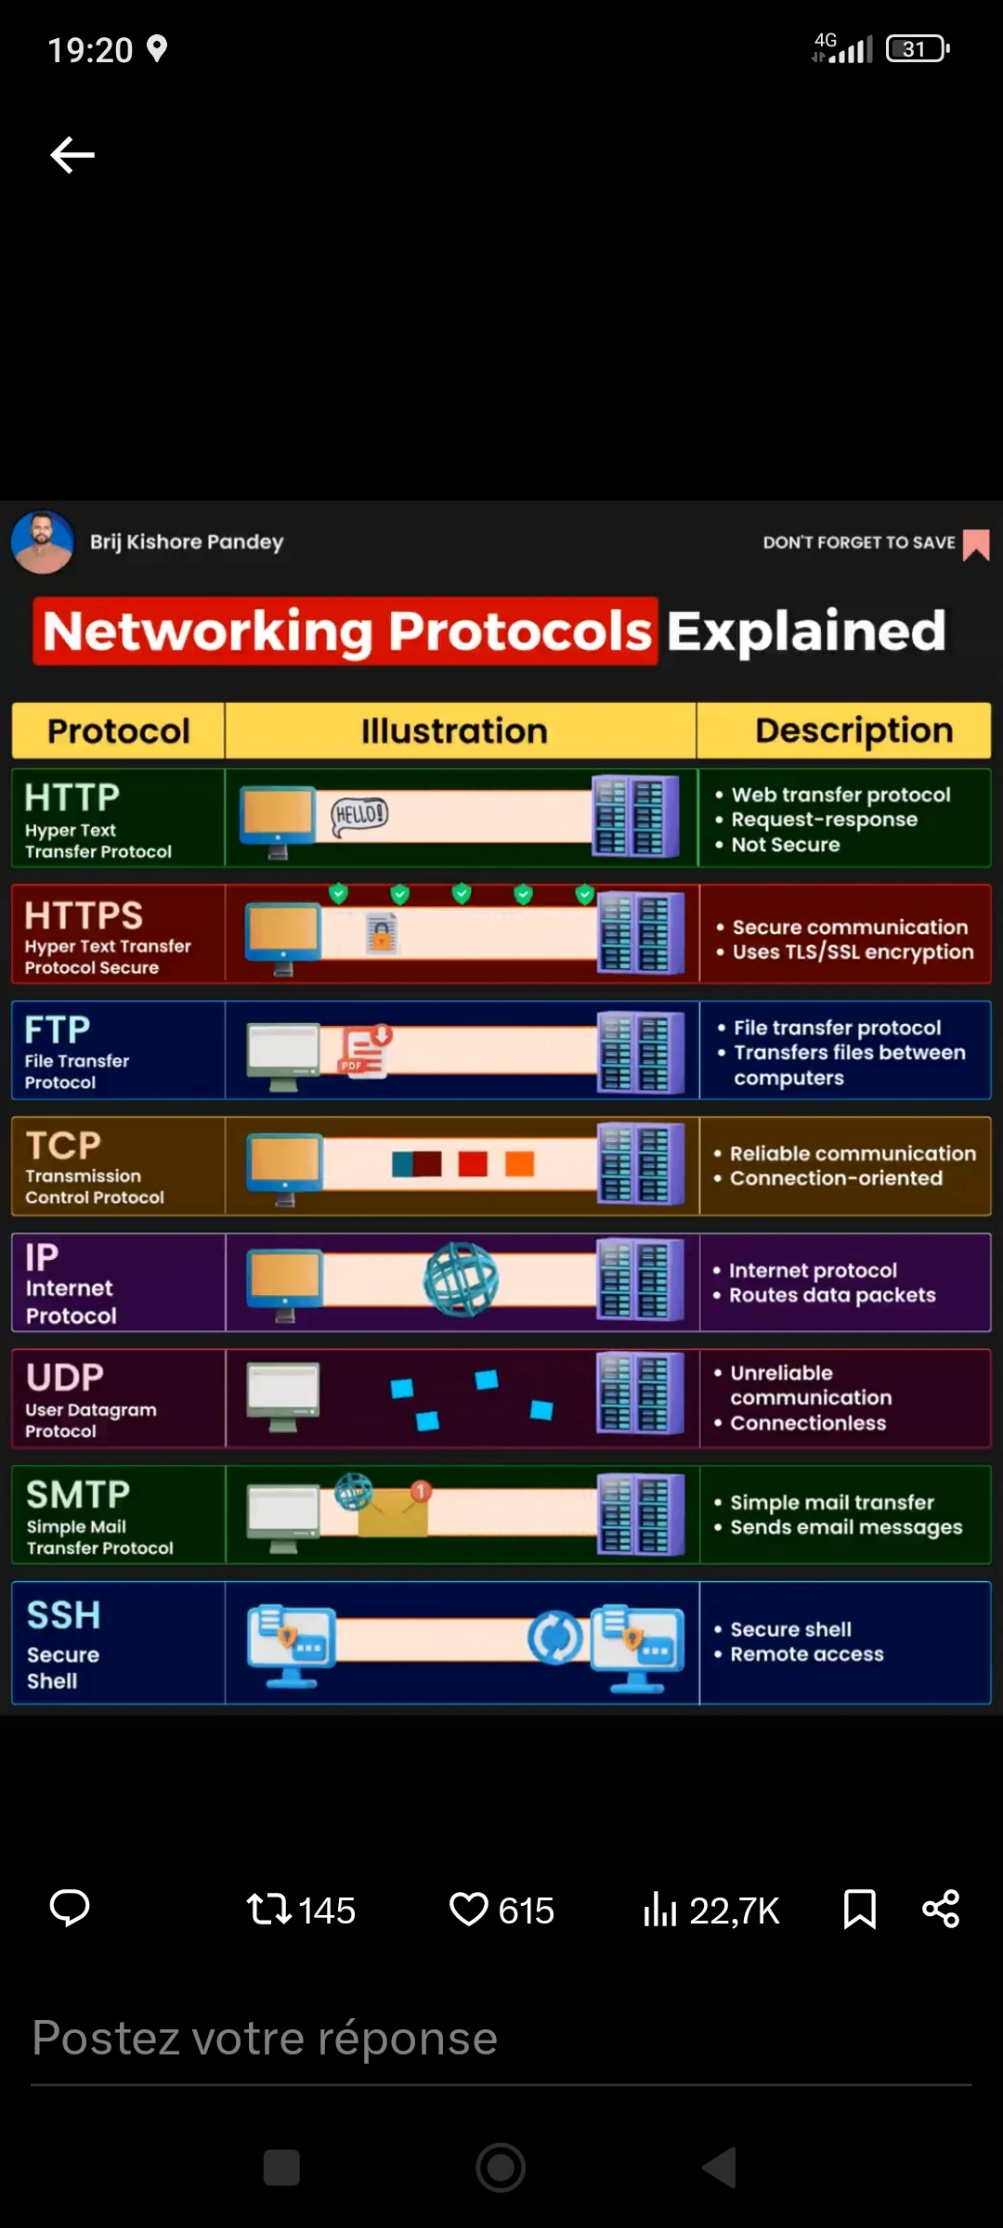
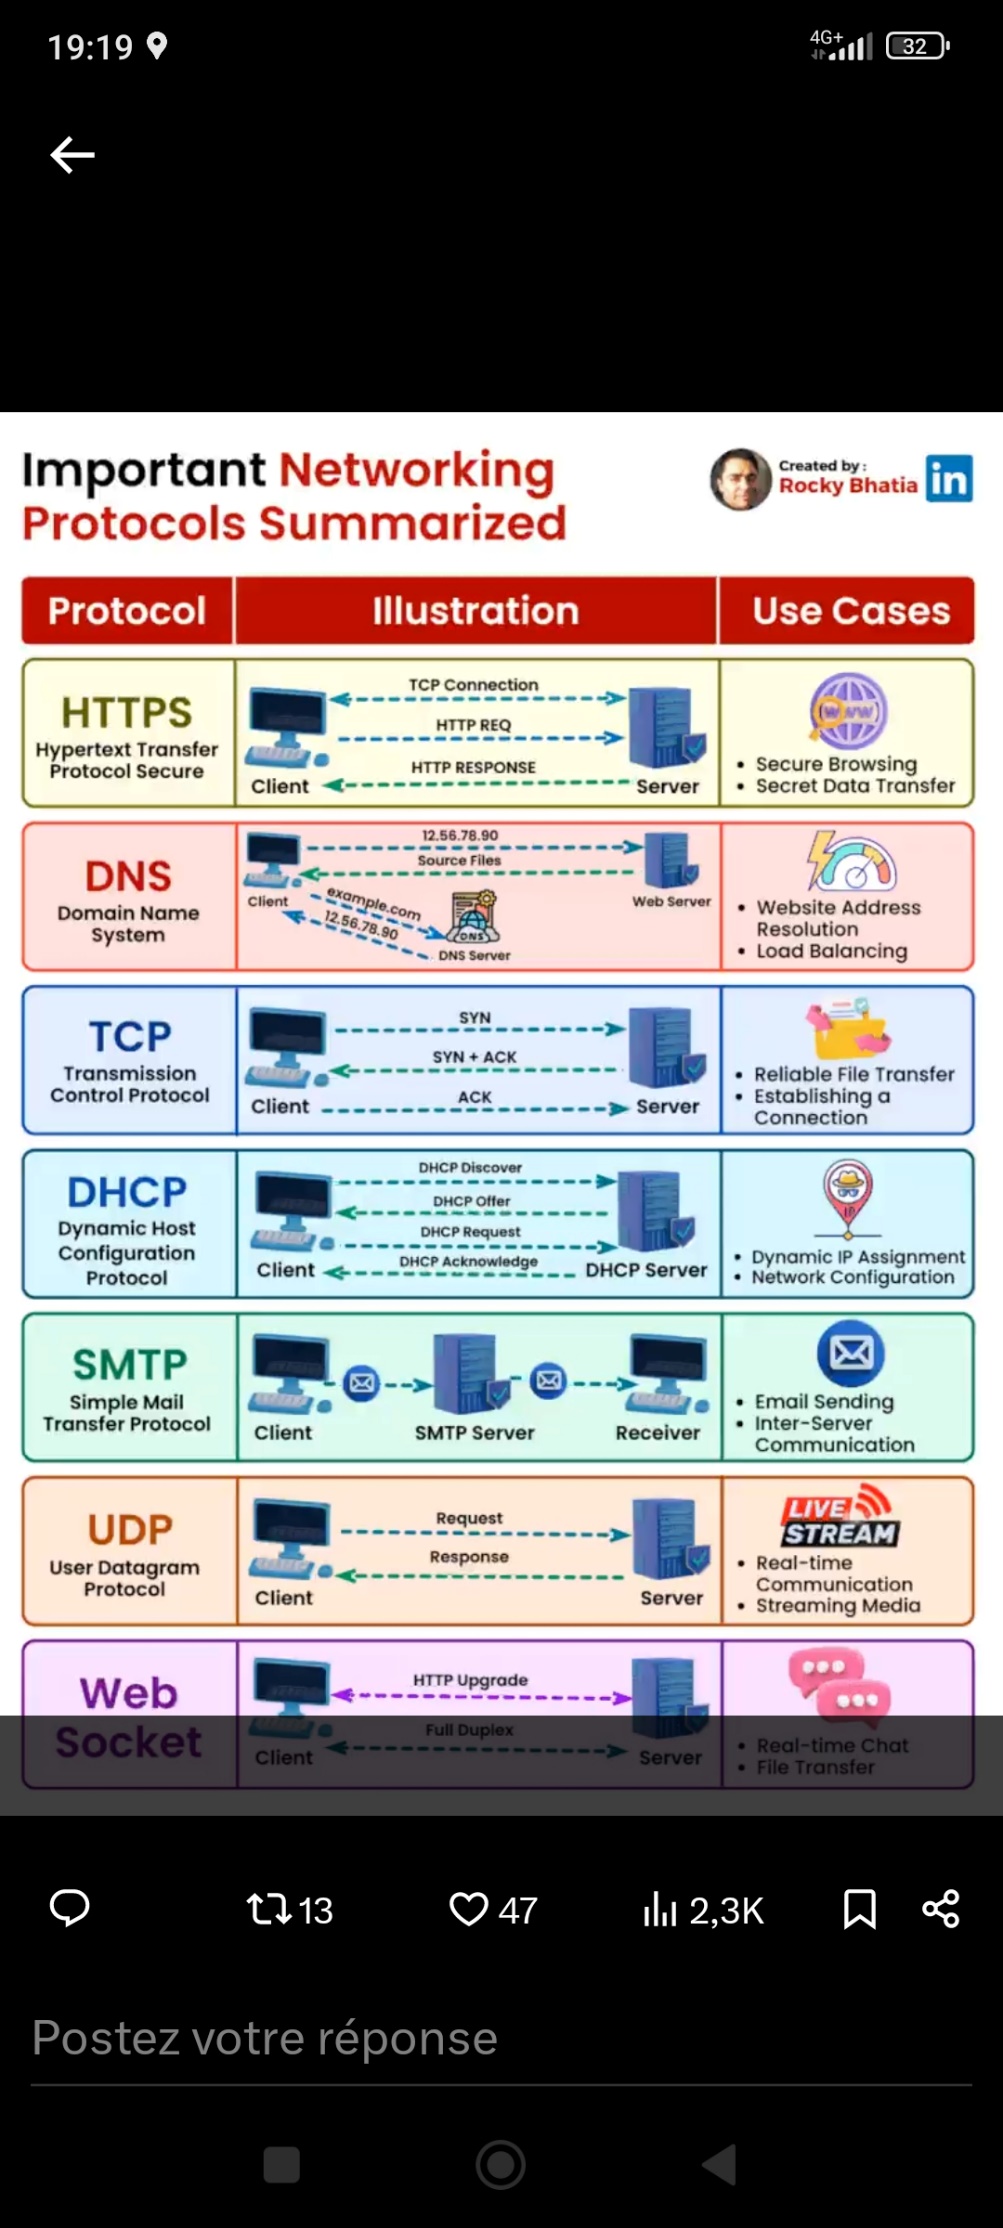
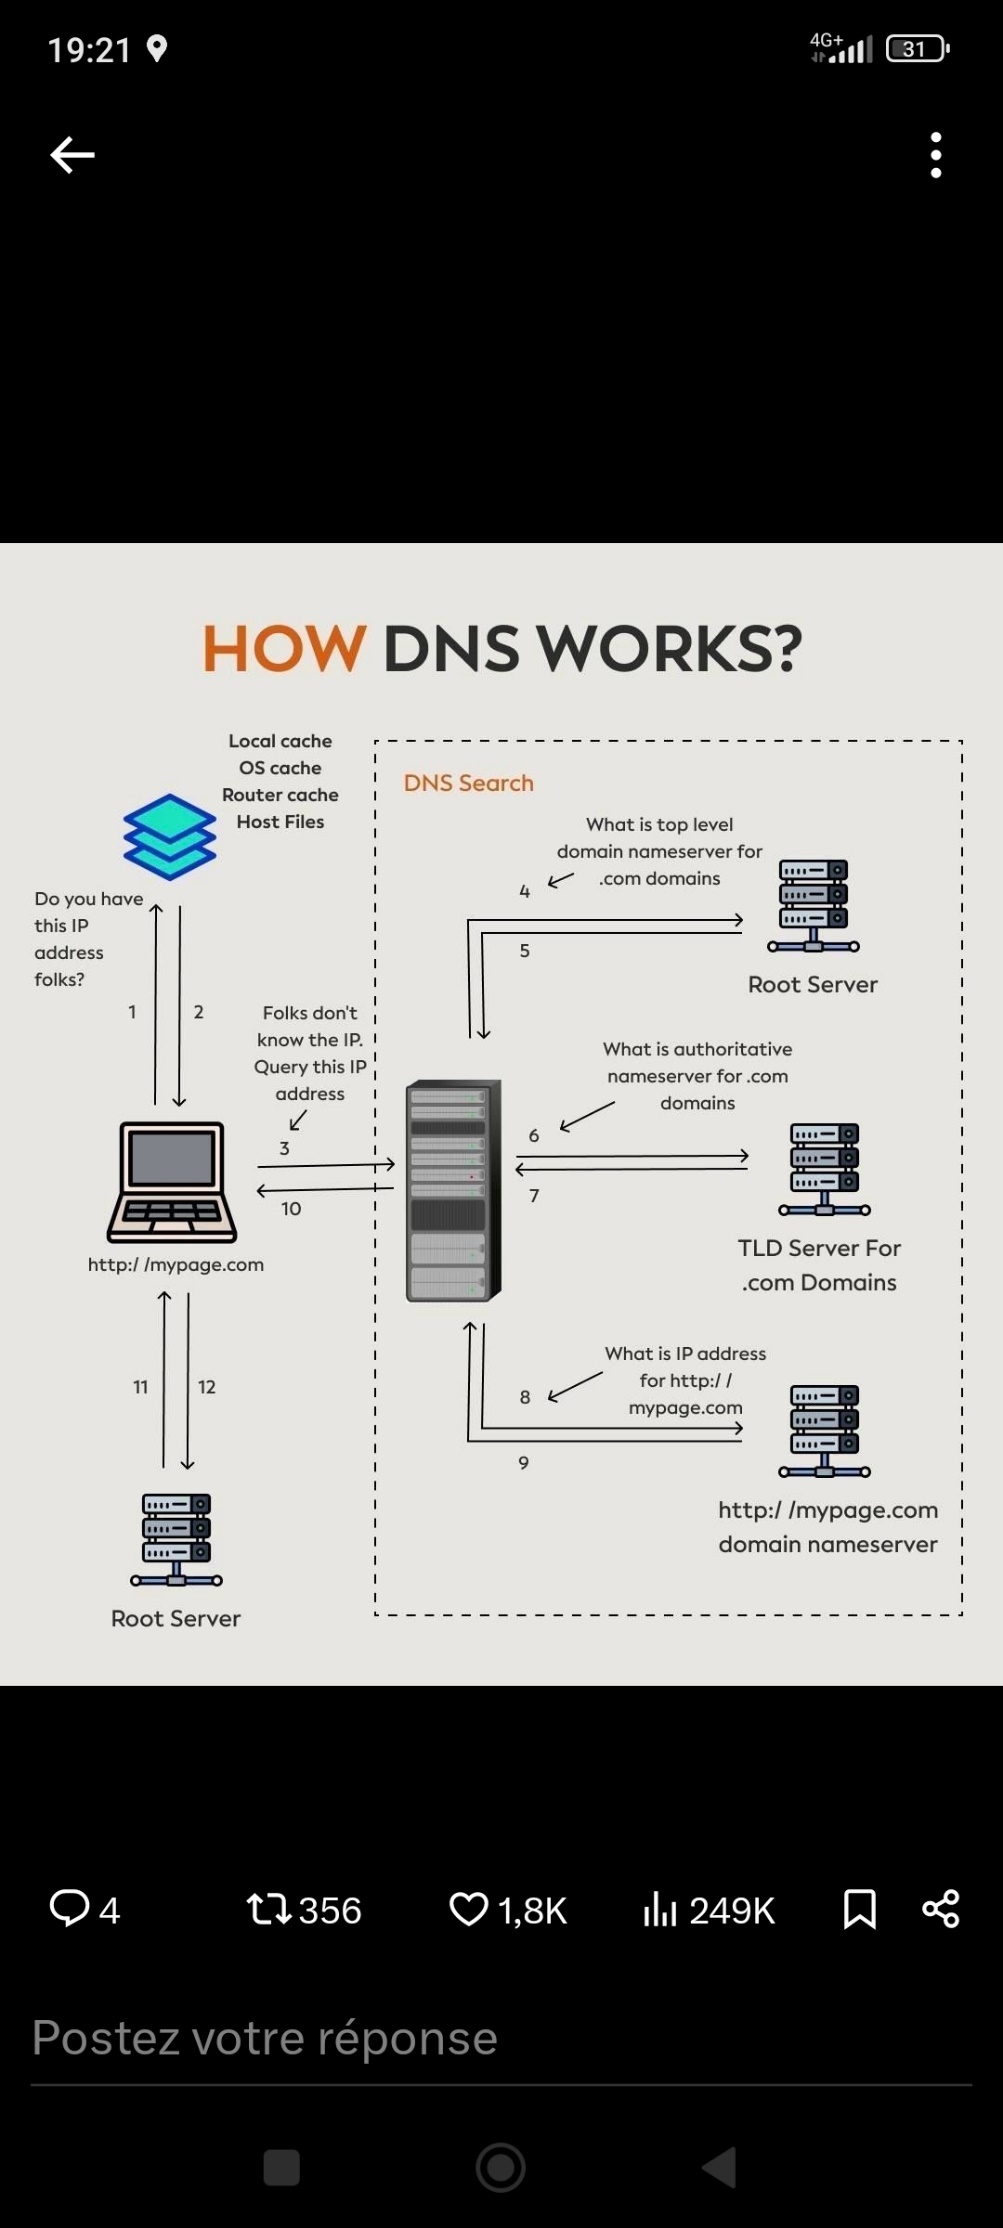
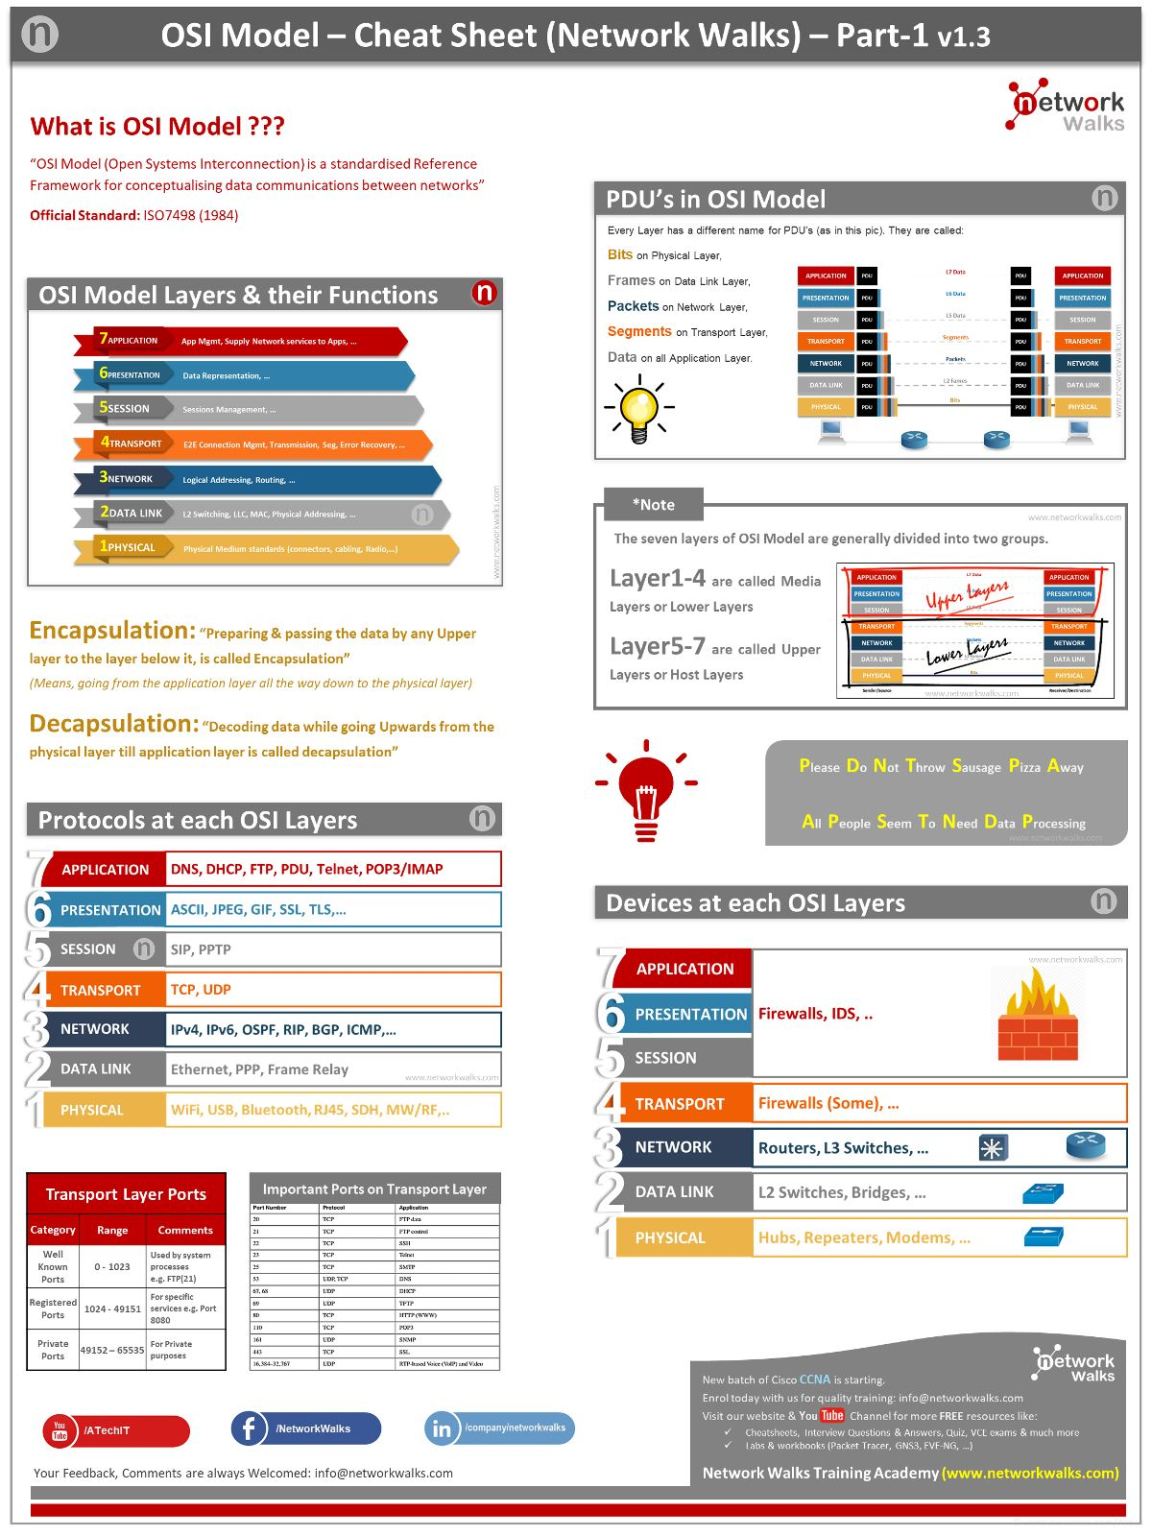
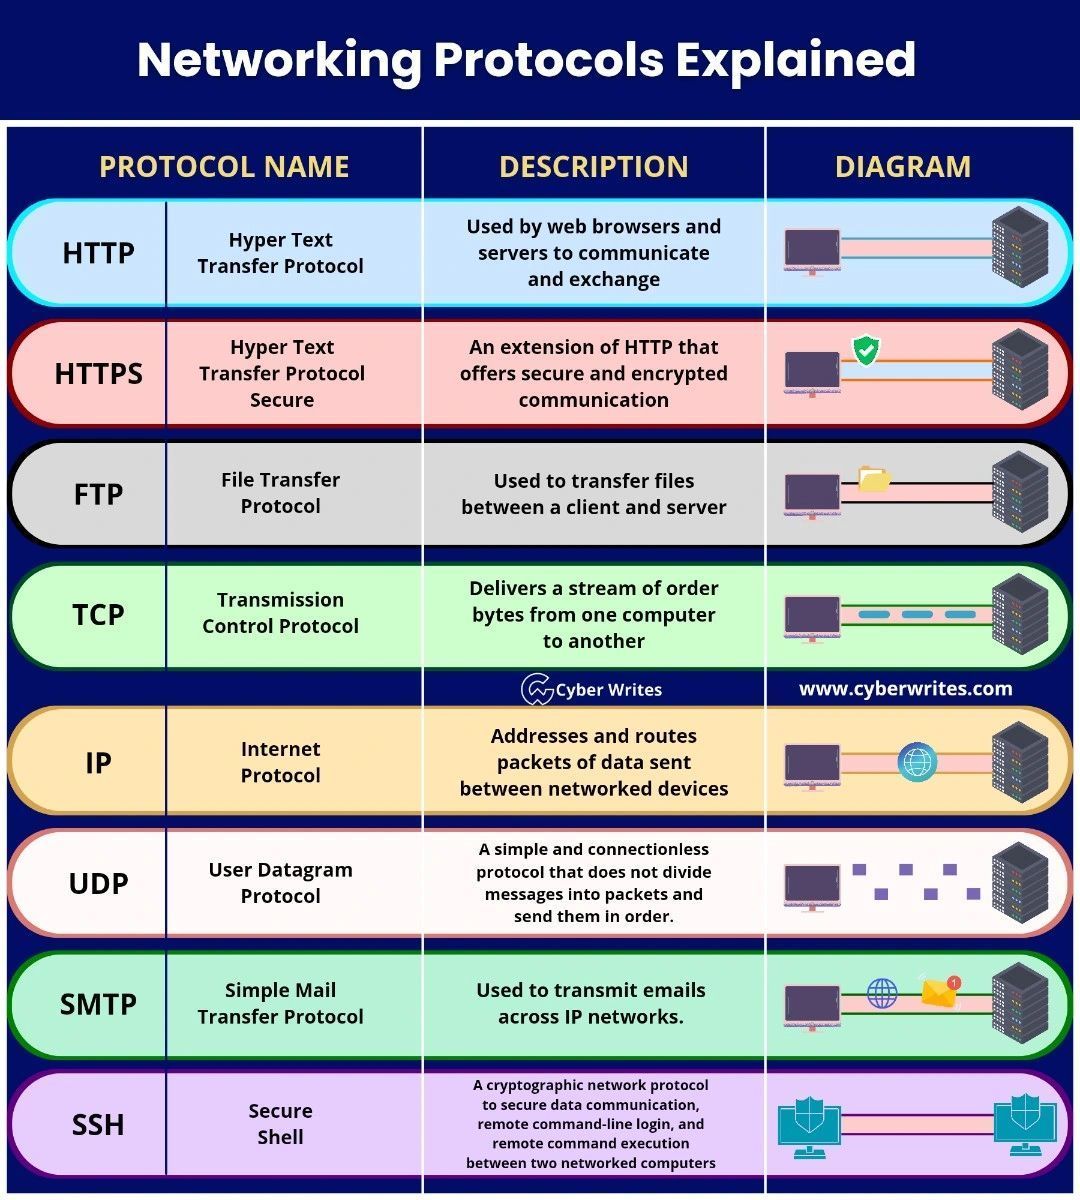
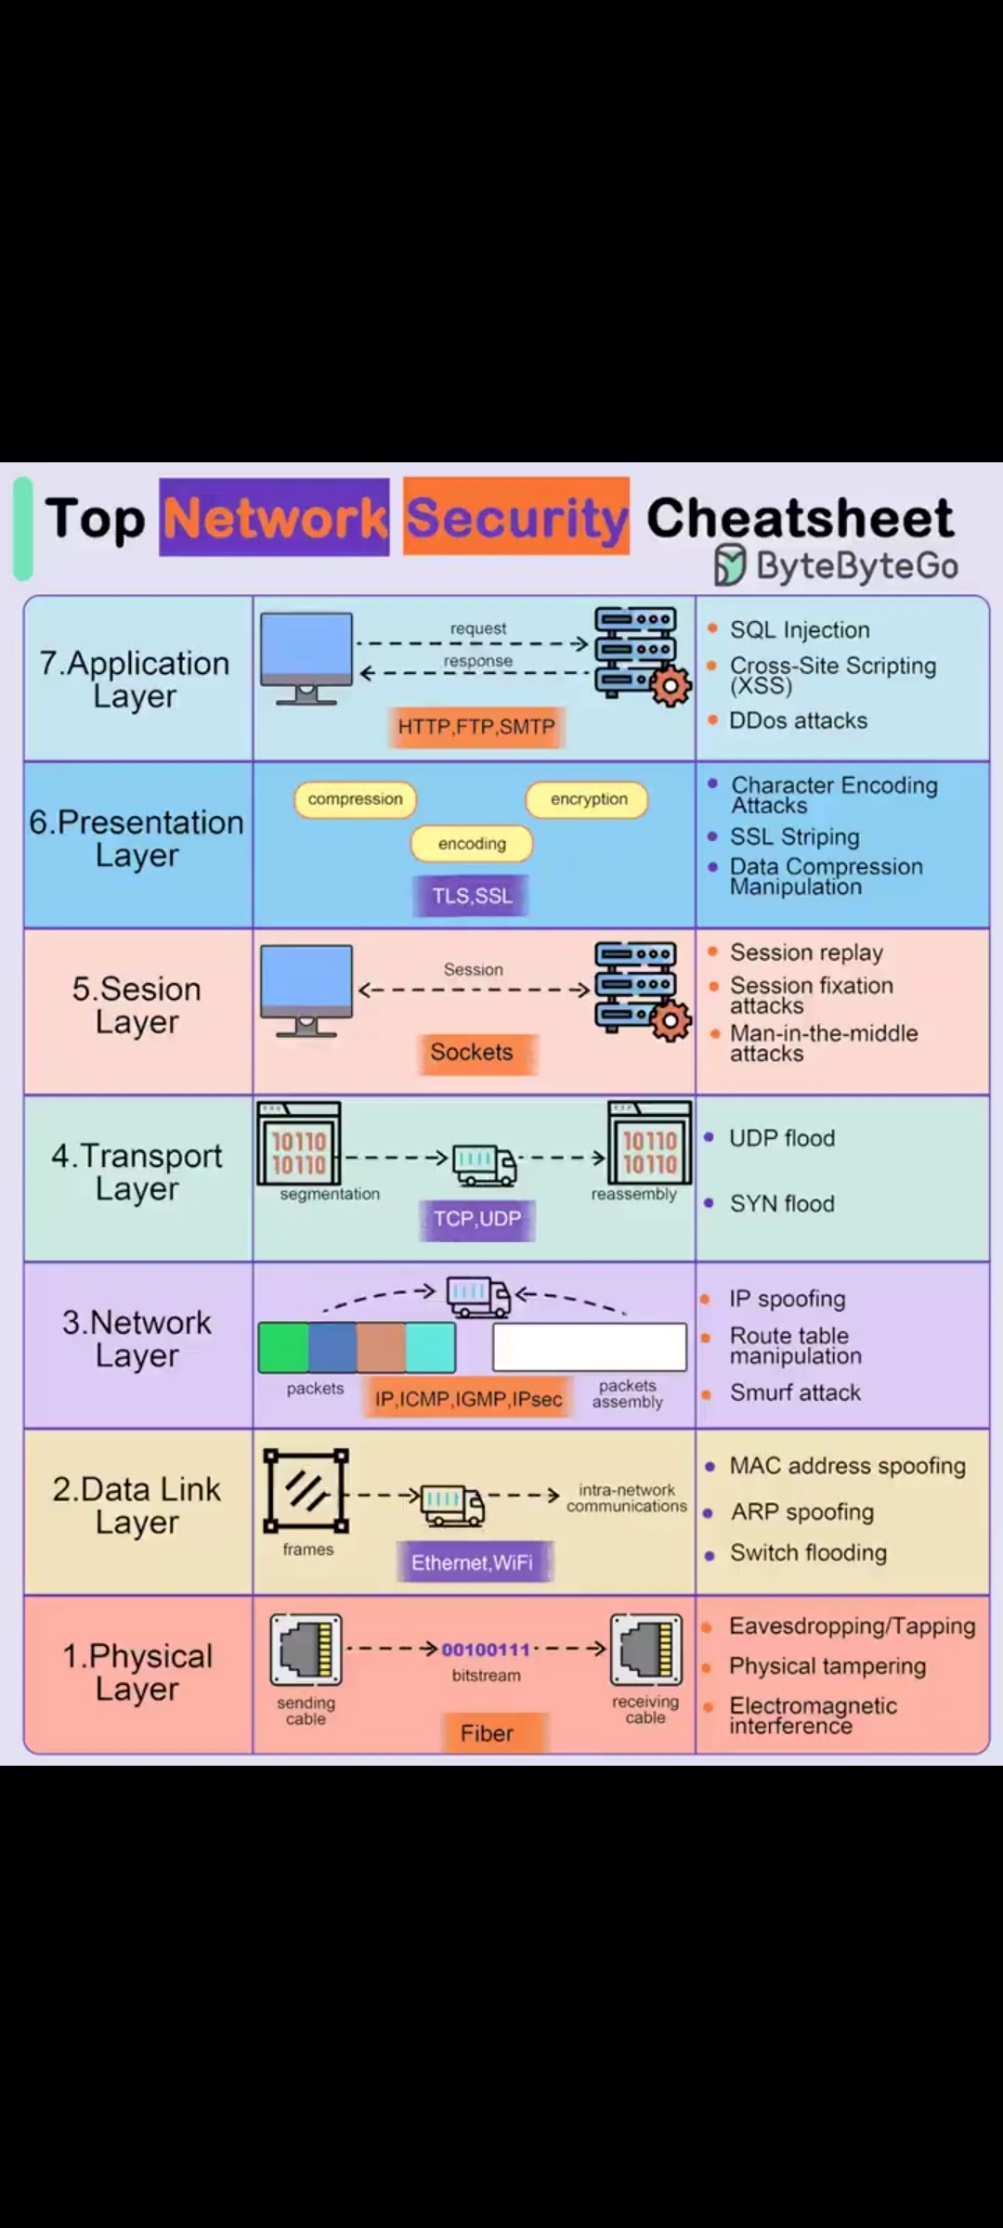
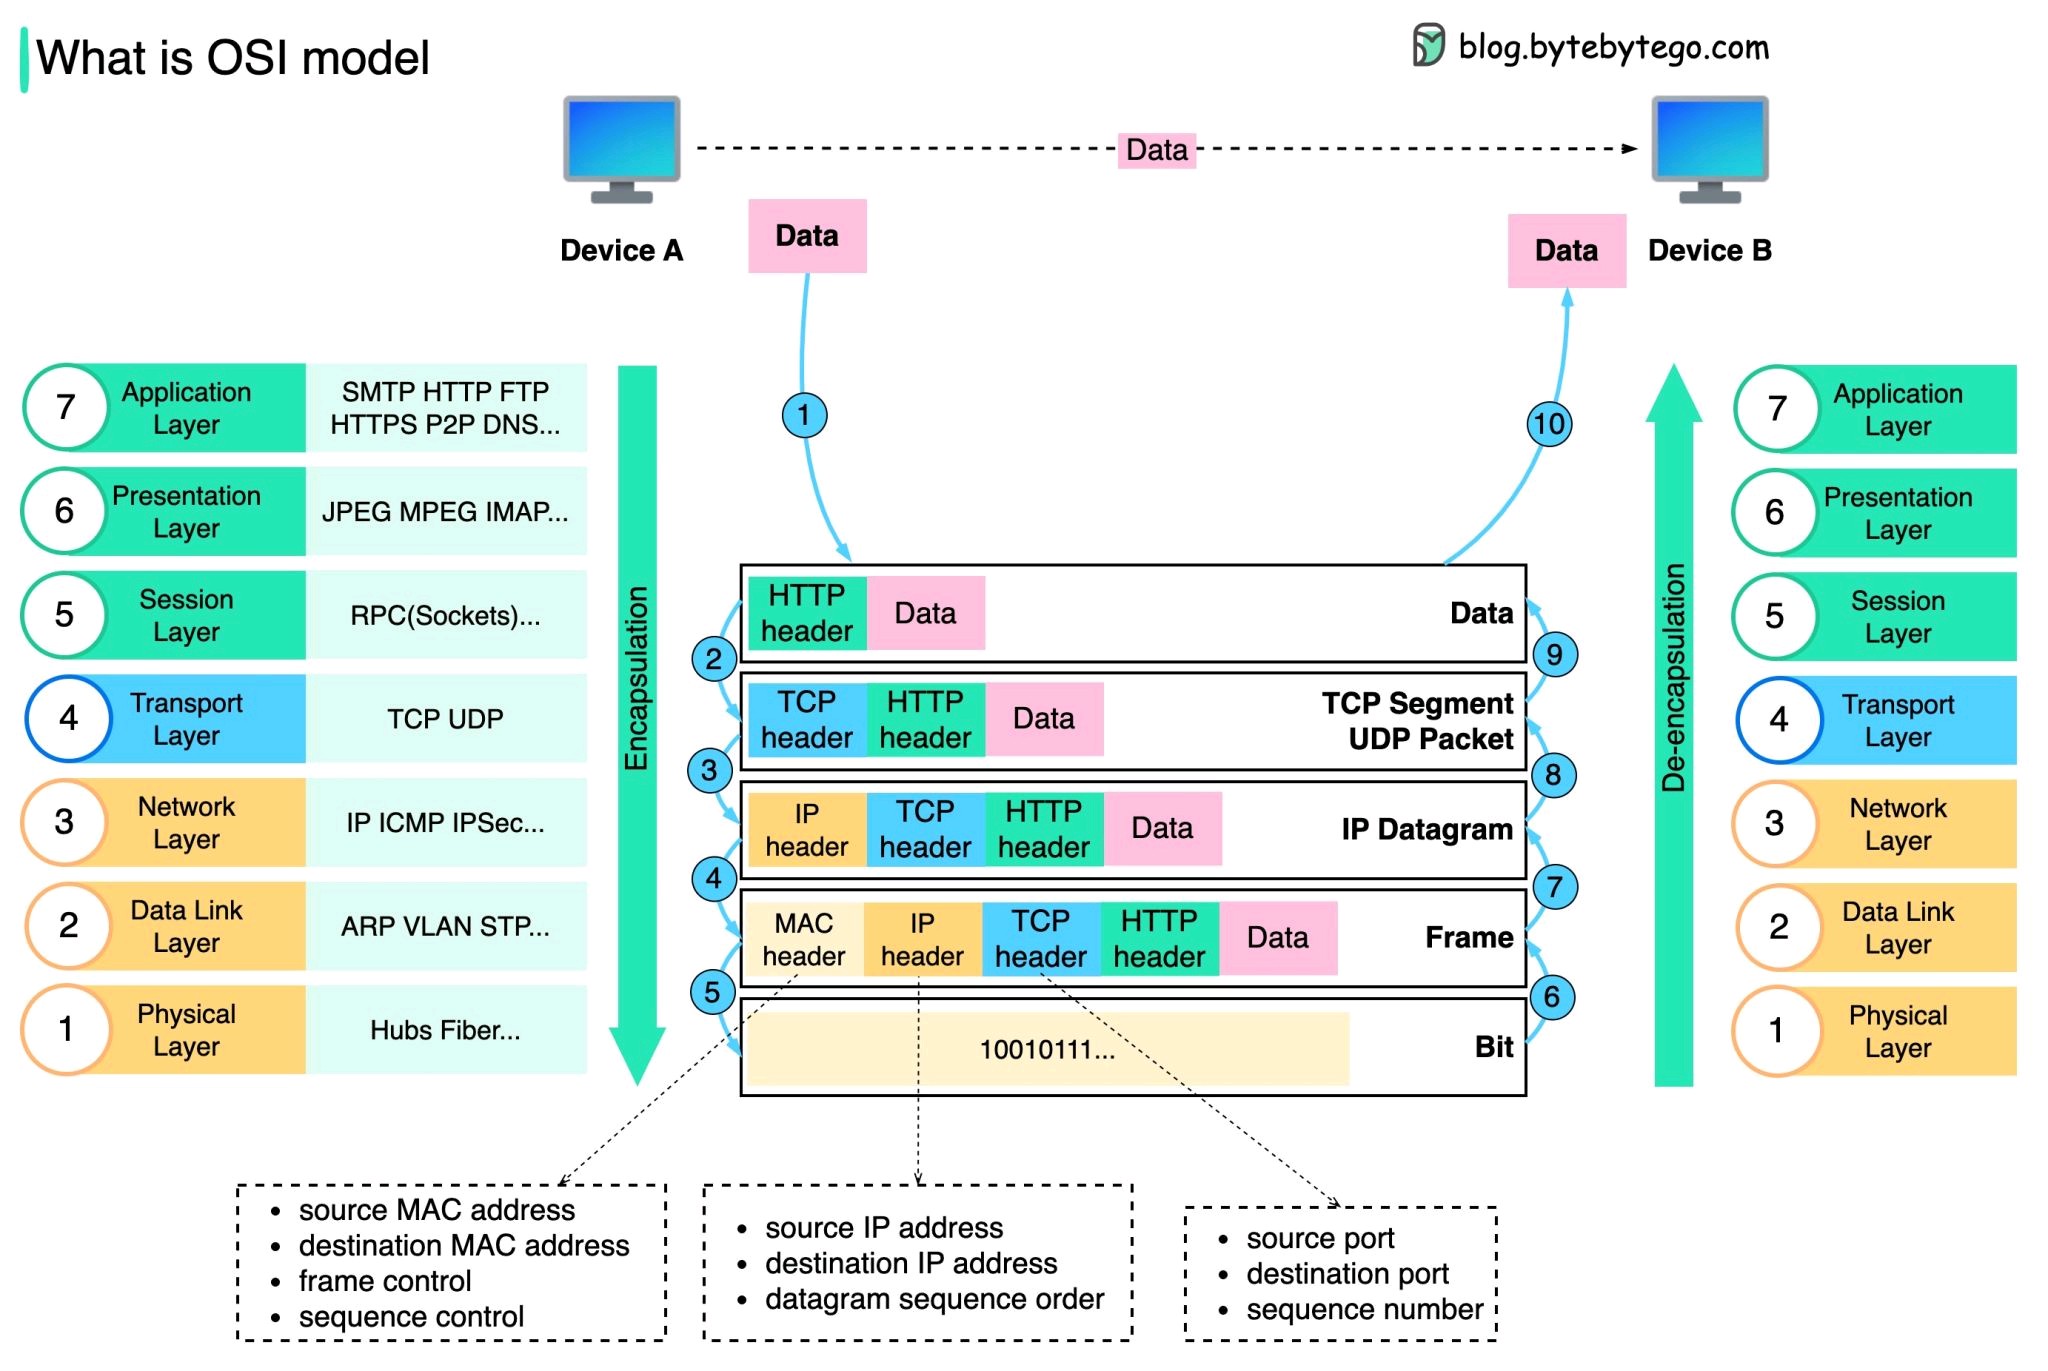
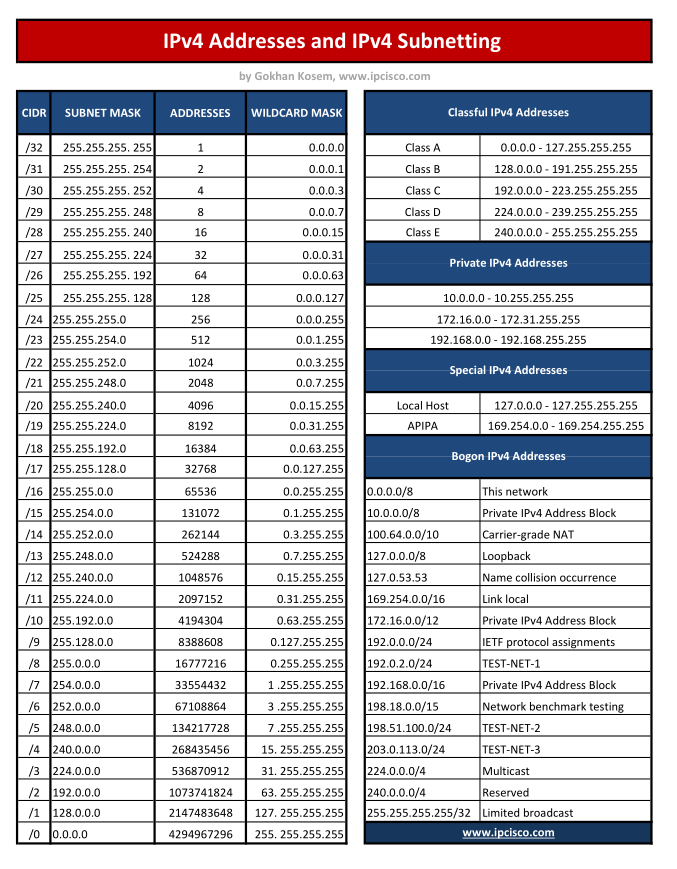
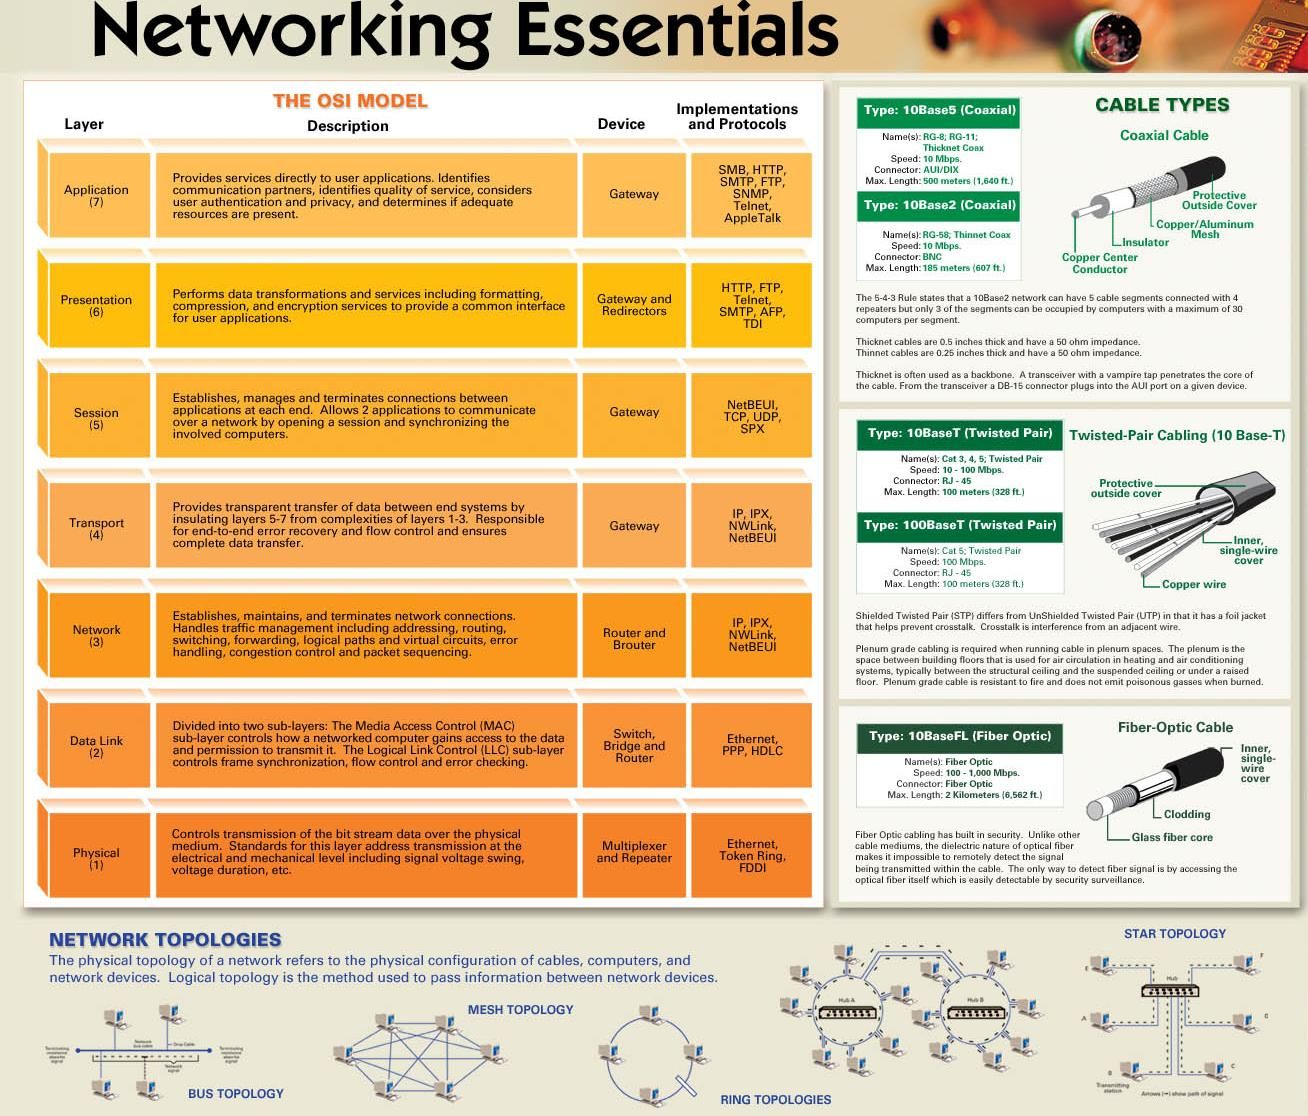
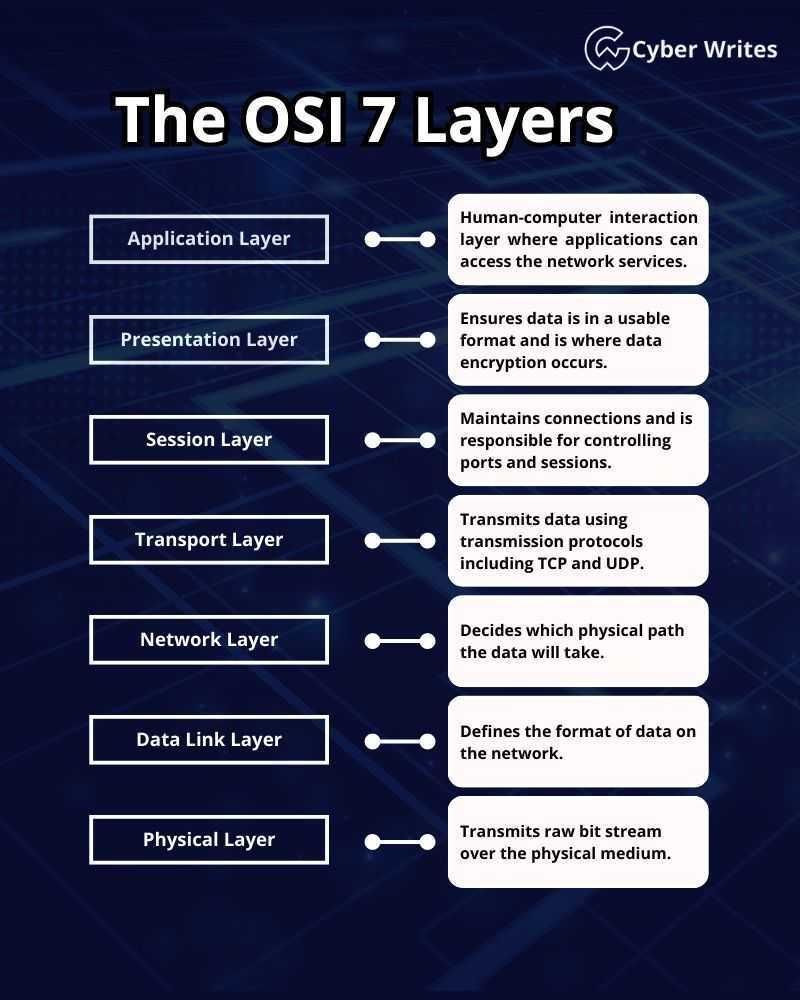
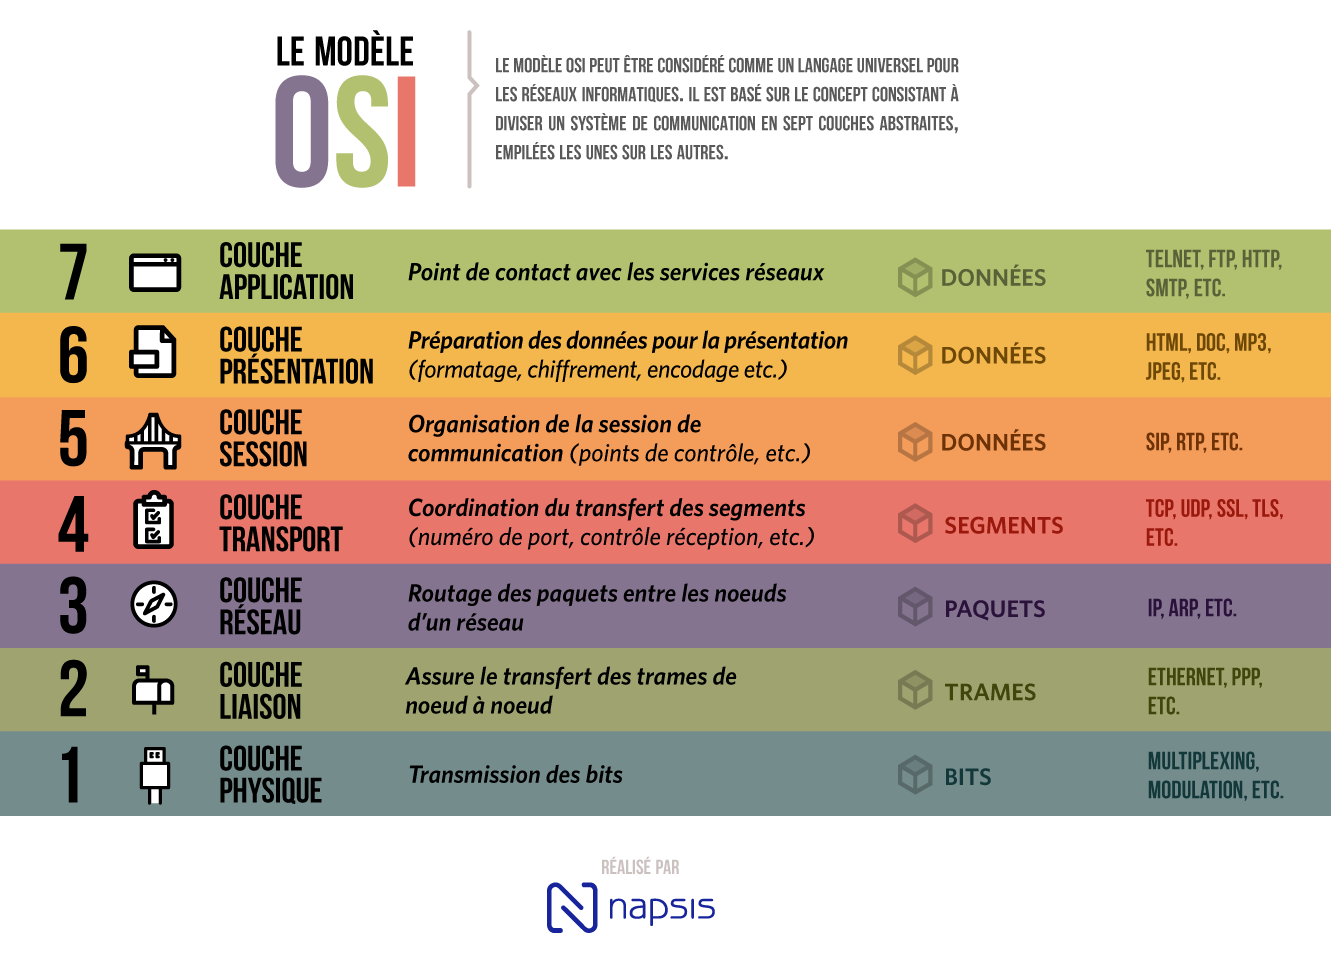
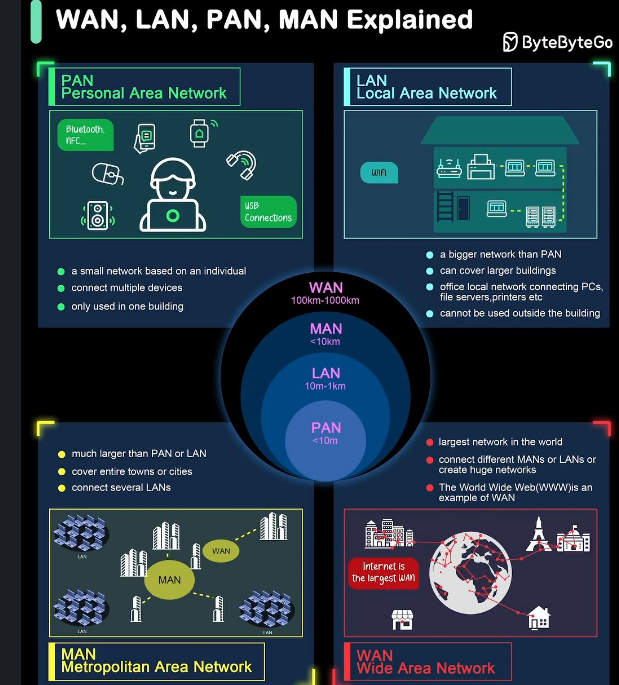
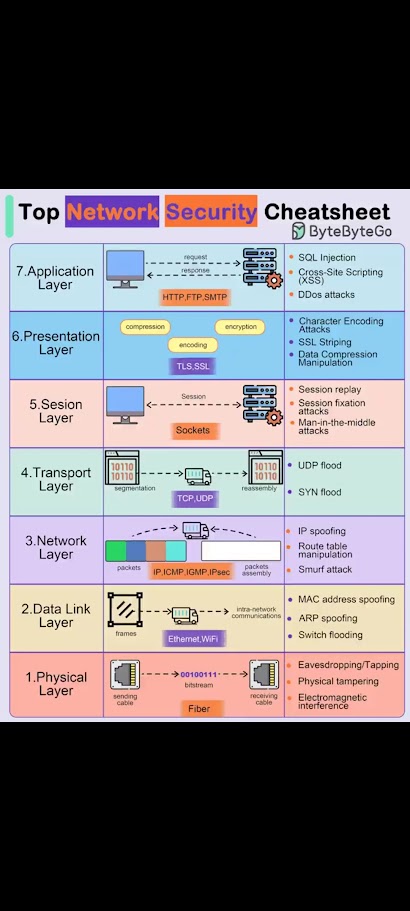
ANNEXE1
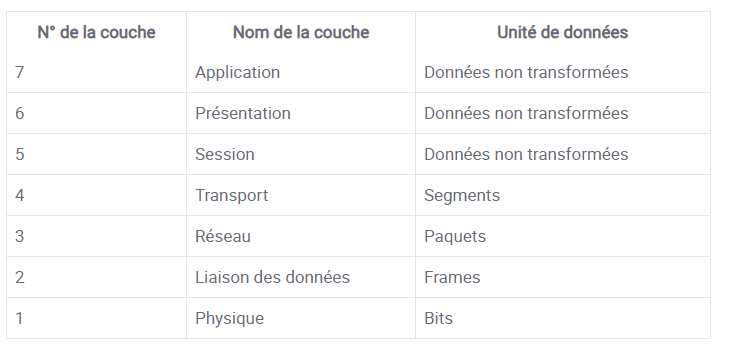
La couche application
La couche application est la couche la plus proche de l’utilisateur. La majorité des protocoles utilisés par les utilisateurs se situent dans cette couche (HTTP, SMTP, FTP, etc.).
Cette couche interagit avec les applications logicielles qui implémentent des composants de communication. La couche application est le point d’accès aux services réseau.
La couche application a généralement pour fonction d’identifier les interlocuteurs, de déterminer si les ressources sont disponibles et de synchroniser les communications.
La couche d’application en elle-même n’a aucun moyen de déterminer la disponibilité des ressources sur le réseau.
Notez que la couche application est la couche où il y a la plus grande diversité de protocoles. En effet, il n’y a pas beaucoup de méthodes fondamentalement différentes permettant d’assurer les fonctions des couches 2 à 6 et leur éventail de protocoles est donc assez réduit.
Pour la couche application, en revanche, on peut notamment utiliser les protocoles suivants (en se limitant au monde IP) :
- Les protocoles FTP (IETF), NFS (Sun Microsystems) et AFS, SMB/CIFS (Microsoft) pour le transfert de fichiers ;
- Les protocoles Simple Mail Transfer Protocol (SMTP), Post Office Protocol (POP), Internet Message Access Protocol (IMAP) pour les services de messagerie ;
- Les protocoles Telnet, rlogin, Secure Shell (SSH) pour les sessions distantes ;
- Le protocole HTTP pour le transfert de ressources hypermédia comme les documents HTML ;
- Des protocoles d’exploitation et de gestion comme Domain Name System (DNS) pour la résolution d’adresse, Simple Network Management Protocol pour la supervision.
La couche présentation
La couche présentation est chargée du formatage des données de la couche applicative afin qu’elles puissent être envoyées à travers le réseau puis être lues à nouveau par les applications.
La couche session
La couche session contrôle les connexions entre les ordinateurs. Cette couche permet l’ouverture et la fermeture de session et gère la synchronisation des échanges ainsi que les transactions.
La couche transport
La couche transport fournit les moyens concrets pour transférer des données de taille variable d’une source vers une destination en conservant la qualité du service.
L’enjeu de la couche de transport est de réceptionner les données qui viennent des couches supérieures, de les découper et de la faire transiter jusqu’à la couche réseau.
Cette couche est la première à communiquer directement avec la machine de destination : elle gère les communications de bout en bout (“end to end”) entre processus (programmes en cours d’exécution).
La couche réseau
La couche réseau fournit les moyens concrets pour transférer des données de taille variable (appelés “paquets”) entre différents réseaux de nœuds.
On va notamment effectuer le routage et l’adressage des paquets dans cette couche, c’est-à-dire qu’on va définir la route que vont emprunter les paquets pour aller d’un point de départ à un point d’arrivée (d’un interlocuteur à l’autre).
La couche liaison des données
La couche liaison des données gère les communications entre deux machines directement connectées entre elles.
On va dans cette couche découper des données brutes en frames de tailles variables puis les envoyer de manière séquentielle.
On va également dans cette couche détecter et pouvoir corriger les erreurs pouvant survenir dans la couche physique, définir le protocole pour établir et mettre fin à une connexion entre deux périphériques connectés physiquement et définir le protocole de contrôle de flux (régulation du trafic) entre eux.
La couche physique
La couche physique est chargée de la transmission des signaux entre les interlocuteurs. Son service est limité à l’émission et la réception d’un bit ou d’un train de bits continu.
La couche physique est, comme son nom l’indique, la couche dans laquelle sont définis les protocoles du monde physique (les différents câbles de transmission).
********************************************************************************
*Le modèle pratique TCP/IP et ses 4 couches
Le modèle TCP/IP (encore appelé « modèle Internet »), qui date de 1976, a été stabilisé bien avant la publication du modèle OSI en 1984.
Pour information, TCP/IP est un modèle dérivé de l’ARPANET dont le but était de maintenir les communications coûte que coûte en cas d’attaque nucléaire. Il en découle un réseau basé sur le routage de paquets à travers une couche appelée Internet.
Le modèle pratique TCP/IP et ses 4 couches
Le modèle TCP/IP (encore appelé « modèle Internet »), qui date de 1976, a été stabilisé bien avant la publication du modèle OSI en 1984.
Pour information, TCP/IP est un modèle dérivé de l’ARPANET dont le but était de maintenir les communications coûte que coûte en cas d’attaque nucléaire. Il en découle un réseau basé sur le routage de paquets à travers une couche appelée Internet.
Le modèle TCP/IP tient son nom de ses deux protocoles « majeurs » : les protocoles TCP (Transmission Control Protocol) et IP (Internet Protocol).
Il présente aussi une approche modulaire (utilisation de couches) mais en contient uniquement quatre :
- La couche application ;
- La couche transport ;
- Internet ;
- Accès réseau.
| N° de la couche | OSI | TCP/IP | Unité de données |
|---|---|---|---|
| 7 | Application | Application | Données non transformées |
| 6 | Présentation | ||
| 5 | Session | ||
| 4 | Transport | Transport | Segments |
| 3 | Réseau | Internet | Paquets |
| 2 | Liaison des données | Accès réseau | Frames |
| 1 | Physique | Bits |
La couche application
Le modèle TCP/IP regroupe les trois couches de session, présentation et application du modèle OSI dans une seule couche application. En effet, d’un point de vue pratique, cela ne fait souvent pas beaucoup de sens de séparer ces couches.
Cette couche contient tous les protocoles de haut niveau : FTP pour le transfert de fichiers, SMTP pour les mails, HTTP pour le WWW, DNS pour les noms de domaine.
La couche transport
La couche transport assure la communication logique entre processus. Cette couche détermine comment les données doivent être envoyées : de manière fiable ou pas.
Concrètement, on va pouvoir choisir entre deux protocoles dans la couche transport : TCP (Transmission Control Protocol) et UDP (User Datagram Protocol).
TCP est un protocole de transfert fiable orienté connexion. Ce protocole contrôle et s’assure qu’il n’y ait ni perte ni corruption de données. Il est donc en charge des erreurs. TCP est le protocole le plus utilisé sur le Web aujourd’hui.
UDP est un protocole de transfert non fiable et qui ne nécessite pas de connexion préalable. Ce protocole est particulièrement utilisé pour les échanges où la perte de quelques données n’est pas grave (appel vidéo, jeu en ligne, etc.) car il est plus rapide que TCP.
La couche Internet
Le but principal de la couche Internet est d’assurer la communication logique entre hôtes, c’est-à-dire de transmettre coûte que coûte les paquets d’un hôte à un autre et de faire en sorte qu’ils arrivent à destination. Le protocole principal de cette couche est IP (Internet Protocol ou Protocole Internet). Les paquets peuvent prendre différentes routes pour arriver à destination et arriver dans un ordre différent de l’ordre dans lequel ils ont été envoyés.
Dans son fonctionnement, la couche Internet n’est pas responsable d’une transmission fiable. Elle ne fournit qu’un service peu fiable et une livraison optimale (via le routage et l’adressage). Étant donné que la livraison de paquets entre divers réseaux est une opération intrinsèquement peu fiable et sujette aux pannes, la charge de la fiabilité a été placée avec les points d’extrémité d’un chemin de communication, c’est-à-dire les hôtes, plutôt que sur le réseau.
Ce sera aux protocoles de plus haut niveau d’assurer la fiabilité du service.
La couche accès réseau
La couche accès réseau du modèle TCP/IP regroupe les couches physiques et de liaison des données du modèle OSI. Cette couche définit comment envoyer des paquets IP à travers le réseau (via des protocoles comme Ethernet ou Wireless entre autres)
Comment se passe un échange de données en pratique ?
Pour bien comprendre l’ensemble des notions décrites ci-dessus, il me semble essentiel de visualiser comment se passe un échange de données de manière pratique. Pour cela, prenons l’exemple d’un utilisateur qui souhaite accéder à une page web.
Pour cela, les premiers protocoles utilisés vont être HTTP ou HTTPS (HTTP + le protocole de chiffrement TLS). HTTP va nous permettre d’envoyer une demande (requête) au serveur. En l’occurrence, la requête sera « renvoie-moi le document HTML demandé ».
A ce niveau, d’autres protocoles vont être utilisés comme DNS (pour trouver le serveur où se situe le document), etc. Le protocole HTTP permet de créer une requête HTTP. Cette requête (ces données) va devoir être transportée à travers les réseaux.
Pour cela, on va déjà devoir utiliser un protocole de transport comme TCP par exemple. Celui-ci va garantir l’intégrité des données et la transmission entre processus. À ce niveau, dans la couche de transport, les données venant de différents processus sont transformées en segments.
Chaque segment contient la donnée originale à laquelle est accolée un en-tête de transport. Cet en-tête contient les numéros de ports de la source et de la destination afin que les données puissent être transmises de manière effective.
Ces segments sont ensuite transmis aux protocoles de la couche Internet. Le rôle de cette couche est de choisir la route la plus rapide à travers le réseau pour que les données arrivent à destination. Les segments sont alors transformés en paquets. Cette couche se charge également de l’adressage des données en ajoutant un en-tête aux paquets qui contient l’adresse IP de destination et celle de départ.
Les paquets sont ensuite à nouveau transformés en frames dans la couche d’accès réseau. A ce niveau, on ajoute un en-tête contenant les adresses MAC (Media Access Control – adresses qui permettent d’identifier tout périphérique de manière unique) source et de destination.
Dans cette même couche, les informations sont finalement transformées en bits (0 et 1 qui correspondent au langage de la machine) et ces bits sont envoyés dans le réseau (les 0 et les 1 sont encodées dans les câbles en utilisant des transmissions électriques ou des impulsions lumineuses dans le cas de la fibre).
Dès que ces bits arrivent à destination, les opérations se déroulent dans le sens inverse : les bits sont reformés en frames, puis en paquets, en segments et enfin les données de base sont reconstituées.
Dans le cas d’une demande de page Internet, le serveur reçoit donc la requête originale et renvoie une réponse. Les mêmes opérations sont à nouveau effectuées avec transformation des données pour qu’elles puissent transiter puis reconstitution du côté du client.
Vous pouvez noter qu’on appelle la phase de transformation de l’information en bits l’encapsulation tandis que la phase inverse de reconstitution des données s’appelle la décapsulation.
TCP, le Protocole de Contrôle de Transmission
Transmission Control Protocol (TCP ou protocole de contrôle de transmissions) est un protocole de transport fiable en mode connecté.
TCP est utilisé approximativement pour 95 % de tout le trafic Internet. Les applications les plus courantes qui utilisent TCP sont HTTP/HTTPS (World Wide Web), SMTP/POP3/IMAP (messagerie) et FTP (transfert de fichiers).
Le mode connecté est l’établissement d’une session de communication entre deux parties qui veulent échanger des données. Cette session comporte un début, une fin et une validation (vérification des erreurs), classiquement un identifiant un mot de passe. Elle correspond à la couche de session du modèle OSI (située entre les couches « présentation » et « transport »).
Dans le modèle Internet, aussi appelé modèle TCP/IP, TCP est situé au-dessus de IP. Dans le modèle OSI, il correspond à la couche transport, intermédiaire entre la couche réseau et la couche session. Les applications transmettent des flux de données sur une connexion réseau. TCP découpe le flux d’octets en segments dont la taille dépend de la MTU (Unité de Transmission Maximale) de la couche de liaison de données.
Une session TCP fonctionne en trois phases :
- l’établissement de la connexion ;
- les transferts de données ;
- la fin de la connexion.
La connexion TCP : le three way handshake
Selon le protocole de communication TCP, une connexion entre deux hôtes s’établit en trois étapes : c’est le three-way handshake. Pendant la phase d’établissement de la connexion, des paramètres comme le numéro de séquence sont initialisés afin d’assurer la transmission fiable (sans perte et dans l’ordre) des données.
En informatique, en télécommunications et dans les domaines associés, le handshaking (ou handshake ; en français, établissement d’une liaison1) est un processus automatisé de négociation qui établit les paramètres d’une communication entre deux entités avant que la communication commence.
Comme son nom l’indique, le three-way handshake se déroule en trois étapes :
- SYN : Le client qui désire établir une connexion avec un serveur va envoyer un premier paquet SYN (« synchronized ») au serveur. Le numéro de séquence de ce paquet est un nombre aléatoire A.
- SYN-ACK : Le serveur va répondre au client à l’aide d’un paquet SYN-ACK (« synchronize, acknowledge »). Le numéro du ACK est égal au numéro de séquence du paquet précédent (SYN) incrémenté de un (A + 1) tandis que le numéro de séquence du paquet SYN-ACK est un nombre aléatoire B.
- ACK : Pour terminer, le client va envoyer un paquet ACK au serveur qui va servir d’accusé de réception. Le numéro de séquence de ce paquet est défini selon la valeur de l’acquittement reçu précédemment (par exemple : A + 1) et le numéro du ACK est égal au numéro de séquence du paquet précédent (SYN-ACK) incrémenté de un (B + 1).
Le transfert de données
Pendant la phase de transferts de données, certains mécanismes clefs permettent d’assurer la robustesse et la fiabilité de TCP. En particulier, les numéros de séquence sont utilisés afin d’ordonner les segments TCP reçus et de détecter les données perdues, les sommes de contrôle permettent la détection d’erreurs, et les acquittements ainsi que les temporisations permettent la détection des segments perdus ou retardés.
La somme de contrôle ou checksum en anglais, parfois appelée « empreinte », est un nombre qu’on ajoute à un message à transmettre pour permettre au récepteur de vérifier que le message reçu est bien celui qui a été envoyé.
Grâce aux numéros de séquence et d’acquittement, les systèmes terminaux peuvent remettre les données reçues dans l’ordre à l’application destinataire.
Les numéros de séquence sont utilisés pour décompter les données dans le flux d’octets. On trouve toujours deux de ces nombres dans chaque segment TCP, qui sont le numéro de séquence et le numéro d’acquittement. Le numéro de séquence représente le propre numéro de séquence de l’émetteur TCP, tandis que le numéro d’acquittement représente le numéro de séquence du destinataire. Afin d’assurer la fiabilité de TCP, le destinataire doit acquitter les segments reçus en indiquant qu’il a reçu toutes les données du flux d’octets jusqu’à un certain numéro de séquence.
Une somme de contrôle sur 16 bits, constituée par le complément à un de la somme complémentée à un de tous les éléments d’un segment TCP (en-tête et données), est calculée par l’émetteur, et incluse dans le segment émis. Le destinataire recalcule la somme de contrôle du segment reçu, et si elle correspond à la somme de contrôle reçue, on considère que le segment a été reçu intact et sans erreur.
La perte d’un segment est gérée par TCP en utilisant un mécanisme de temporisation et de retransmission. Après l’envoi d’un segment, TCP va attendre un certain temps la réception du ACK correspondant. Un temps trop court entraîne un grand nombre de retransmissions inutiles et un temps trop long ralentit la réaction en cas de perte d’un segment.
Dans les faits, le délai avant retransmission doit être supérieur au RTT (round trip time) moyen d’un segment, c’est-à-dire au temps que prend un segment pour effectuer l’aller-retour entre le client et le serveur. Comme cette valeur peut varier dans le temps, on « prélève » des échantillons à intervalle régulier et on en calcule une moyenne pondérée
Chaque partenaire dans une connexion TCP dispose d’un tampon de réception dont la taille n’est pas illimitée. Afin d’éviter qu’un hôte ne surcharge l’autre, TCP prévoit plusieurs mécanismes de contrôle de flux. Ainsi, chaque segment TCP contient la taille disponible dans le tampon de réception de l’hôte qui l’a envoyé. En réponse, l’hôte distant va limiter la taille de la fenêtre d’envoi afin de ne pas le surcharger.
Fermeture de la connexion
La phase de terminaison d’une connexion utilise un handshaking en quatre temps, chaque extrémité de la connexion effectuant sa terminaison de manière indépendante. Ainsi, la fin d’une connexion nécessite une paire de segments FIN et ACK pour chaque extrémité.
Ports TCP
Le numéro de port est utilisé par TCP (et par UDP) pour identifier les applications, c’est-à-dire pour distinguer les différents interlocuteurs. À chaque extrémité (client/serveur) de la connexion TCP est associé un numéro de port sur 16 bits (de 1 à 65535) assigné à l’application émettrice ou réceptrice. Ces ports sont classés en trois catégories :
- Les ports bien connus, assignés par l’IANA (Internet Assigned Numbers Authority) dans la plage 0-1023 et qui sont souvent utilisés par des applications bien connues qui fonctionnent en tant que serveur et sont en attente de connexions comme FTP (port 21), SSH (port 22), Telnet (23), SMTP (25), HTTP (80), POP3 (110) ;
- Les ports enregistrés généralement utilisés par des applications utilisateur comme ports sources éphémères pour se connecter à un serveur, mais qui peuvent également identifier des services non enregistrés par l’IANA ;
- Les ports dynamiques/privés qui peuvent aussi être utilisés par des applications utilisateur, mais plus rarement. Ils n’ont pas de sens en dehors d’une connexion TCP particulière.
IP, le Protocole Internet
Internet protocol (protocole internet, abrégé en IP) est une famille de protocoles de communication de réseaux informatiques conçus pour être utilisés sur Internet. Les protocoles IP sont au niveau 3 dans le modèle OSI. Les protocoles IP s’intègrent dans la suite des protocoles Internet et permettent un service d’adressage unique pour l’ensemble des terminaux connectés.
Le protocole Internet (IP) est un ensemble d’exigences pour l’adressage et le routage des données sur Internet. IP peut être utilisé avec plusieurs protocoles de transport, notamment TCP et UDP.
L’adressage IP
Lors d’une communication entre deux postes, le flux de données provenant de la couche transport — niveau 4 du modèle OSI — (par exemple des segments TCP) est encapsulé dans des paquets par le protocole IP lors de leur passage au niveau de la couche réseau. Ces paquets sont ensuite transmis à la couche liaison de données — niveau 2 du modèle OSI — afin d’y être encapsulés dans des trames (par exemple Ethernet).
Les données traversant Internet sont divisées en morceaux plus petits, appelés paquets. Des informations IP sont attachées à chaque paquet, et ces informations aident les routeurs à envoyer des paquets au bon endroit. Chaque appareil ou domaine qui se connecte à Internet se voit attribuer une adresse IP et, comme les paquets sont dirigés vers l’adresse IP qui leur est attachée, les données arrivent là où elles sont nécessaires.
Les paquets IP sont créés en ajoutant un en-tête IP à chaque paquet de données avant son envoi. Un en-tête IP n’est qu’une série de bits (un et zéro) qui enregistre plusieurs informations sur le paquet, y compris l’adresse IP d’envoi et de réception. Les en-têtes IP indiquent également:
- Longueur de l’en-tête ;
- Longueur du paquet ;
- Time To Live (TTL), ou le nombre de sauts de réseau qu’un paquet peut faire avant qu’il ne soit jeté ;
- Quel protocole de transport est utilisé (TCP, UDP, etc.).
Au total, il existe 14 champs d’informations dans les en-têtes IPv4, bien que l’un d’entre eux soit facultatif.
Une adresse IP est un identifiant unique attribué à un appareil ou un domaine qui se connecte à Internet. Chaque adresse IP est une série de caractères, tels que «192.168.1.1». Grâce aux résolveurs DNS, qui traduisent les noms de domaine lisibles par l’homme en adresses IP, les utilisateurs peuvent accéder à des sites Web sans mémoriser cette série complexe de caractères.
Chaque paquet IP contiendra à la fois l’adresse IP de l’appareil ou du domaine envoyant le paquet et l’adresse IP du destinataire prévu, de la même façon que l’adresse de destination et l’adresse de retour sont incluses dans une pièce de courrier ou dans un email.
Le routage IP
Avec l’adressage, le routage est l’une des principales fonctions du protocole IP. Le routage consiste à transmettre des paquets IP de la source aux machines de destination sur un réseau, en fonction de leurs adresses IP. Cette transmission se produit généralement via un routeur.
Les protocoles IP assurent l’acheminement au mieux (best-effort delivery) des paquets. Ils ne se préoccupent pas du contenu des paquets, mais fournissent une méthode pour les mener à destination.
Les protocoles IP sont considérés comme « non fiables ». Cela ne signifie pas qu’ils n’envoient pas correctement les données sur le réseau, mais qu’ils n’offrent aucune garantie pour les paquets envoyés quant à :
- la corruption de données ;
- l’ordre d’arrivée des paquets (un paquet A peut être envoyé avant un paquet B, mais le paquet B peut arriver avant le paquet A) ;
- la perte ou destruction de paquets ;
- la duplication des paquets.
En termes de fiabilité, le seul service offert par un protocole IP est de s’assurer que les en-têtes de paquets transmis ne comportent pas d’erreurs grâce à l’utilisation de somme de contrôle (checksum). Si l’en-tête d’un paquet comprend une erreur, sa somme de contrôle ne sera pas valide et le paquet sera détruit sans être transmis.
Les versions IP : IPv4 et IPv6
IPv4 utilise des adresses codées sur 32 bits (soit en théorie 4 294 967 296 adresses possibles) tandis qu’IPv6 les code sur 128 bits (soit en théorie 3,4 × 1038 adresses possibles).
Le premier champ d’un paquet d’un protocole IP est composé de 4 bits qui indiquent la version du protocole utilisé. La valeur 0100 (4 en binaire) est utilisée pour IPv4, 0110 (6 en binaire) pour IPv6.
Les versions 1 à 3 du protocole sont restées expérimentales. Elles ont été utilisées entre 1977 et 1979.
La version 4 du protocole est une version qui a été très largement utilisée. Le nombre 4 est le numéro de version du protocole porté par les datagrammes IP qui l’utilisent. IPv4 est défini dans la RFC RFC 7919 de 1981.
La version 5 du protocole est une version expérimentale utilisée dans le cadre de l’étude de l’Internet Stream Protocol, protocole lui-même expérimental.
Le successeur officiel du protocole IPv4 est IPv6. Ce protocole est le résultat de plusieurs années d’expérimentation et d’échanges au cours desquels plusieurs protocoles ont été proposés (TP/IX, PIP, TUBA…).
LINUX
Naviguer dans le système de fichiers (cd)
Lorsque vous vous connectez au système et que vous atteignez l’invite de commande du shell, vous êtes généralement placé dans votre répertoire personnel.
Sous Windows, les lecteurs physiques installés sur l’ordinateur déterminent le chemin d’accès. Linux stocke les fichiers dans une structure de répertoire unique, appelée répertoire virtuel. Le répertoire virtuel contient les chemins de fichiers de tous les périphériques de stockage installés sur l’ordinateur, fusionnés dans une structure de répertoire unique.
La structure du répertoire virtuel de Linux contient un seul répertoire de base, appelé la racine. Les répertoires et les fichiers situés sous le répertoire racine sont répertoriés en fonction du chemin d’accès utilisé pour les atteindre, de la même manière que sous Windows.
Linux utilise une barre oblique (/) au lieu d’une barre oblique inverse (\) pour désigner les répertoires dans les chemins de fichiers. Le caractère barre oblique inverse sous Linux désigne un caractère d’échappement.
Sous Linux, vous verrez des chemins de fichiers de ce type :
/home/ofp/Documents/test.doc
Cela indique que le fichier test.doc se trouve dans le répertoire Documents, sous le répertoire ofp, qui est contenu dans le répertoire home. Notez que le chemin ne fournit aucune information sur le disque physique sur lequel le fichier est stocké.
La structure du système de fichiers Linux a évolué à l’origine à partir de la structure de fichiers Unix. Dans un système de fichiers Linux, les noms de répertoire communs sont utilisés pour les fonctions communes.
- / : racine du répertoire virtuel, où normalement, aucun fichier n’est placé
- /bin : répertoire binaire, où de nombreux utilitaires de niveau utilisateur GNU sont stockés
- /boot : répertoire de démarrage, où les fichiers de démarrage sont stockés
- /dev : répertoire de périphérique, où Linux crée des nœuds de périphérique
- /etc : répertoire des fichiers de configuration du système
- /home : répertoire personnel, où Linux crée des répertoires utilisateur
- /lib : répertoire de la bibliothèque, où sont stockés les fichiers de bibliothèque système et d’application
- /media : répertoire multimédia, un emplacement commun pour les points de montage utilisés pour les supports amovibles
- /mnt : répertoire de montage, un autre emplacement commun pour les points de montage utilisés pour les supports amovibles
- /opt : répertoire facultatif, souvent utilisé pour stocker des progiciels tiers et des fichiers de données
- /proc : répertoire de processus, où sont stockées les informations actuelles sur le matériel et les processus
- /root : répertoire personnel du root.
- /sbin : répertoire binaire du système, où de nombreux utilitaires de niveau administrateur GNU sont stockés
- /run : répertoire d’exécution, où les données d’exécution sont conservées pendant le fonctionnement du système
- /srv : répertoire de service, où les services locaux stockent leurs fichiers
- /sys : répertoire système, où les fichiers d’informations sur le matériel système sont stockés
- /tmp : répertoire temporaire, où les fichiers de travail temporaires peuvent être créés et détruits
- /usr : répertoire binaire de l’utilisateur, où se trouvent la majeure partie des utilitaires et des fichiers de données de niveau utilisateur GNU stocké
- /var : répertoire variable, pour les fichiers qui changent fréquemment, tels que les fichiers journaux
Parcourir les répertoires
Vous utilisez la commande Change Directory (cd) pour déplacer votre session shell vers un autre répertoire du système de fichiers Linux.
La syntaxe de la commande cd est assez simple : cd destination
La commande cd peut prendre un seul paramètre, destination, qui spécifie le nom du répertoire auquel vous souhaitez accéder. Si vous ne spécifiez pas de destination sur la commande cd, cela vous amène à votre répertoire personnel.
Le paramètre de destination peut être exprimé à l’aide d’une référence de répertoire absolue ou d’une référence de répertoire relative.
RÉFÉRENCE ABSOLUE
Vous pouvez référencer un nom de répertoire dans le système de répertoire virtuel en utilisant une référence de répertoire absolue. La référence absolue de répertoire définit l’emplacement exact du répertoire dans la structure du répertoire virtuel, en commençant par la racine.
Une référence absolue à un répertoire commence toujours par une barre oblique (/), indiquant la racine du système de répertoire virtuel.
ofp@ubuntu:/$ cd /usr/bin
ofp@ubuntu:/usr/bin$
La commande pwd affiche l’emplacement du répertoire actuel de la session shell, appelé répertoire de travail actuel. Un exemple d’utilisation de la commande pwd est présenté ici :
ofp@ubuntu:~$ pwd
/home/ofp
ofp@ubuntu:~$ cd /etc
ofp@ubuntu:/etc$ pwd
/etc
RÉFÉRENCE RELATIVE
Les références de répertoire relatives vous permettent de spécifier une référence de répertoire de destination relative à votre emplacement actuel. Une référence de répertoire relative ne commence pas par une barre oblique (/). Au lieu de cela, une référence de répertoire relative commence par un nom de répertoire (si vous accédez à un répertoire sous votre répertoire actuel) ou un caractère spécial.
Les deux caractères spéciaux utilisés pour les références de répertoire relatives sont :
- Le seul point (.) pour représenter le répertoire actuel
- Le double point (..) pour représenter le répertoire parent
Le caractère à double point est extrêmement pratique lorsque vous essayez de traverser une hiérarchie de répertoires. Par exemple, si vous êtes dans le répertoire Documents sous votre répertoire personnel et que vous devez accéder à votre répertoire Downloads, également sous votre répertoire personnel, vous pouvez faire ceci :
ofp@ubuntu:~/Documents$ cd ../Downloads
ofp@ubuntu:~/Downloads$ pwd
/home/ofp/Downloads
Le caractère à double point vous ramène d’un niveau dans votre répertoire personnel, puis la la partie /Downloads de la commande vous ramène dans le répertoire Downloads. Vous pouvez utiliser autant de caractères à double point que nécessaire pour vous déplacer.